Python爬取网页的详细步骤与代码实例教程
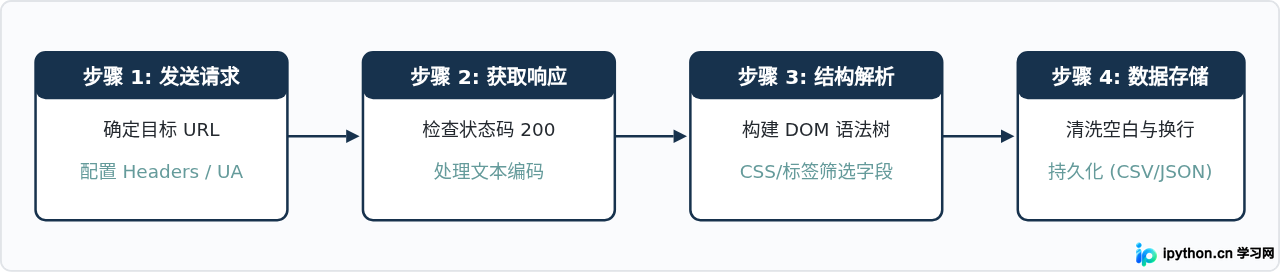
一份结构清晰、注重实操的Python爬取网页详细教程,涵盖环境搭建、HTTP请求发送、HTML解析、数据持久化存储与异常处理等完整步骤与代码实例。
10-15
39




一份结构清晰、注重实操的Python爬取网页详细教程,涵盖环境搭建、HTTP请求发送、HTML解析、数据持久化存储与异常处理等完整步骤与代码实例。
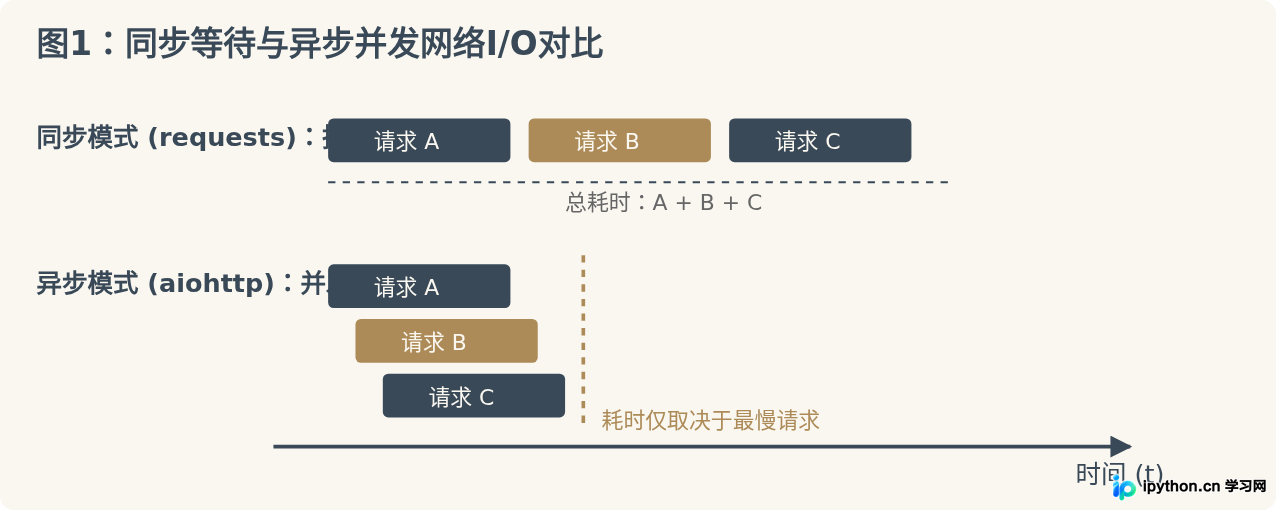
解决Python整站爬取速度慢的问题,详细讲解基于aiohttp的并发下载优化与基于Set/Redis/布隆过滤器的链接去重策略。
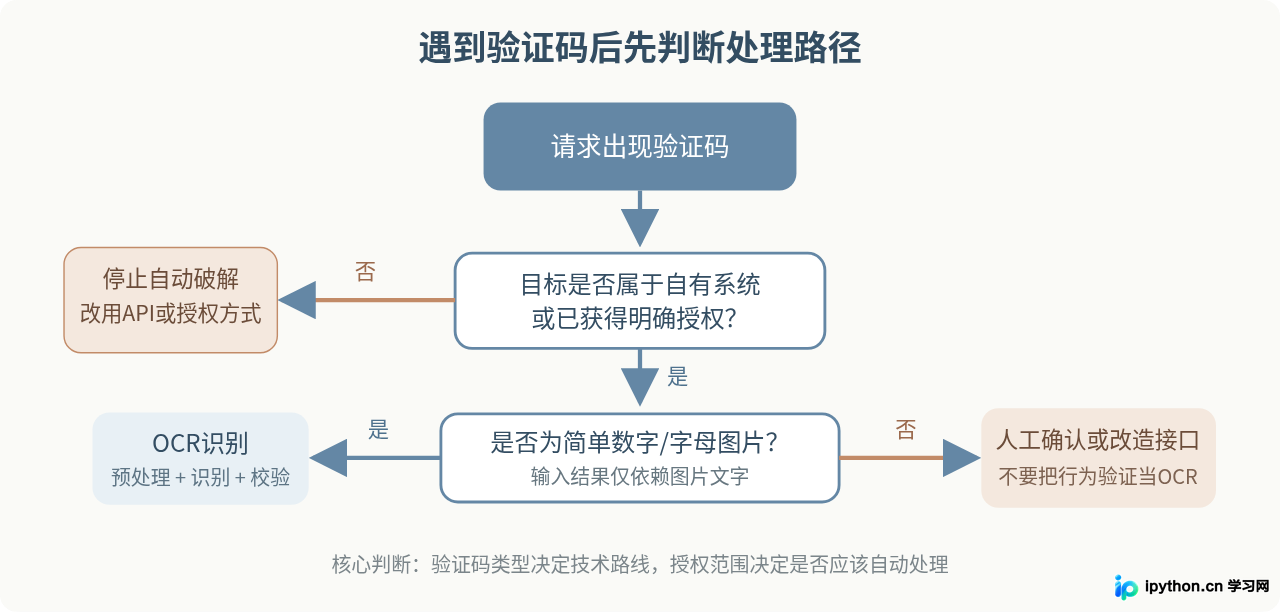
讲解Python爬虫遇到验证码时的处理思路,包括验证码类型判断、OCR识别、图像预处理、人工打码平台接口设计、失败重试和合规边界,并提供可运行的Python示例。
本文详细介绍如何利用Python爬虫技术获取天气通讯社的高温预警数据。通过分析目标网站反爬机制,结合亿牛云代理IP配置示例,帮助开发者有效规避访问限制,提前获取高温、暴雨等气象预警信息,做好防暑防灾准备。
本文介绍在Python爬虫中获取非唯一指定内容的方法。当XPath无法直接定位目标时,可通过遍历节点并结合条件判断进行筛选。文章提供基于urllib和lxml的完整代码示例,展示如何构建请求、解析HTML并过滤关键词,同时指出原代码存在冗余问题,旨在为开发者提供清晰的筛选逻辑参考。
本文介绍一种基于Python的自动化脚本,用于监控教务系统成绩更新。通过模拟登录获取加密数据,定时爬取成绩页面并将结果转化为列表进行比对。一旦发现新成绩,脚本立即通过邮件发送通知。该方案解决了教务系统无主动推送功能的痛点,支持将脚本部署在Ubuntu服务器上长期运行,确保用户及时获知成绩发布情况。
本文详解Python中urllib模块的核心用法,涵盖urlopen发起请求、Request设置User-Agent伪装、urlencode处理查询参数及quote编码等关键步骤。通过百度贴吧多页数据抓取的完整案例,演示如何构建爬虫类、拼接URL并保存HTML文件,帮助开发者掌握基础网络数据采集技能。
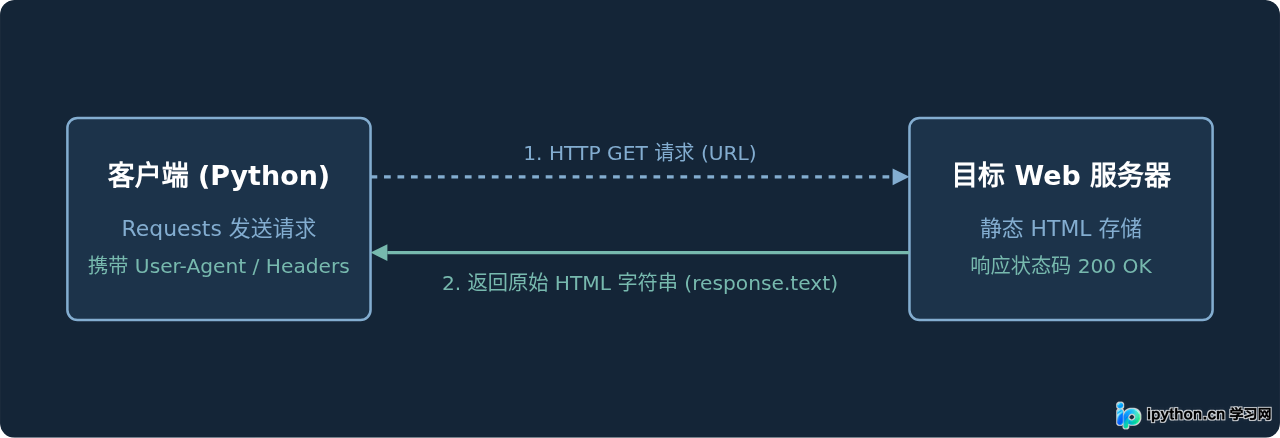
面向初学者的Python静态网页爬虫教程,系统讲解Requests网络请求与BeautifulSoup解析库的配合使用,包含环境安装、选择器提取、完整实战代码与常见问题排查。
本文详细介绍Python爬虫框架Newspaper的安装、基本用法及高级功能。通过单条新闻获取、缓存机制配置及多任务爬取等实例,展示其核心能力。同时指出该框架在中文环境下可能存在的识别BUG,并提供结合requests与bs4的替代建议,帮助开发者更高效地实现内容抓取。
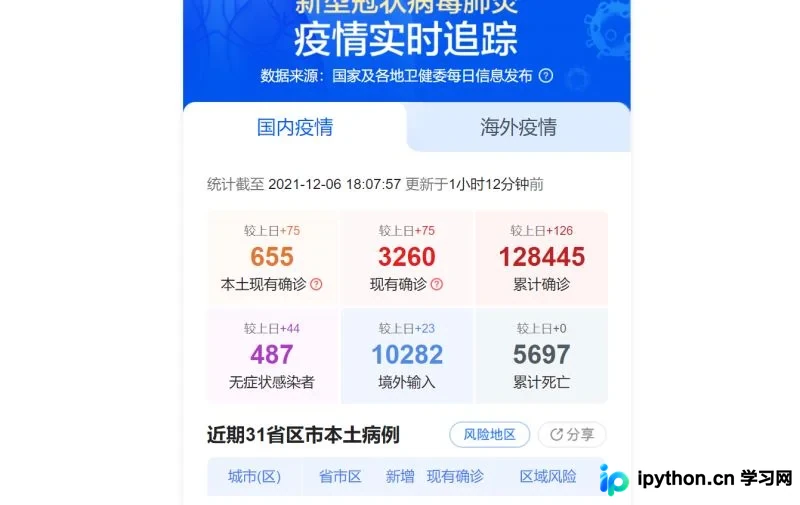
本文详细介绍如何使用Python进行疫情数据爬取与可视化。通过requests获取腾讯接口数据,利用pandas清洗保存,最后使用pyecharts绘制死亡率、治愈率及各地区确诊分布图表,完整展示从数据获取到可视化展示的全流程。
本文详细介绍 Python Selenium 中两种核心元素等待机制:显式等待与隐式等待。通过 WebDriverWait 类结合 expected_conditions 实现精准的元素状态检测,以及利用 implicitly_wait 设置全局超时轮询。文章包含完整代码示例与参数解析,帮助开发者解决页面加载不同步导致的定位失败问题,提升爬虫稳定性。
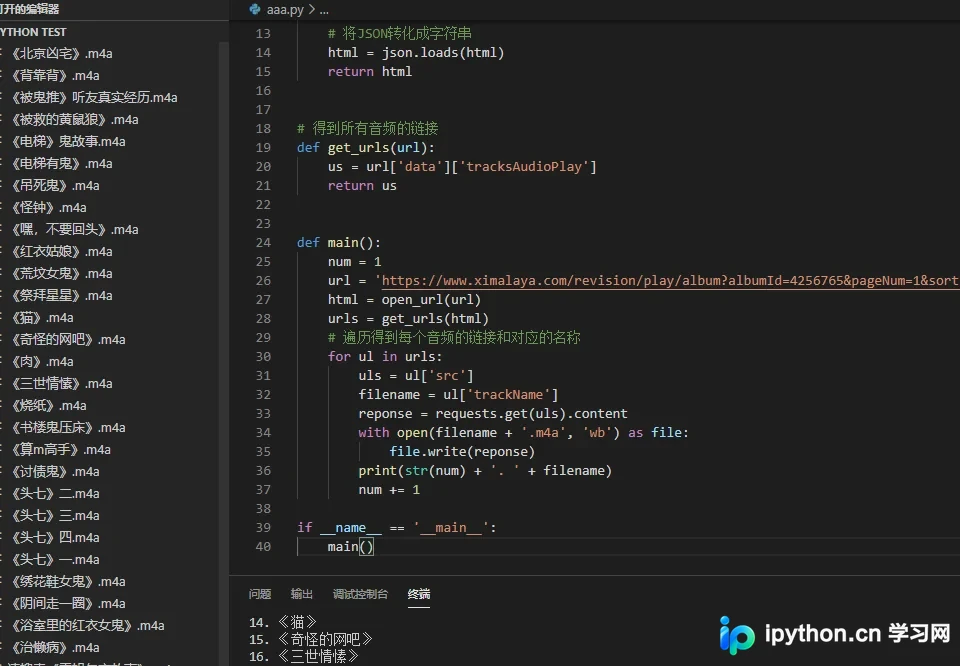
本文介绍如何使用Python编写脚本,从喜马拉雅网站抓取鬼故事专辑的音频文件。通过解析动态生成的JSON数据获取音频链接,并利用requests库实现批量下载保存为m4a格式。代码包含完整的请求头设置、URL解析及文件写入逻辑,适合初学者学习网络爬虫与文件处理。