Python常用标准库速查:os、sys、re模块手册用法详解
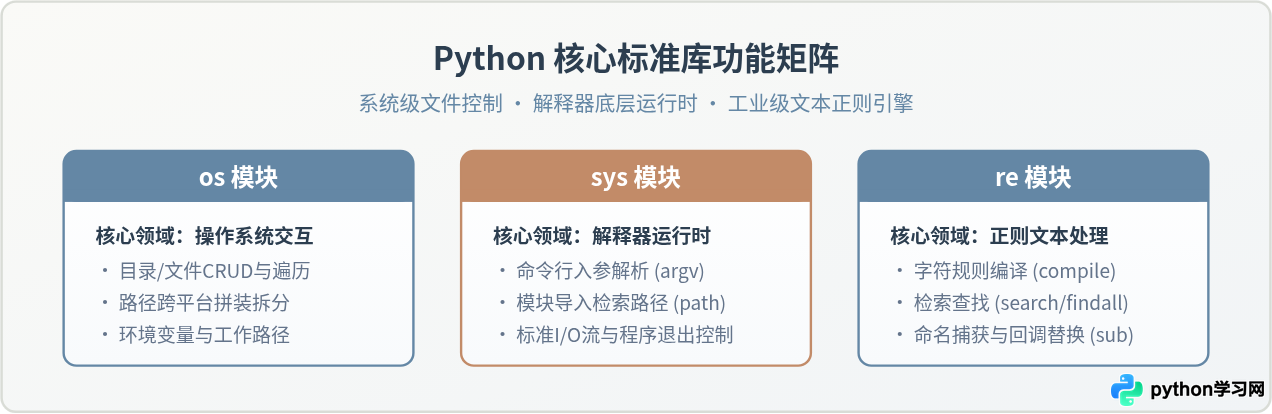
深入解析Python核心标准库os、sys与re模块的高频用法与手册规范,提供涵盖文件操作、环境交互、命令行参数与正则匹配的实用代码示例与全流程速查指南。



深入解析Python核心标准库os、sys与re模块的高频用法与手册规范,提供涵盖文件操作、环境交互、命令行参数与正则匹配的实用代码示例与全流程速查指南。
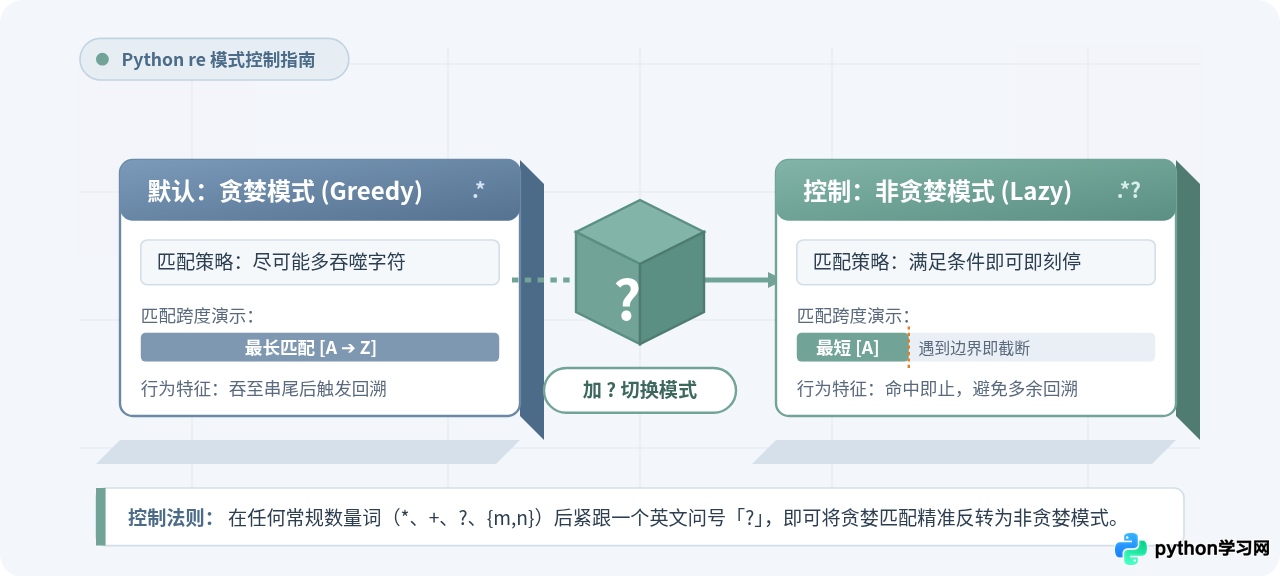
深入解析Python re模块中正则表达式贪婪与非贪婪模式的控制方法。通过量词后追加问号切换非贪婪、底层回溯原理剖析、常见数量词对照矩阵、实战场景代码与性能优化建议,帮助读者彻底掌握模式控制技巧。
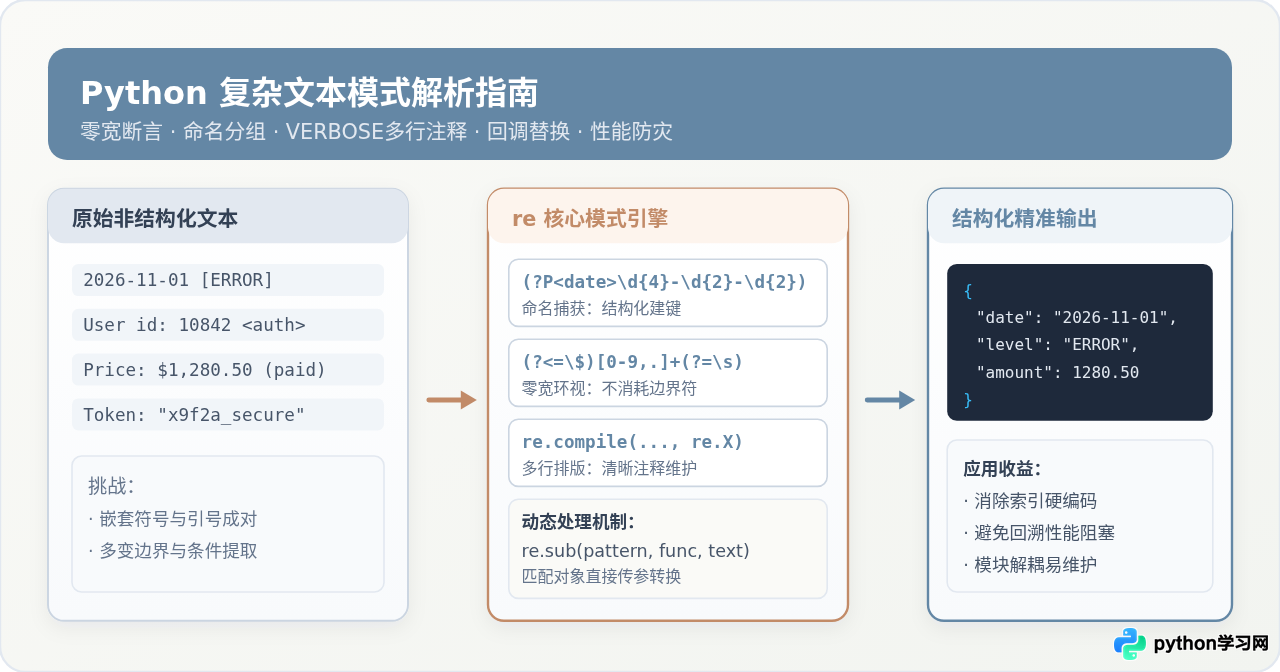
本文系统讲解怎么利用Python正则表达式处理复杂文本模式。通过命名分组、非捕获分组、零宽断言(环视)、re.VERBOSE多行模式以及re.sub动态回调函数等工程化方法,解决多层嵌套、不规则边界与非结构化日志等高难度文本处理难题,并提供规避灾难性回溯的性能保障指南。
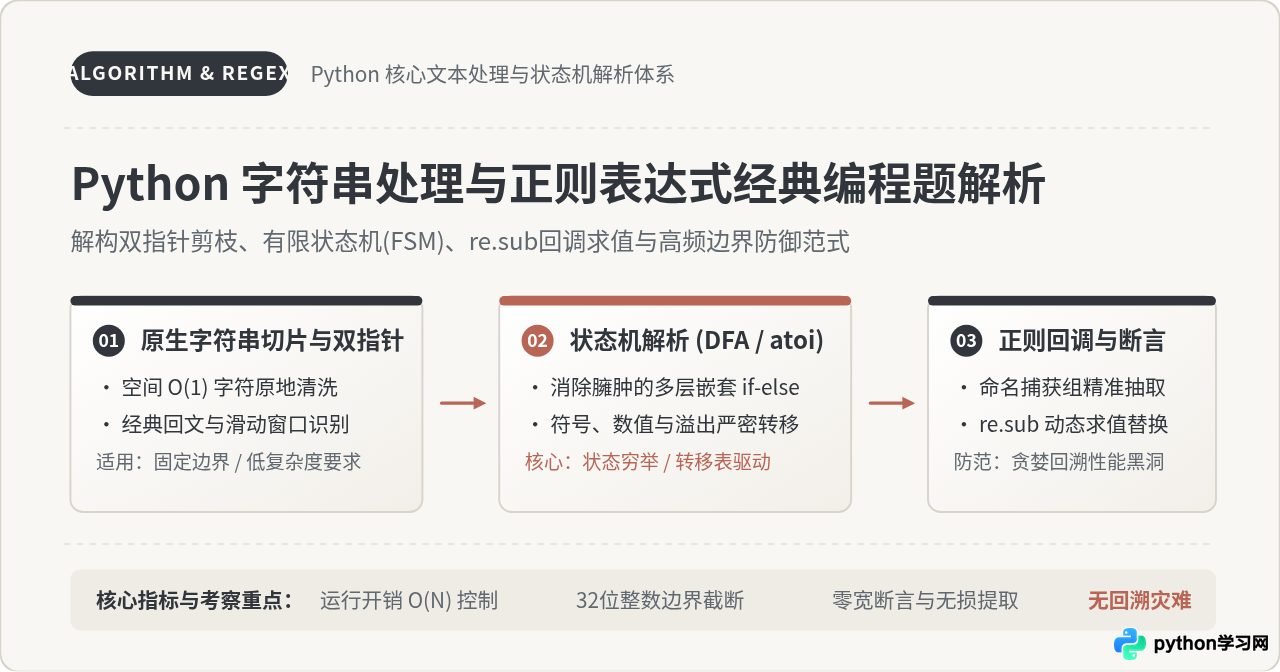
深入解析Python字符串处理与正则表达式经典编程题,涵盖双指针原地清洗、字符串转整数(atoi)状态机设计、re.sub动态模板替换、IP地址双轨验证与日志结构化提取,掌握算法复杂度与边界防御。
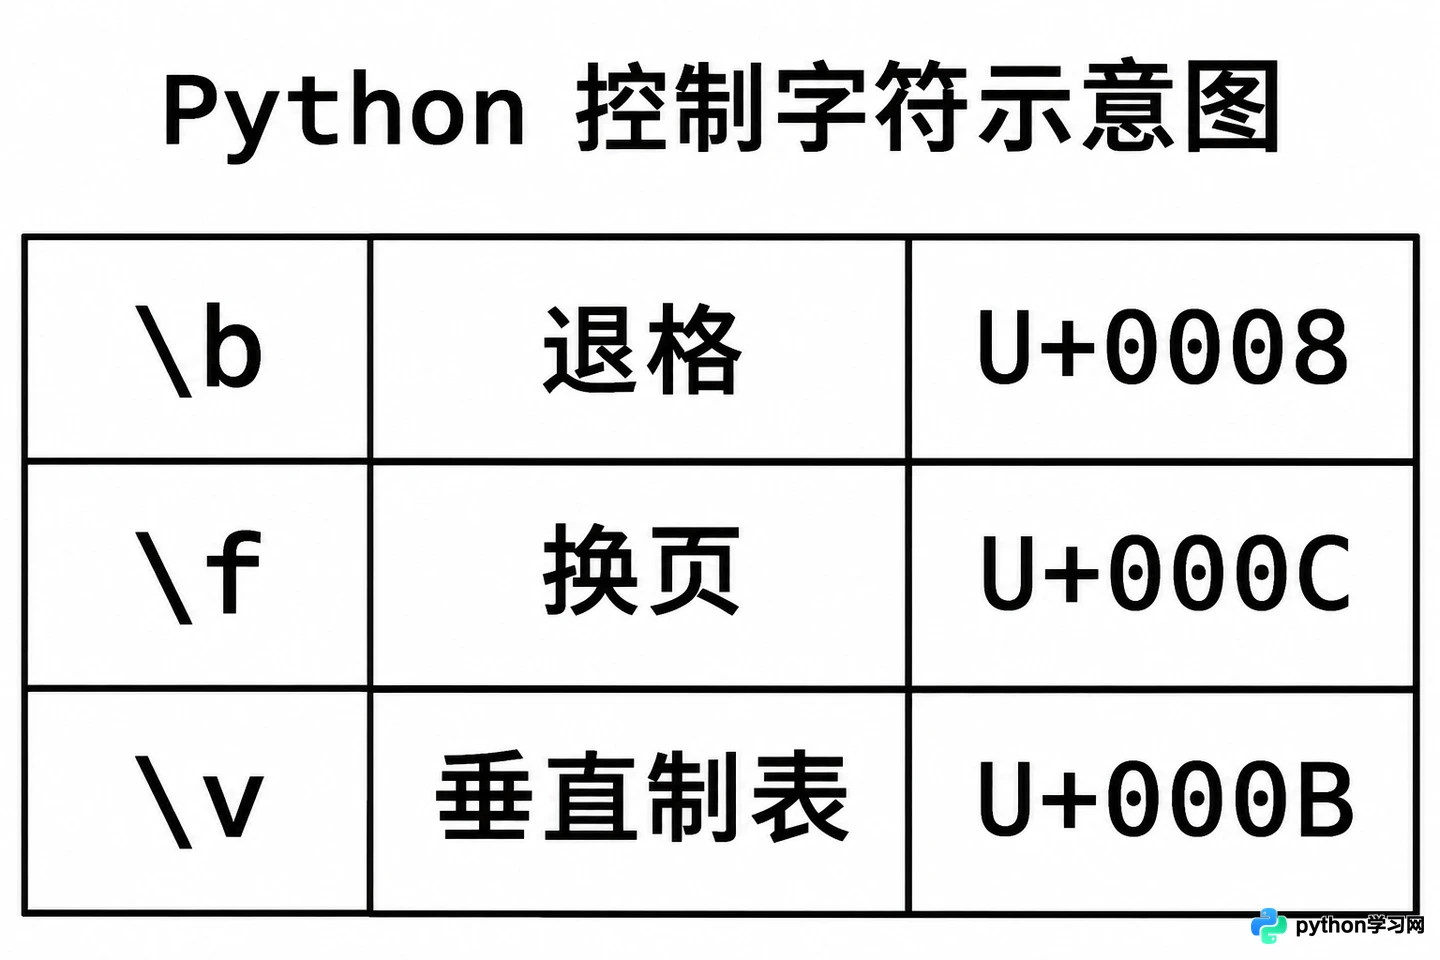
本文深入解析 Python 中较少使用的转义字符 \b(退格)、\f(换页)和 \v(垂直制表)。文章澄清了这些字符在字符串中的实际存储形式,区分了它们在正则表达式与终端输出中的不同语义,并提供了排查不可见字符及处理旧格式数据的实用技巧。
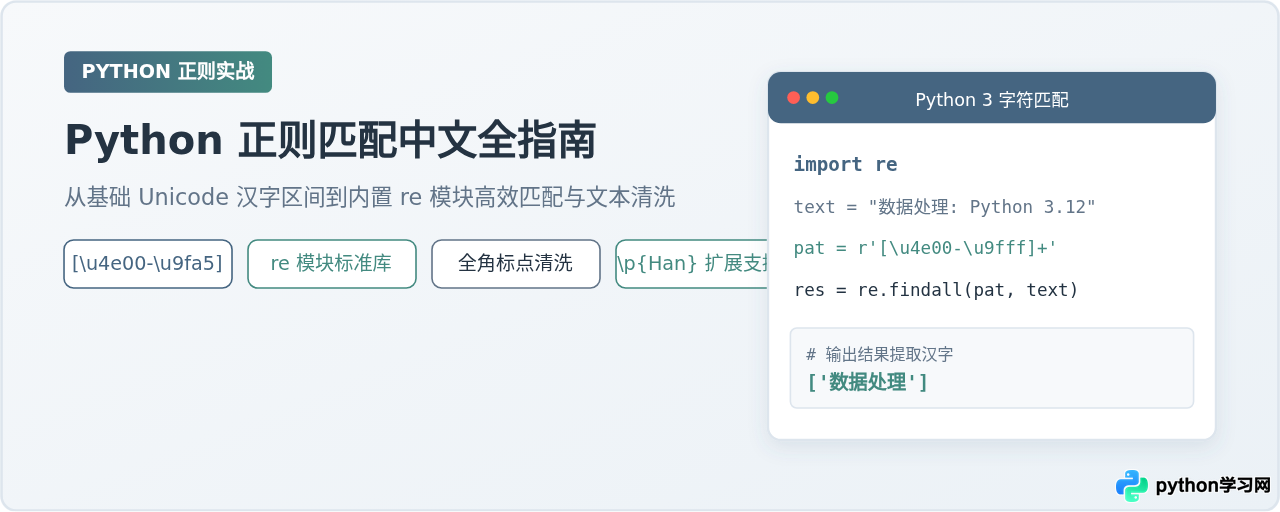
系统梳理Python中利用内置re模块匹配中文文本的实现方案,详解常用Unicode汉字区块与标点符号范围、经典正则模式、生僻字处理及常见应用场景。
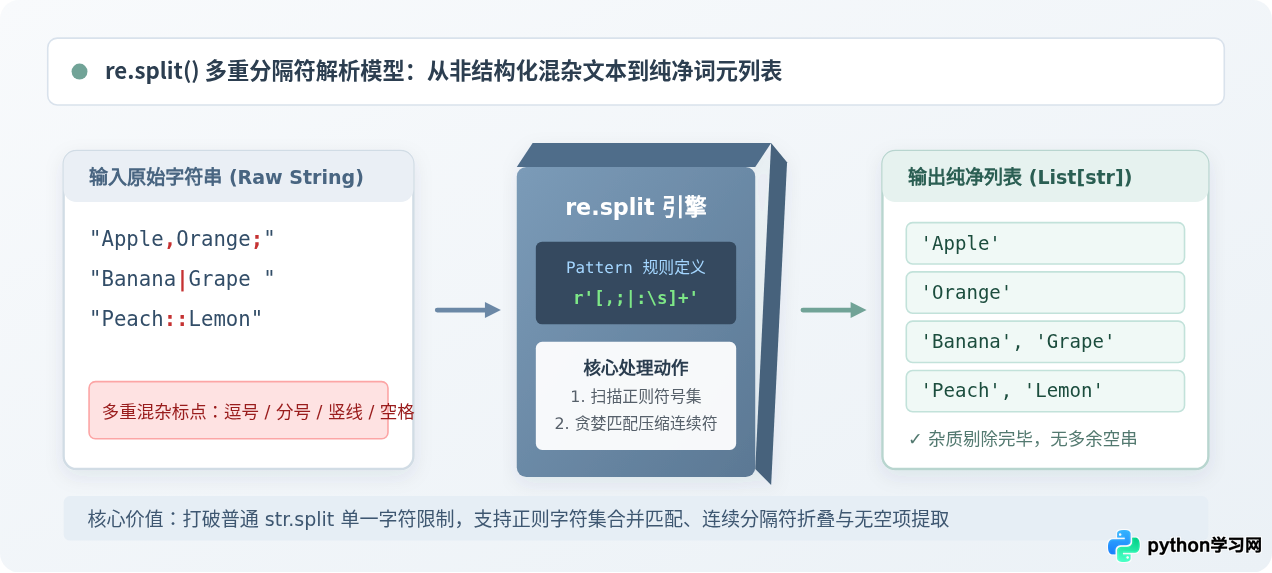
详细讲解在Python中使用re.split同时按多个分隔符切割字符串的实用方法,涵盖字符集方括号语法、多字符逻辑或、连续分隔符去重、捕获组与非捕获组的差异,以及空字符串与性能优化处理。
本文介绍了在Python中利用正则表达式匹配IP地址的方法。文章提供了具体的代码示例,解析了正则表达式的构成逻辑,包括对IP段数值范围(0-255)的处理及整体结构的匹配。同时补充了关于广播地址和保留地址的网络常识,旨在为相关开发工作提供实用的参考。
本文详细介绍如何使用Python的正则表达式(re模块)来匹配和提取IPv4及IPv6地址。内容涵盖简单与精确的IP验证方法,以及从长文本中高效提取IP地址的技巧,并提供完整的代码示例供参考。
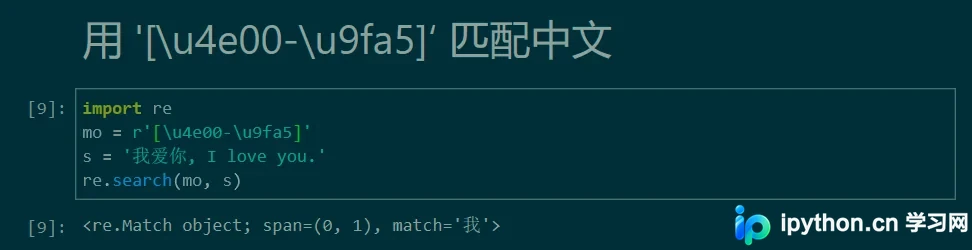
本文详细解析Python中正则表达式匹配中文的核心原理,重点讲解 `\u4e00-\u9fa5` 编码范围的使用。通过 re 模块的 `search` 和 `findall` 方法,演示如何精准提取单个中文字符、连续中文片段及所有中文内容。文章涵盖字符集范围说明及编码注意事项,帮助开发者解决跨语言文本处理中的匹配难题。
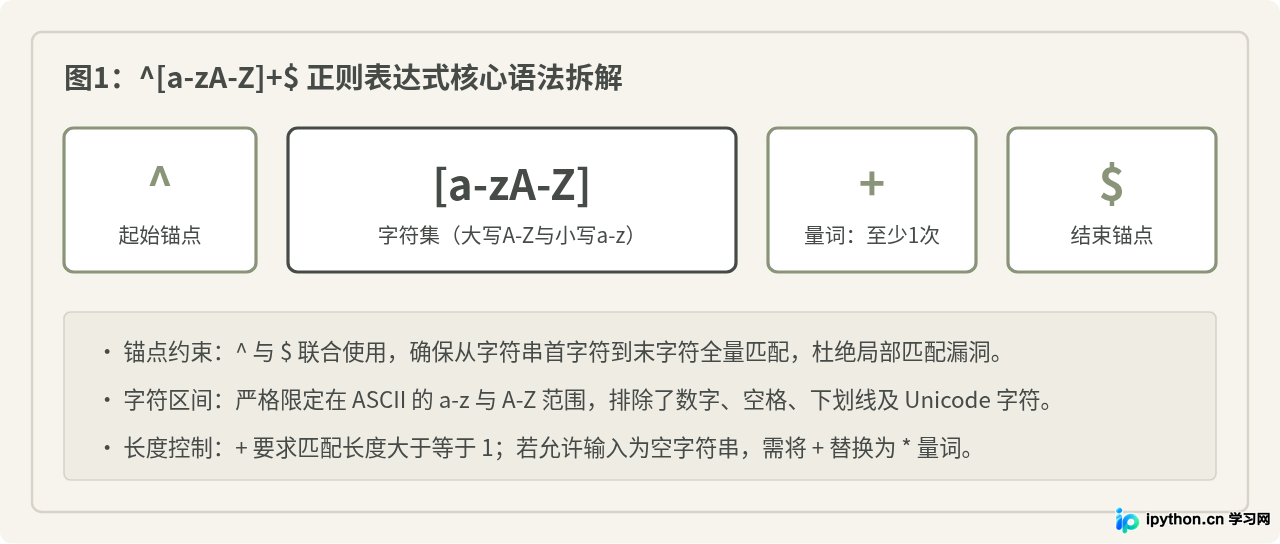
本文介绍在Python中使用正则表达式精确匹配纯字母输入的实现方法,深入剖析正则表达式语法结构、re模块核心函数应用流程及常见误区避坑指南。
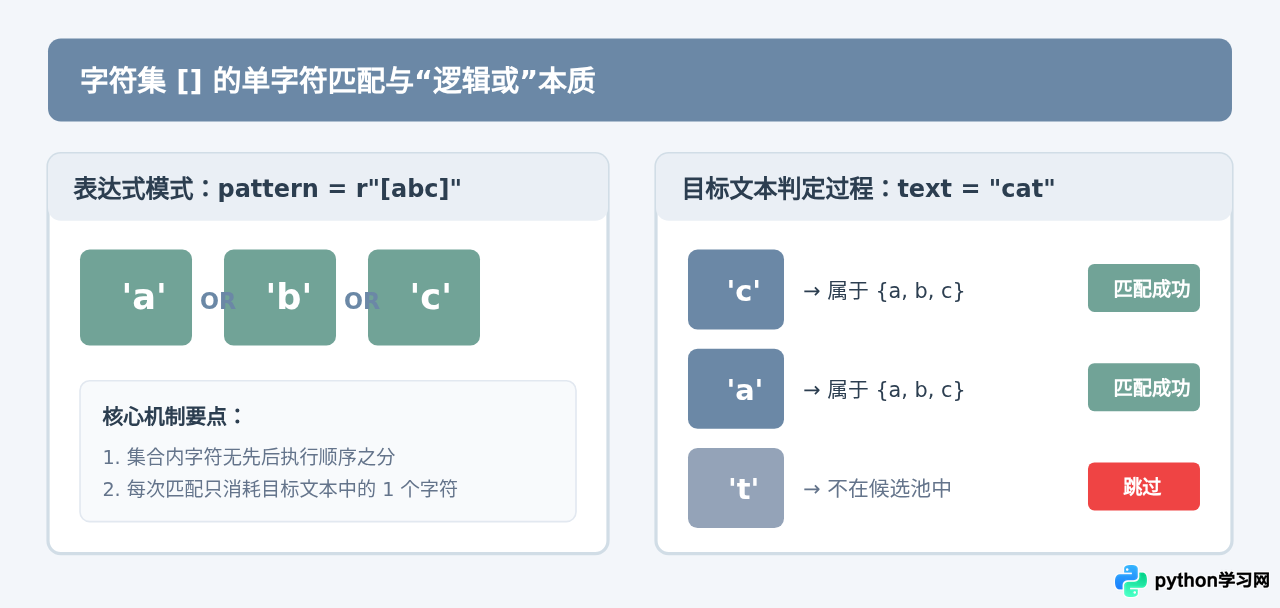
深入讲解Python正则表达式中字符集方括号[]与连字符范围匹配的核心规则,涵盖单字符离散匹配、ASCII编码范围、元字符自动脱敏、取反操作及常见避坑指南。