


怎么利用Python正则表达式处理复杂文本模式
本文系统讲解怎么利用Python正则表达式处理复杂文本模式。通过命名分组、非捕获分组、零宽断言(环视)、re.VERBOSE多行模式以及re.sub动态回调函数等工程化方法,解决多层嵌套、不规则边界与非结构化日志等高难度文本处理难题,并提供规避灾难性回溯的性能保障指南。
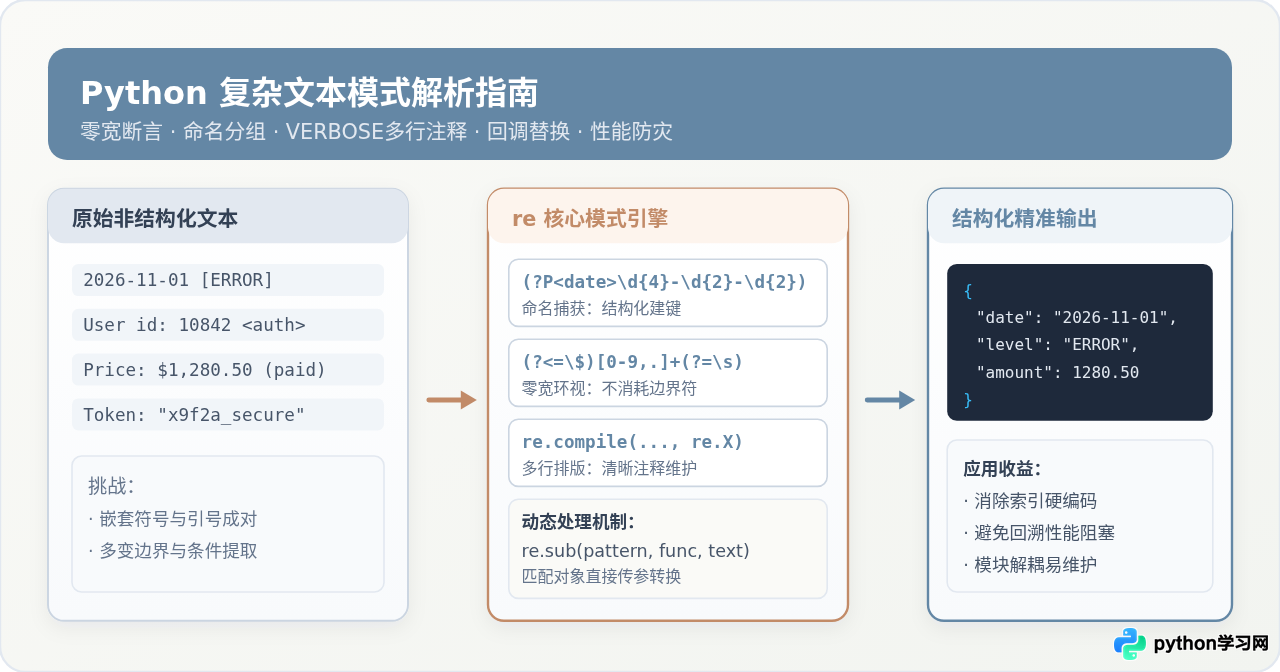
处理复杂文本模式的核心做法,是放弃试图用一行连续字符“硬匹配所有内容”的粗暴思路,转而依托 Python re 模块提供的五项工程化能力:利用命名捕获分组将无序文本转为语义字典,使用非捕获分组隔离干扰,借助零宽断言(环视)在不吞噬字符的前提下精确定位边界,开启 re.VERBOSE 编写具备自解释注释的多行正则,以及通过 re.sub 的回调函数机制完成动态复杂变换。只要按照这套组合方法,即便是多变格式的混合日志、成对嵌套符号或伴随复杂校验规则的非结构化字符串,也能稳定且高效地解析。
一、复杂文本处理的工程化解析流程
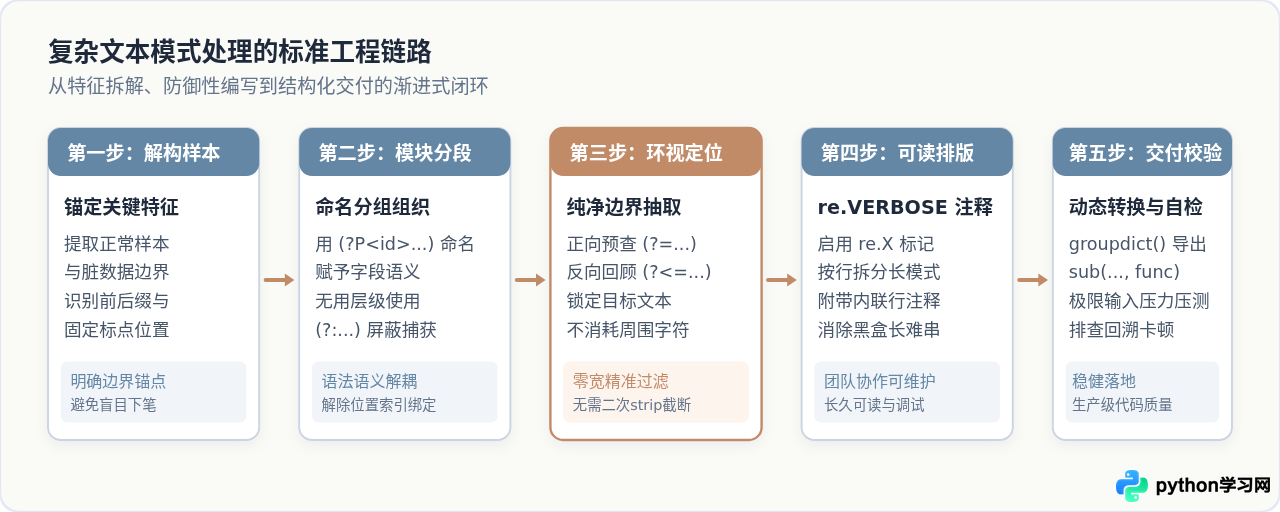
面对混合了特殊标点、无规律空格、嵌套引号或变长字段的复杂文本时,直接尝试写出最终正则表达式往往会导致逻辑混乱,甚至造成回溯死循环。标准而清晰的操作步骤应当是自外向内、由粗到细的五步推进法:
- 采样并识别锚点:收集具有代表性的正常样例与极端畸形数据,找出模式中永远不变的锚定字符(如特定的前缀协议头、方括号日期标记或换行符)。
- 划分命名捕获区域:对业务需要提取的每一个字段使用
(?P<name>...)分配语义名称,对仅用于逻辑聚合的片段采用(?:...)隔离。 - 引入零宽断言锁定纯净内容:当目标文本周围有定界符(如
<tag>、引号、金额前缀$)且提取结果不希望包含定界符本身时,利用前瞻与后顾断言剔除冗余。 - 多行格式化排版:使用
re.compile(pattern, re.VERBOSE)将原本密密麻麻的一整行表达式拆解为按行分段并添加行内中文注释的代码块。 - 动态交付与回溯自检:通过
match.groupdict()获取结构化数据,或配合自定义回调函数完成数值校验与格式重构,并使用极端长字符串检查耗时。
二、结构化拆解:命名分组与非捕获分组
当正则表达式中包含四个以上的括号时,依靠 m.group(1) 或 m.group(3) 等数字索引获取字段极易出错。一旦需求变更在表达式前方增加了一个辅助括号,所有后续索引都会发生位移。因此,处理复杂模式的第一项基本功是显式命名分组与非捕获分组。
1. 命名分组提取为字典
命名分组的语法为 (?P<name>pattern)。匹配成功后,直接调用 match.groupdict() 即可返回以键名组织的字典对象,与后续的数据处理逻辑完全解耦。
import re

# 待处理的混合日志文本(包含时间、日志级别、客户端IP以及带双引号的请求动作)
log_line = '2026-11-01 03:15:22 [ERROR] client: 192.168.1.108 - "POST /api/v2/pay HTTP/1.1" code: 500'

# 使用命名分组构建模式
pattern = re.compile(
    r'(?P<timestamp>\d{4}-\d{2}-\d{2}\s\d{2}:\d{2}:\d{2})\s'
    r'\[(?P<level>[A-Z]+)\]\s'
    r'client:\s(?P<ip>\d{1,3}(?:\.\d{1,3}){3})\s-\s'
    r'"(?P<method>[A-Z]+)\s(?P<path>[^\s]+)\s(?P<proto>[^"]+)"\scode:\s'
    r'(?P<status_code>\d{3})'
)

match = pattern.search(log_line)
if match:
    data = match.groupdict()
    print("提取结果字典:", data)
    print("单独提取IP:", match.group("ip"))
提取结果字典: {'timestamp': '2026-11-01 03:15:22', 'level': 'ERROR', 'ip': '192.168.1.108', 'method': 'POST', 'path': '/api/v2/pay', 'proto': 'HTTP/1.1', 'status_code': '500'}
单独提取IP: 192.168.1.108
2. 利用反向引用处理成对引号
在解析配置文件或富文本时,字符串可能被单引号或双引号包裹,但首尾引号必须严格匹配。使用 (?P=name) 可以在后续模式中动态引用前面同名分组所捕获的具体字符:
import re

text_sample = 'title = "Python正则教程" and subtitle = '复杂模式解析''

# (?P<quote>['"]) 匹配开头的单或双引号;(?P=quote) 确保闭合引号与开头完全一致
quote_pattern = re.compile(r'(?P<quote>['"])(?P<content>.*?)(?P=quote)')

for m in quote_pattern.finditer(text_sample):
    print(f"匹配到闭合块(使用{m.group('quote')}引号): {m.group('content')}")
匹配到闭合块(使用"引号): Python正则教程
匹配到闭合块(使用'引号): 复杂模式解析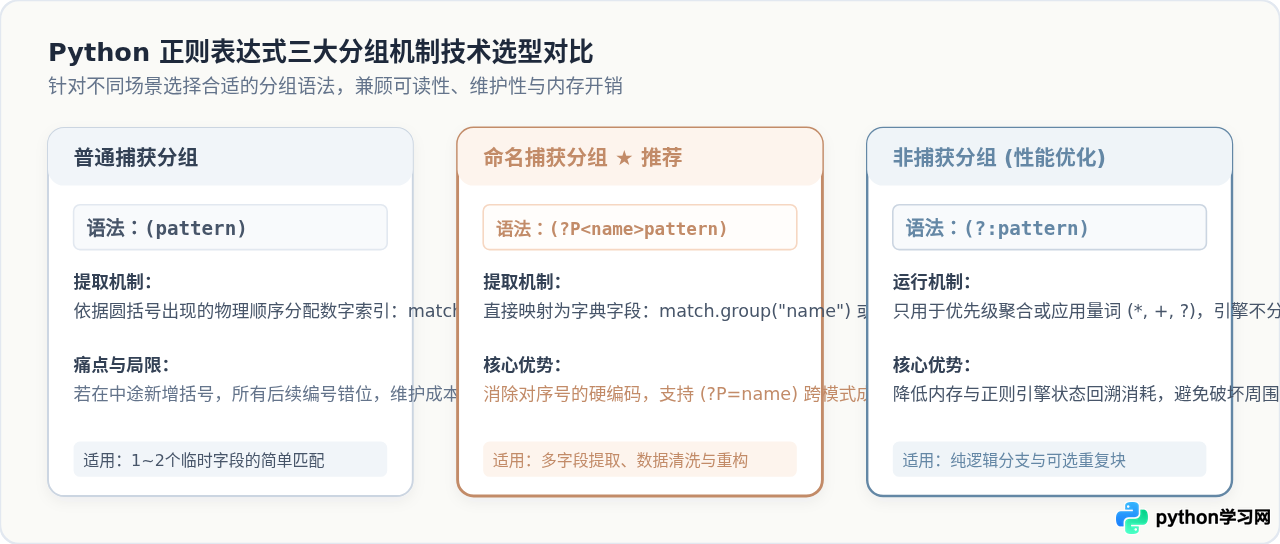
三、精准定位:零宽断言(Lookaround)的高级用法
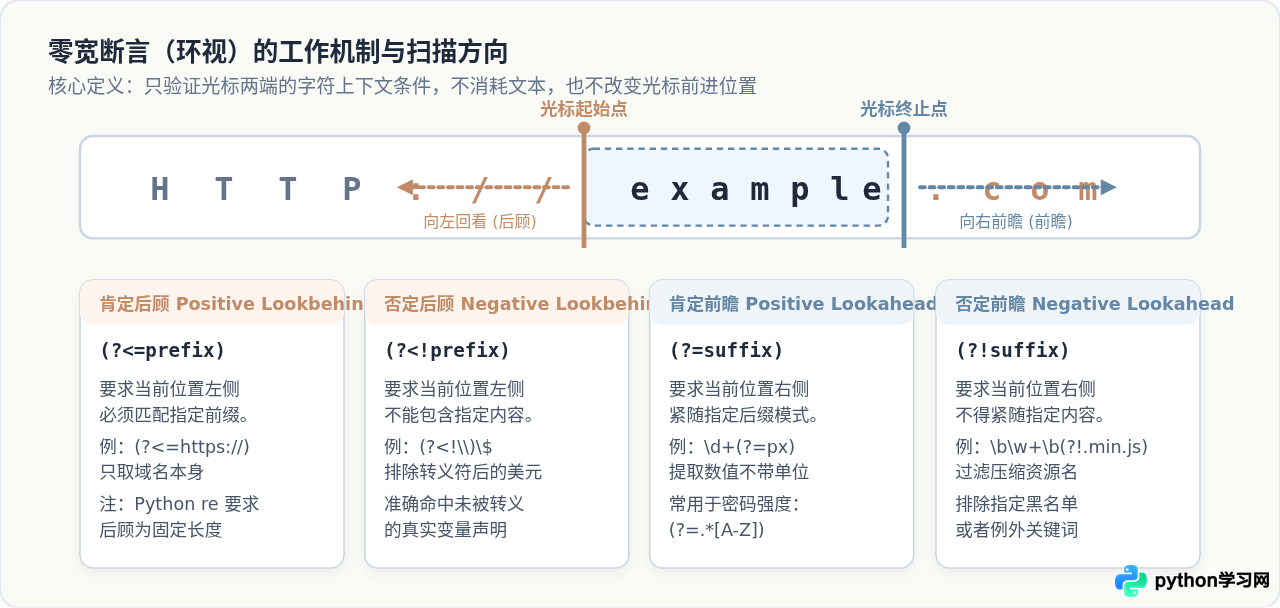
当我们需要提取特定内容,但又不希望将周围的标识符或限定符包含在最终结果中时,零宽断言是唯一能够保持正则语义纯净的方法。所谓“零宽”,指的是该断言只对光标前后的文本是否符合某种模式做出真假判断,而不消耗任何字符,匹配成功时光标仍然停留在原地。
1. 肯定与否定前瞻(Lookahead)
前瞻断言从当前光标位置向右(后方文本)窥探:
(?=pattern):肯定前瞻,确保当前位置之后紧跟pattern。例如匹配 CSS 尺寸数值而不带单位:\d+(?=px)。(?!pattern):否定前瞻,确保当前位置之后不紧跟pattern。常用于黑名单过滤或多重无序校验。
import re

# 场景:要求密码至少8位,同时必须包含至少1个大写字母、1个小写字母和1个数字,且无序分布
password_validator = re.compile(
    r'^(?=.*[a-z])(?=.*[A-Z])(?=.*\d)[A-Za-z\d@$!%*?&]{8,}$'
)

passwords = ["Admin123!", "simplepwd", "NO_DIGITS_HERE", "SafePass2026"]
for pwd in passwords:
    valid = bool(password_validator.match(pwd))
    print(f"密码 '{pwd}' 校验结果: {'通过' if valid else '不符合规则'}")
密码 'Admin123!' 校验结果: 通过
密码 'simplepwd' 校验结果: 不符合规则
密码 'NO_DIGITS_HERE' 校验结果: 不符合规则
密码 'SafePass2026' 校验结果: 通过
2. 肯定与否定后顾(Lookbehind)
后顾断言从当前光标位置向左(前方已扫描文本)回看:
(?<=pattern):肯定后顾,确保当前位置左侧刚刚出现了pattern。(?<!pattern):否定后顾,确保当前位置左侧没有出现pattern。
re 模块对后顾断言有定长限制。在 (?<=...) 内部不能直接使用 *、+ 或 {1,4} 这类变长量词。若必须匹配可变前缀,应拆分为多个固定长度的备选分支 (?:(?<=a)|(?<=abc))。
import re

raw_statement = "结算金额: USD $1,250.00, 折扣率: 15%, 罚金: USD $45.50"

# 仅提取带美元符号的实际金额数值,不需要提取前缀 $ 或空格
# 前置条件:必须以 $ 开头;后置条件:紧邻空格或逗号
money_pattern = re.compile(r'(?<=\$)[0-9,.]+(?=[,\s]|$)')

amounts = money_pattern.findall(raw_statement)
print("提取到的纯金额列表:", amounts)
提取到的纯金额列表: ['1,250.00', '45.50']四、可维护性与动态变换:re.VERBOSE 与回调函数替换
复杂文本模式通常伴随着极长的正则语句,直接书写为一行字符串几乎无法阅读与复核。利用 Python 的 re.VERBOSE 编译标记与 re.sub 的函数回调特性,可以将原本隐晦的字符匹配升级为逻辑分明的工程代码。
1. 编写自解释的多行正则表达式
传入 re.VERBOSE(或简写 re.X)后,正则引擎将忽略模式中所有未转义的空白符与换行符,并允许在每一行之后使用 # 书写中文注释:
import re

# ISO 8601 复杂时间戳模式(含毫秒及可能存在的时区偏移量)
iso_timestamp_pattern = re.compile(r"""
    ^                                   # 匹配文本行首
    (?P<year>\d{4})-(?P<month>\d{2})-(?P<day>\d{2}) # 年-月-日
    [T\s]                               # 日期与时间之间的定界符 (T 或 空格)
    (?P<hour>\d{2}):(?P<minute>\d{2}):(?P<second>\d{2}) # 时:分:秒
    (?:\.(?P<microsecond>\d+))?         # 可选的毫秒/微秒部分 (非捕获外层)
    (?P<tz>Z|[+-]\d{2}:\d{2})?       # 可选时区: Z 或 +/-HH:MM
    $                                   # 匹配行尾
""", re.VERBOSE)

sample_time = "2026-11-01T03:20:45.8912+08:00"
m = iso_timestamp_pattern.match(sample_time)
if m:
    print("时间结构化字段:", m.groupdict())
时间结构化字段: {'year': '2026', 'month': '11', 'day': '01', 'hour': '03', 'minute': '20', 'second': '45', 'microsecond': '8912', 'tz': '+08:00'}2. 利用 re.sub 传递回调函数进行动态清洗
很多复杂文本处理任务不仅要“找到”模式,还要对匹配到的内容进行“加工替换”(如掩码脱敏、日期格式转换、进制折算)。直接使用静态替换字符串无法满足条件分支判断,此时应将一个可调用函数(Callable)作为 repl 参数传入 re.sub()。该函数会自动接收每一个 Match 对象,并返回处理后的替换字符串。
import re

document = """
用户订单数据:
- 客户 张三: 身份证 110101199003072345, 支付金额 $150.00
- 客户 李四: 身份证 32010219851215123X, 支付金额 $2800.50
"""

def dynamic_processor(match):
    """
    接收正则匹配对象,动态执行脱敏与汇率折算
    """
    id_card = match.group("id_card")
    usd_val = float(match.group("usd").replace(",", ""))

    # 身份证保留前6位与后4位,中间隐藏
    masked_id = id_card[:6] + "********" + id_card[-4:]
    # 美元按 7.2 汇率动态计算人民币值
    cny_val = round(usd_val * 7.2, 2)

    return f"身份证 {masked_id}, 折算价值 ¥{cny_val:,.2f} (原 ${usd_val:,.2f})"

# 匹配身份证与金额组合模式
composite_pattern = re.compile(
    r'身份证\s(?P<id_card>\d{17}[\dXx]),\s支付金额\s\$(?P<usd>[0-9,.]+)'
)

processed_doc = composite_pattern.sub(dynamic_processor, document)
print(processed_doc.strip())
用户订单数据:
- 客户 张三: 身份证 110101********2345, 折算价值 ¥1,080.00 (原 $150.00)
- 客户 李四: 身份证 320102********123X, 折算价值 ¥20,163.60 (原 $2,800.50)
五、规避性能陷阱:灾难性回溯的成因与防治
在处理超长文本或畸形输入时,不合理的正则表达式会导致 Python 进程 CPU 占用飙升至 100% 并陷入长时间假死,这种现象被称为灾难性回溯(Catastrophic Backtracking)。
1. 陷阱成因:嵌套量词与模糊匹配
当多个贪婪量词发生嵌套时(例如 (a+)+$ 或 (.*a)+b),若输入文本以长串 a 结尾但缺少必须的 b,正则引擎为了验证每一个可能的分支,会以指数级复杂度 \(O(2^n)\) 尝试所有可能的切分组合。一个几十个字符的不匹配串,就能使引擎尝试数十亿次回溯。
2. 防御方案:使用具体排他型字符类替代模糊通配
绝大多数由于 .*? 或 .* 引发的性能故障,都可以通过精确界定排除字符来彻底解决:
- 错误范式:使用
"([^"]*)"或".*?"匹配双引号内容。当文本中出现未闭合的单双引号时,非贪婪模式会跨行无限制回溯。 - 正确范式:显式排除定界符与换行符,写为
"([^"
]*)"
。引擎在遇到非法字符时会立即判定失败并退出当前分支,绝不产生多余状态堆叠。
六、工程实践检查清单与总结
在实际 Python 工程中编写复杂文本解析模块时,可以通过以下技术矩阵快速对照检查,确保代码兼具健壮性、可读性与执行效率:
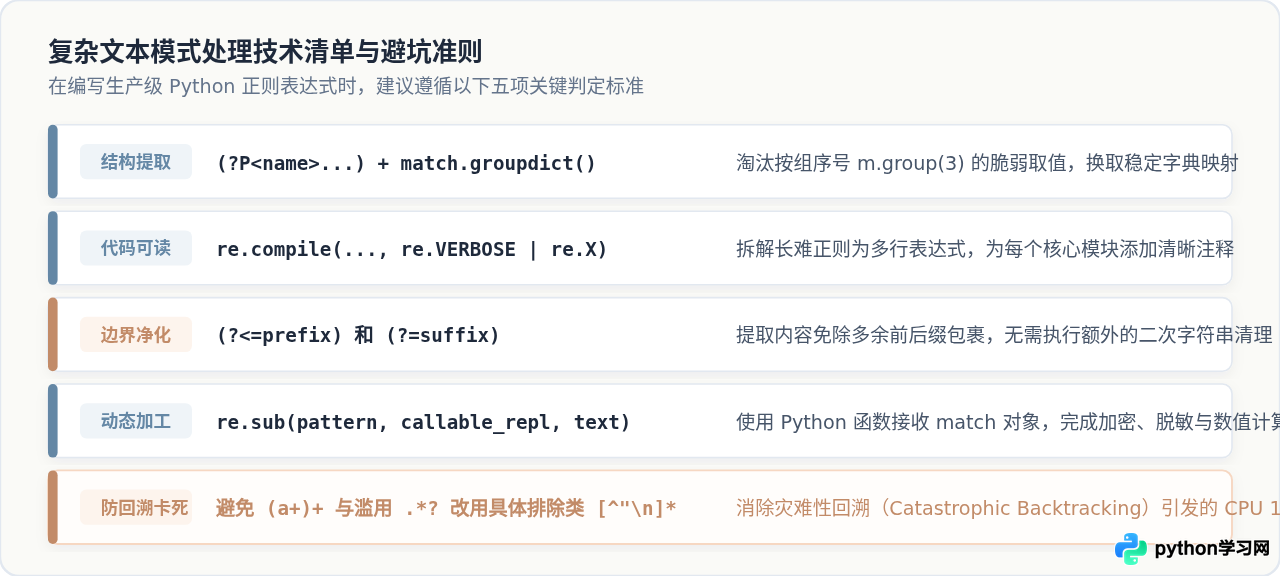
掌握 Python 处理复杂文本模式的本质,在于理解正则引擎的状态转移规律:能用结构化命名分组就不留数字序号,能用零宽断言消除定界符就少写后置切割,长模式必须使用 re.VERBOSE 附带注释,复杂替换交由回调函数统一加工,并时刻用具体字符类防御灾难性回溯。遵循这一套方法,即可在生产环境中写出兼具高解析精度与长久可维护性的文本处理管道。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















