


Python字符串处理与正则表达式经典编程题解析
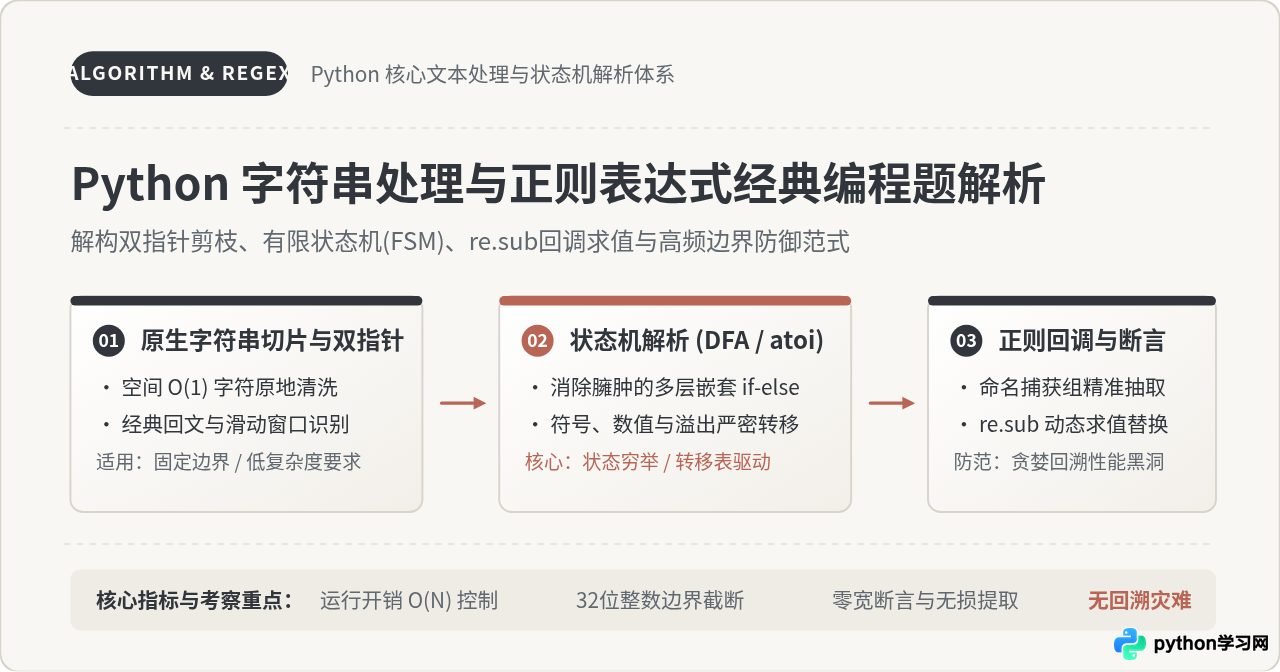
深入解析Python字符串处理与正则表达式经典编程题,涵盖双指针原地清洗、字符串转整数(atoi)状态机设计、re.sub动态模板替换、IP地址双轨验证与日志结构化提取,掌握算法复杂度与边界防御。
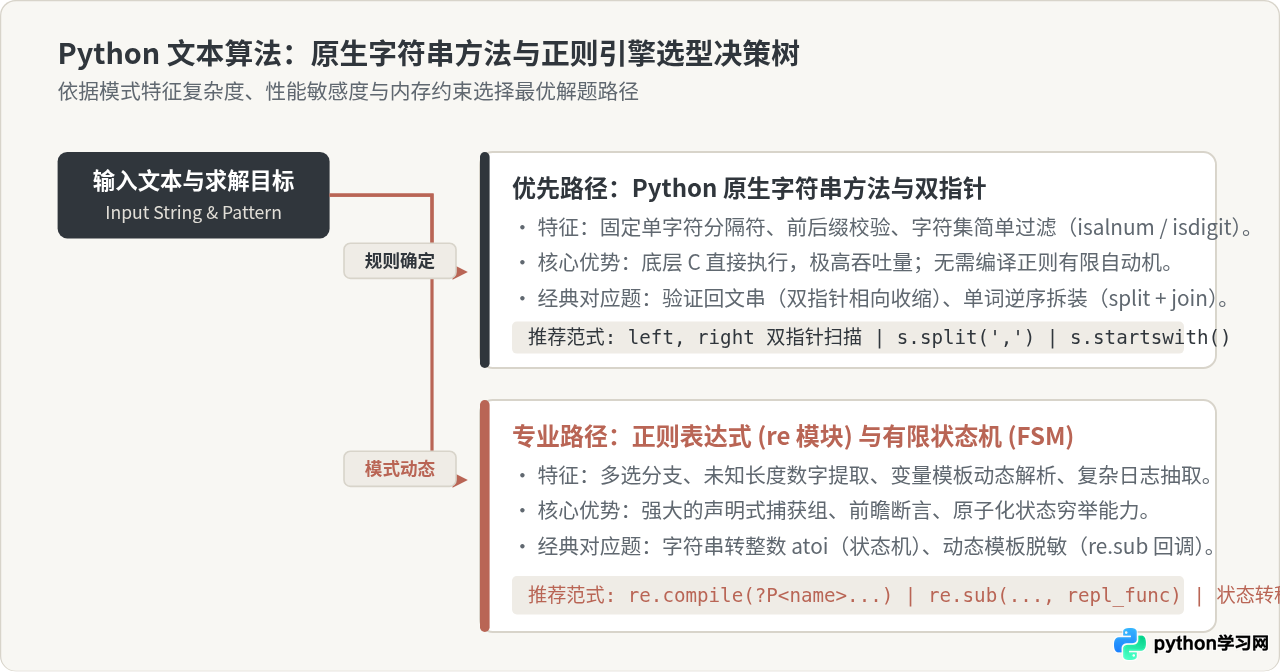
一、核心选型边界:原生方法与正则引擎的权衡法则
在解决字符串类编程题时,初学者常陷入两个极端:要么试图用大量脆弱且易漏分支的 str.split()、str.find() 与多重 if-else 去硬啃复杂的模糊模式,要么无论题目多么简单都盲目套用正则表达式,导致不必要的引擎编译与回溯性能损耗。
Python 的字符串是不可变序列(Immutable Sequence),所有对字符串的切片、替换和拼接在没有内部优化的情况下都会生成新的字符串对象。了解两者的性能特征和适用场景是高效解题的前提:
- Python 原生字符串操作(快速通道):诸如
startswith()、endswith()、isalnum()、split()、join()等均由 C 语言底层实现。当匹配规则固定(如单字符或固定关键词)、分隔符单一且无需模式归纳时,原生方法的执行速度通常是正则引擎的 3 到 8 倍,且空间占用确定。 - 正则表达式引擎(模糊模式与结构捕获):基于非确定性有限自动机(NFA)实现。适用于包含通配符、字符集合、可变重复次数、命名捕获组及前瞻断言(Lookaround)等复杂场景。
二、经典题一:验证回文串与字符规范化清洗
1. 问题描述与限制条件
给定一个字符串,验证其在忽略字母大小写、且仅考虑字母和数字字符的前提下,是否为回文串。例如输入 "A man, a plan, a canal: Panama" 返回 True;输入 "race a car" 返回 False。
2. 解题思路:双指针原地收缩 vs 正则预清洗
许多初学者的第一反应是用正则 re.sub(r'[^a-zA-Z0-9]', '', s).lower() 将字符串整体洗净,再通过 cleaned == cleaned[::-1] 反转切片进行比较。这种写法代码虽短,但存在两处明显的内存与时间浪费:
re.sub会分配新的堆内存容纳整串字符;cleaned[::-1]再次分配一份完全相反的字符串拷贝,空间复杂度上升至 O(N)。
最优解是相向双指针法:左右指针分别指向字符串头尾,在移动过程中跳过非字母数字字符,遇到有效字符时比对其统一小写后的字符。一旦不匹配立即返回 False,无需任何辅助字符串拷贝,空间复杂度降为严格的 O(1)。
3. 代码实现与执行示例
def is_palindrome(s: str) -> bool:
    left, right = 0, len(s) - 1

    while left < right:
        # 左指针跳过非数字字母字符
        while left < right and not s[left].isalnum():
            left += 1
        # 右指针跳过非数字字母字符
        while left < right and not s[right].isalnum():
            right -= 1

        # 统一转小写后对比
        if s[left].lower() != s[right].lower():
            return False

        left += 1
        right -= 1

    return True

# 示例调用
if __name__ == "__main__":
    test_cases = [
        "A man, a plan, a canal: Panama",
        "race a car",
        "0P",
        " "
    ]
    for text in test_cases:
        res = is_palindrome(text)
        print(f"输入: {text!r:<35} => 判定结果: {res}")
输入: 'race a car' => 判定结果: False
输入: '0P' => 判定结果: False
输入: ' ' => 判定结果: True
left 和 right 时,必须时刻附带 left < right 条件限制,否则当遇到纯符号字符串(如 ".,:;")时,内层循环会发生指针越界异常。
三、经典题二:字符串转换整数 (String to Integer / atoi)
1. 问题描述与工程边界
实现类似 C/C++ 中的 atoi 函数:
- 丢弃前导空格;
- 检查下一个字符是否为符号
'+'或'-'(未指定则默认为正); - 连续读取后续的数字字符,直到遇到非数字字符或到达末尾;
- 将读取的数字转换为 32 位有符号整数,超出范围
[-2^31, 2^31 - 1]时必须截断(Clamp)至边界值-2147483648或2147483647; - 若未读取到有效数字,返回 0。
2. 解法对比:有限状态机 (FSM) 的工程化优势
如果使用分散的 if-elif-else 语句处理该题,面对 " -42"、"+-12"、"00000-42a1234" 等脏数据时,条件很容易产生相互重叠或覆盖死角。
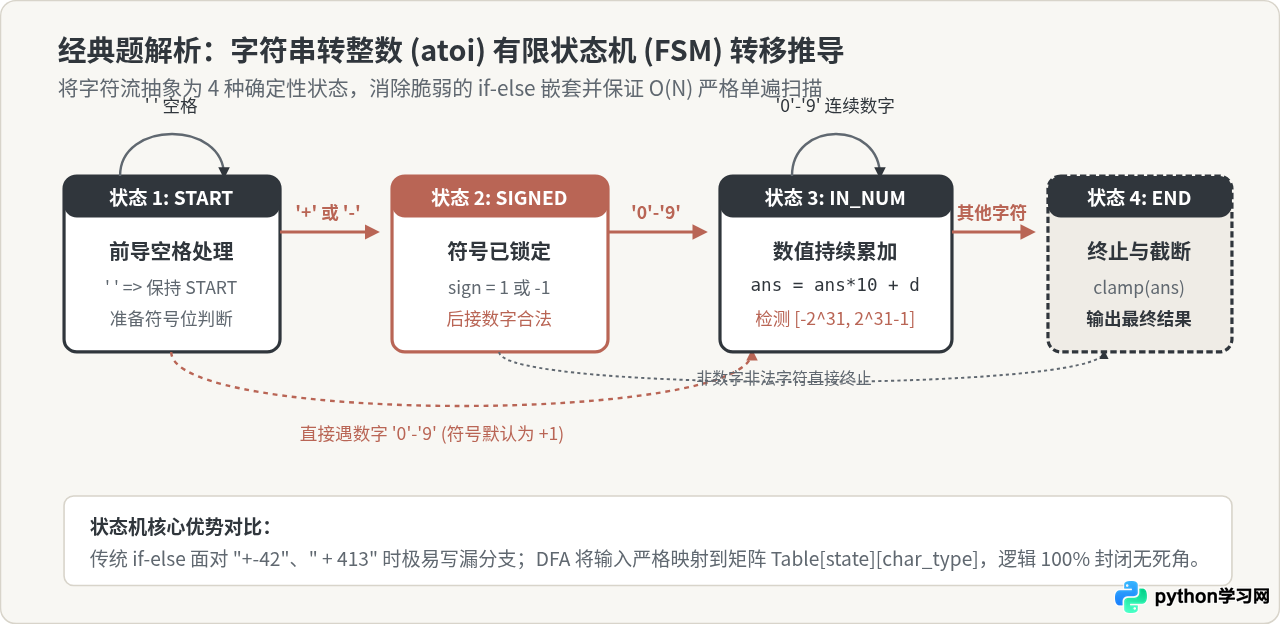
采用确定性有限状态自动机(Deterministic Finite Automaton, DFA)能够将字符处理过程清晰地拆分为 4 个离散状态:
START:跳过前导空格,接受符号或首位数字;SIGNED:记录正负号(1 或 -1),只允许转向数字状态;IN_NUM:持续累加数字,并在每一步执行防溢出检测;END:遇非法字符或已完成截断,终止处理并输出。
3. 代码实现与溢出防护
class AtoiAutomaton:
    INT_MAX = 2**31 - 1
    INT_MIN = -2**31

    def __init__(self):
        self.state = "START"
        self.sign = 1
        self.ans = 0

        # 状态转移表: [空格, 正负号, 数字, 其他字符]
        self.table = {
            "START":   ["START", "SIGNED", "IN_NUM", "END"],
            "SIGNED":  ["END",   "END",    "IN_NUM", "END"],
            "IN_NUM":  ["END",   "END",    "IN_NUM", "END"],
            "END":     ["END",   "END",    "END",    "END"]
        }

    def _get_col(self, char: str) -> int:
        if char == " ":
            return 0
        if char in ("+", "-"):
            return 1
        if char.isdigit():
            return 2
        return 3

    def step(self, char: str) -> bool:
        col = self._get_col(char)
        self.state = self.table[self.state][col]

        if self.state == "SIGNED":
            self.sign = 1 if char == "+" else -1
        elif self.state == "IN_NUM":
            digit = int(char)
            # 在 Python 中大整数不会真正物理溢出,但为了贴合 32 位限制,在此处计算
            self.ans = self.ans * 10 + digit
            # 溢出截断判断
            if self.sign == 1 and self.ans >= self.INT_MAX:
                self.ans = self.INT_MAX
                self.state = "END"
                return False
            elif self.sign == -1 and -self.ans <= self.INT_MIN:
                self.ans = -self.INT_MIN # 取绝对值对齐
                self.state = "END"
                return False
        elif self.state == "END":
            return False

        return True

def my_atoi(s: str) -> int:
    automaton = AtoiAutomaton()
    for char in s:
        if not automaton.step(char):
            break
    return automaton.sign * automaton.ans

# 示例调用
if __name__ == "__main__":
    cases = ["42", "   -42", "4193 with words", "words and 987", "-91283472332", "+-12"]
    for c in cases:
        print(f"输入: {c!r:<22} => 转换结果: {my_atoi(c)}")
输入: ' -42' => 转换结果: -42
输入: '4193 with words' => 转换结果: 4193
输入: 'words and 987' => 转换结果: 0
输入: '-91283472332' => 转换结果: -2147483648
输入: '+-12' => 转换结果: 0
四、经典题三:动态模板替换与敏感数据脱敏 (re.sub 深度运用)
1. 业务场景与原理拆解
在真实业务和面试题中,经常要求批量替换文本中的变量(如 "${user} 在 ${city} 消费了 ${amount}"),或者对手机号、身份证、邮箱等敏感数据进行有针对性的打码。
初学者往往采用多次 s.replace(var, val) 循环扫描字符串。若模板中有 M 个变量、文本长为 N,则总开销为 O(M * N),且当替换后的值恰好包含其他变量特征时,极易发生二次污染(模板注入冲突)。
最优方案是利用 re.sub(pattern, repl, string),其中 repl 传入一个接收 re.Match 对象的回调函数。正则引擎只需单遍线性扫描,并在每次命中时将捕获上下文交由 Python 计算后回填。
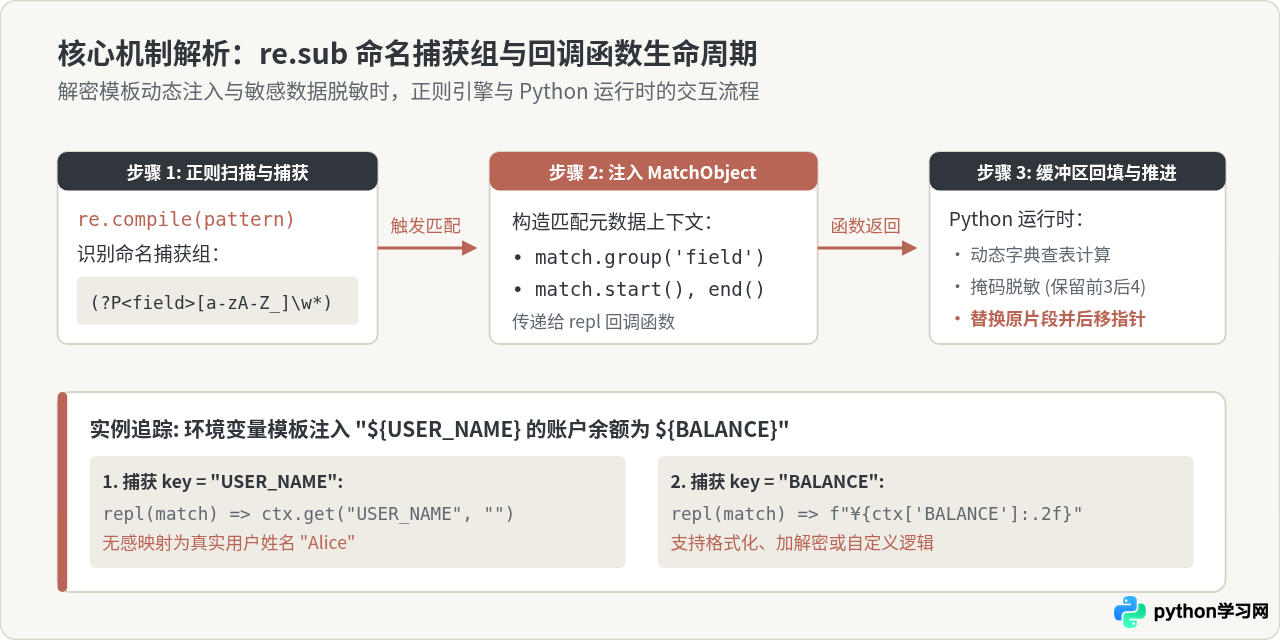
2. 完整实现:命名捕获组与动态上下文回填
import re
from typing import Dict, Any

class TemplateRenderer:
    # 匹配 ${VAR_NAME} 或 $VAR_NAME
    PATTERN = re.compile(r'\$(?:\{(?P<brace_key>[a-zA-Z_]\w*)\}|(?P<plain_key>[a-zA-Z_]\w*))')

    @classmethod
    def render(cls, template: str, context: Dict[str, Any]) -> str:
        def replacer(match: re.Match) -> str:
            # 提取命名组
            key = match.group("brace_key") or match.group("plain_key")
            if key in context:
                return str(context[key])
            # 若上下文不存在该变量,保持原字符串输出,避免误吞
            return match.group(0)

        return cls.PATTERN.sub(replacer, template)

class MaskingService:
    # 手机号脱敏: 保留前3后4,中间4位替换为 ****
    PHONE_PATTERN = re.compile(r'(?P<prefix>1[3-9]\d)(?P<mid>\d{4})(?P<suffix>\d{4})')

    @classmethod
    def mask_phone_numbers(cls, text: str) -> str:
        return cls.PHONE_PATTERN.sub(r'\g<prefix>****\g<suffix>', text)

# 示例调用
if __name__ == "__main__":
    ctx = {
        "name": "张工程师",
        "system": "订单管理集群",
        "code": 200
    }
    raw_tpl = "尊敬的 ${name},您订阅的 $system 状态码为 ${code},未定义变量: ${undefined}。"
    rendered = TemplateRenderer.render(raw_tpl, ctx)
    print("模板渲染输出:")
    print(rendered)

    log_sample = "用户绑定手机号: 13812345678 与 18987654321 请妥善保管。"
    masked = MaskingService.mask_phone_numbers(log_sample)
    print("
手机脱敏输出:")
    print(masked)
尊敬的 张工程师,您订阅的 订单管理集群 状态码为 200,未定义变量: ${undefined}。
手机脱敏输出:
用户绑定手机号: 138****5678 与 189****4321 请妥善保管。
五、经典题四:有效 IPv4 与 IPv6 地址双轨校验
1. 规则矩阵与边界陷阱
验证给定的 IP 字符串属于 "IPv4"、"IPv6" 还是 "Neither":
- IPv4:由 4 个以十进制数字表示的块组成,用点号
.分隔。每个块的数值在0 - 255之间,不能包含前导零(如01.1.1.1非法,但单独的0合法)。 - IPv6:由 8 个十六进制块组成,用冒号
:分隔。每个块包含 1 到 4 个十六进制字符([0-9a-fA-F]),允许前导零,但不允许出现两个连续冒号缩写(题目严格要求 8 个分组)。
2. 两种实现方案对比:原生 split 校验 vs 精准正则断言
在性能敏感场景下,原生字符串切分校验效率更高;而在接口参数过滤等声明式代码中,预编译正则表达力更强。以下提供双轨对照实现:
import re

# 方案 A: 严格正则表达式定义
IPV4_REGEX = re.compile(
    r'^(?:(25[0-5]|2[0-4]\d|1\d{2}|[1-9]\d|\d)\.){3}'
    r'(25[0-5]|2[0-4]\d|1\d{2}|[1-9]\d|\d)$'
)

IPV6_REGEX = re.compile(
    r'^(?:[0-9a-fA-F]{1,4}:){7}[0-9a-fA-F]{1,4}$'
)

def valid_ip_address_regex(ip: str) -> str:
    if IPV4_REGEX.match(ip):
        return "IPv4"
    if IPV6_REGEX.match(ip):
        return "IPv6"
    return "Neither"

# 方案 B: 原生无正则分支校验 (运行效率极高)
def valid_ip_address_native(ip: str) -> str:
    if ip.count('.') == 3:
        chunks = ip.split('.')
        for chunk in chunks:
            if not chunk or len(chunk) > 3:
                return "Neither"
            # 检查前导零: 长度大于1且以 '0' 开头则非法
            if len(chunk) > 1 and chunk[0] == '0':
                return "Neither"
            if not chunk.isdigit():
                return "Neither"
            val = int(chunk)
            if not (0 <= val <= 255):
                return "Neither"
        return "IPv4"

    elif ip.count(':') == 7:
        chunks = ip.split(':')
        hexdigits = "0123456789abcdefABCDEF"
        for chunk in chunks:
            if not (1 <= len(chunk) <= 4):
                return "Neither"
            if not all(ch in hexdigits for ch in chunk):
                return "Neither"
        return "IPv6"

    return "Neither"

# 示例调用
if __name__ == "__main__":
    test_ips = [
        "172.16.254.1",
        "172.16.254.01",
        "256.256.256.256",
        "2001:0db8:85a3:0:0:8A2E:0370:7334",
        "2001:0db8:85a3::8A2E:0370:7334",
        "192.168.1.1.1"
    ]
    for ip in test_ips:
        print(f"IP: {ip:<35} => 正则: {valid_ip_address_regex(ip):<7} 原生: {valid_ip_address_native(ip)}")
IP: 172.16.254.01 => 正则: Neither 原生: Neither
IP: 256.256.256.256 => 正则: Neither 原生: Neither
IP: 2001:0db8:85a3:0:0:8A2E:0370:7334 => 正则: IPv6 原生: IPv6
IP: 2001:0db8:85a3::8A2E:0370:7334 => 正则: Neither 原生: Neither
IP: 192.168.1.1.1 => 正则: Neither 原生: Neither
六、经典题五:非结构化系统日志提取与贪婪回溯防范
1. 痛点分析:灾难性回溯 (Catastrophic Backtracking)
系统运维与数据清洗中常遇到从复杂日志行提取结构化字段的需求。例如:
[2026-11-01 10:20:30] "GET /api/v1/orders?user_id=1024 HTTP/1.1" 200 452ms "client-ip:192.168.1.10"
如果使用初级正则 \[(.*)\]\s+"(.*)"\s+(\d+)\s+(\d+)ms,当日志格式略有损坏(例如缺失了结尾双引号)时,通配符 .* 与正则引擎的回溯机制会触发极其恐怖的排列重试,使单核 CPU 占用率瞬间飙升至 100%,引发正则表达式拒绝服务攻击(ReDoS)。
防御准则:永远使用“互斥字符集”(如 [^\]]+ 取代 .*?)限制扫描范围,使匹配不成功时立即失配,彻底抹除回溯路径。
2. 工业级日志解析器代码
import re
from typing import Optional, Dict

class AccessLogParser:
    # 消除通配符回溯隐患,使用精准限定符与命名捕获组
    LOG_PATTERN = re.compile(
        r'^\[(?P<timestamp>[^\]]+)\]\s+'                 # 时间戳,匹配到 ']' 停止
        r'"(?P<method>[A-Z]+)\s+'                         # HTTP 方法
        r'(?P<path>[^\s"]+)\s+'                           # 请求路径
        r'(?P<proto>HTTP/\d\.\d)"\s+'                     # 协议版本
        r'(?P<status>\d{3})\s+'                          # 状态码
        r'(?P<latency>\d+)ms\s+'                          # 耗时毫秒
        r'"client-ip:(?P<client_ip>[^"]+)"$'              # 客户端IP
    )

    @classmethod
    def parse_line(cls, line: str) -> Optional[Dict[str, str]]:
        match = cls.LOG_PATTERN.match(line.strip())
        if not match:
            return None
        return match.groupdict()

# 示例调用
if __name__ == "__main__":
    raw_logs = [
        '[2026-11-01 10:20:30] "GET /api/v1/orders?user_id=1024 HTTP/1.1" 200 452ms "client-ip:192.168.1.10"',
        '[2026-11-01 10:20:31] "POST /api/v1/pay HTTP/1.1" 500 1200ms "client-ip:10.0.0.1"',
        '[INVALID_FORMAT_LINE] Missing fields'
    ]
    for idx, log in enumerate(raw_logs, 1):
        parsed = AccessLogParser.parse_line(log)
        print(f"日志 {idx} 解析结果: {parsed}")
日志 2 解析结果: {'timestamp': '2026-11-01 10:20:31', 'method': 'POST', 'path': '/api/v1/pay', 'proto': 'HTTP/1.1', 'status': '500', 'latency': '1200', 'client_ip': '10.0.0.1'}
日志 3 解析结果: None
七、知识沉淀:字符串与正则解题五维排查速查
在完成字符串处理算法与正则表达式相关题目时,建议在编码完成后对照以下五维核验矩阵进行逐项扫描:
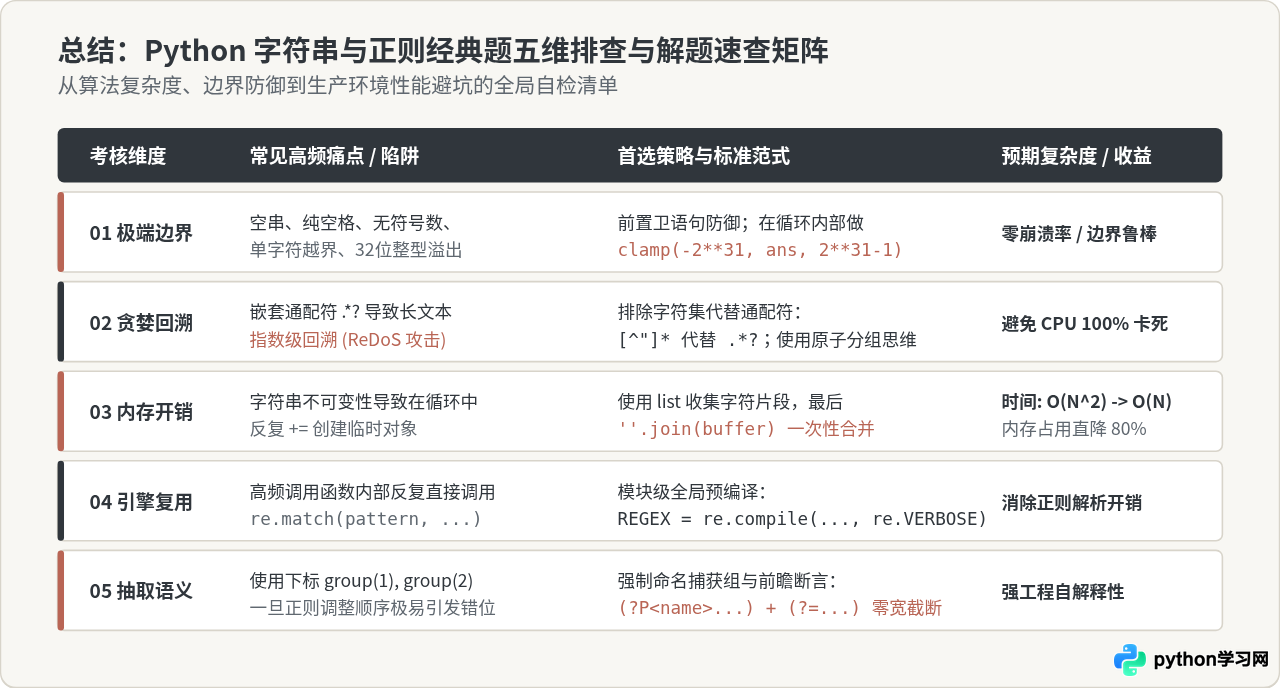
| 检查项 | 核心代码准则 | 典型反例 | 正例示范 |
|---|---|---|---|
| 循环拼接 | 禁用不可变字符串持续 += |
s = ""; for c in arr: s += c |
''.join(buf_list) |
| 正则预编译 | 函数外模块级预编译并复用 Pattern | 在循环/函数内反复调用 re.findall(...) |
PATTERN = re.compile(...) |
| 通配符约束 | 拒绝无界限 .*,使用排除字符集 |
"key=(.*)&" |
"key=([^&]+)" |
| 分组提取 | 优先使用 (?P<name>...) 命名捕获组 |
依赖顺序下标 m.group(3) |
m.group("user_id") |
| 零宽断言 | 利用 (?=...) 与 (?<=...) 匹配边界不占位 |
提取后手动二次 str.strip() |
r'(?<=\[)\w+(?=\])' |
通过合理运用双指针降低额外内存分配、利用状态机化解多分支条件混乱、使用回调函数赋能正则替换,并在模式匹配中时刻警惕回溯风险,读者便能够在各类算法面试与工程文本处理中写出兼具高执行效率与鲁棒性的优质代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















