


Python常用标准库速查:os、sys、re模块手册用法详解
深入解析Python核心标准库os、sys与re模块的高频用法与手册规范,提供涵盖文件操作、环境交互、命令行参数与正则匹配的实用代码示例与全流程速查指南。
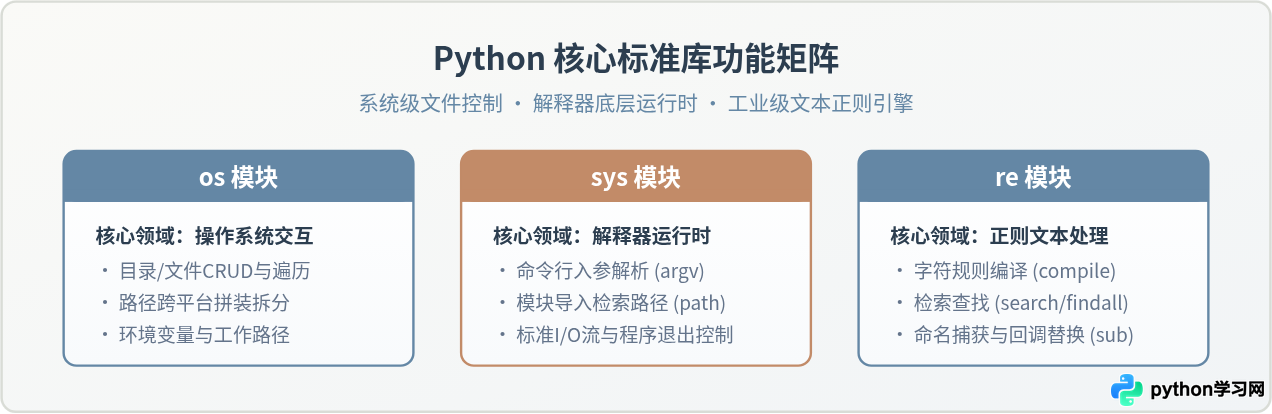
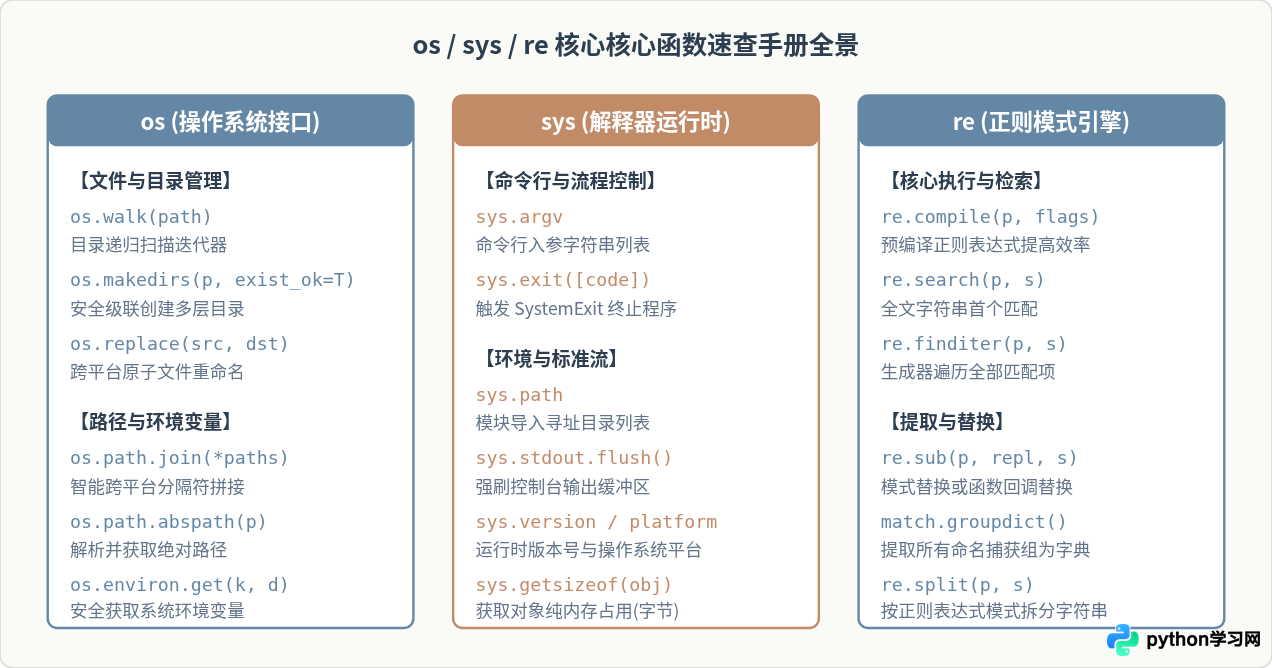
os(操作系统交互)、sys(解释器运行时控制)以及 re(正则表达式文本解析)是调用频度最高的三个基石模块。本文针对这三个模块的核心API、运行原理及易踩坑边界进行系统梳理,帮助读者建立清晰的调用心智模型与实用速查手册。
一、三维协作体系:os、sys 与 re 的职责边界
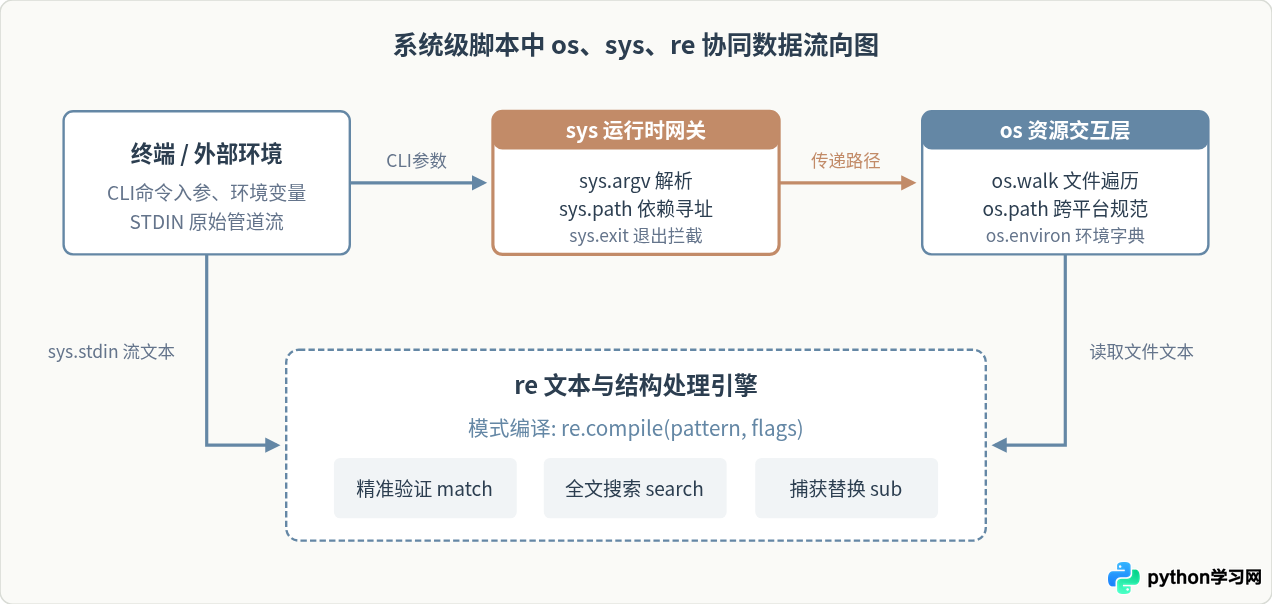
在编写生产级脚本时,很多初学者容易混淆 os 与 sys 的分界线,或者在字符串简单切分与正则处理间摇摆不定。清晰界定三者的物理与逻辑边界是写出高内聚代码的前提:
- sys 关注 Python 解释器本身:它的作用域位于 Python 进程生命周期内部,负责管理外部传递给解释器的参数、解释器加载模块的寻址规则、垃圾回收与内存引用,以及标准的字节流输入输出。
- os 关注宿主操作系统环境:它的作用域穿透解释器边界,直达底层操作系统接口。涵盖工作目录切换、文件与文件夹创建/移动/销毁、环境变量读取与写入、跨平台路径规范化。
- re 关注结构化与非结构化文本:它是纯粹的计算型与模式匹配引擎,不依赖外部系统状态。它将字符串从普通字符流提升为具有特定语义模式的结构单元。
二、os 模块手册:文件系统与操作系统接口
os 模块提供了便携式的使用操作系统相关功能的机制。在日常脚本中,我们主要使用其对文件路径的拼装判断、目录递归以及环境变量的维护。
1. 路径操作:os.path 子模块核心速查
虽然 Python 3.4+ 引入了面向对象的 pathlib,但 os.path 在处理纯字符串路径、底层 C 扩展兼容以及海量小脚本中依然被极其广泛地采用。
os.path.join(*paths):根据当前操作系统(POSIX使用/,Windows使用\)智能拼接路径。注意:若某参数以根目录/开头,则之前所有已拼路径会被丢弃并重置。os.path.abspath(path):将相对路径转换为包含当前工作目录上下文的绝对规范路径。os.path.split(path):将路径按末尾分割,返回(dirname, basename)二元元组。os.path.splitext(path):按最后一个点号分离文件路径与扩展名,返回(root, ext),如('app', '.py')。os.path.exists(path)/isfile(path)/isdir(path):状态检查三件套,分别用于判断实体是否存在、是否为常规文件、是否为目录。
import os

# 路径拼装与标准化示例
base_dir = os.path.dirname(os.path.abspath(__file__))
target_file = os.path.join(base_dir, "data", "reports", "annual_2026.csv")

print("绝对路径:", target_file)
print("父级目录:", os.path.dirname(target_file))
print("文件名称:", os.path.basename(target_file))
print("主名与后缀:", os.path.splitext(target_file))父级目录: /workspace/project/data/reports
文件名称: annual_2026.csv
主名与后缀: ('/workspace/project/data/reports/annual_2026', '.csv')
2. 文件与目录 CRUD 管理
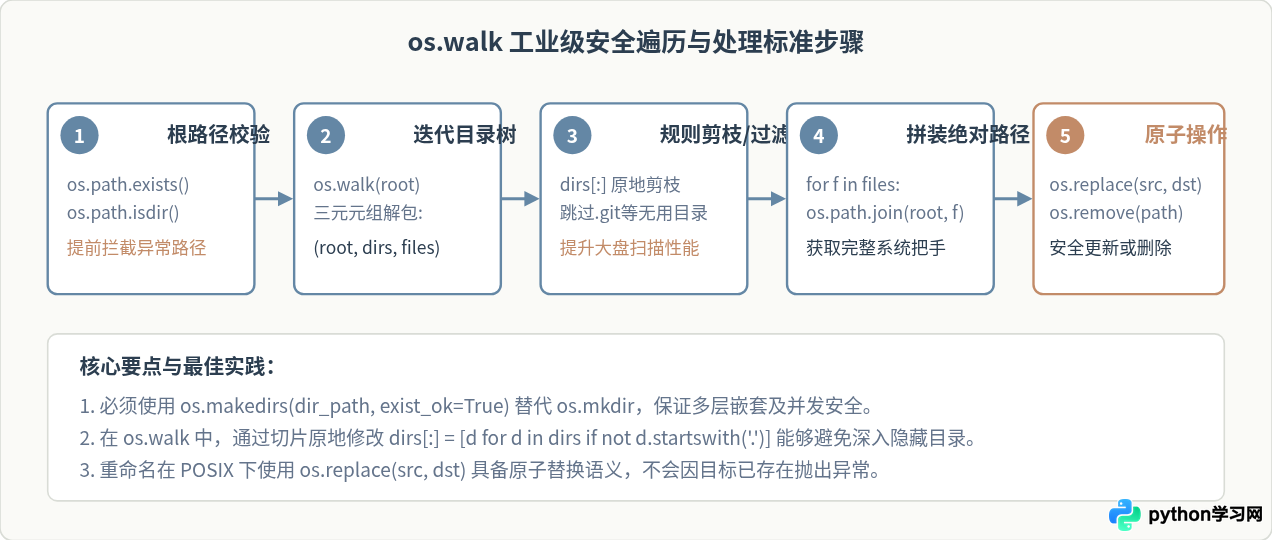
在自动化文件归档或清理场景中,目录创建与遍历是重头戏。必须注意避免因目标目录已存在或父目录缺失导致的 FileExistsError 与 FileNotFoundError。
import os

# 1. 递归创建目录(避免层级不存在错误)
output_dir = "/tmp/demo_workspace/logs/2026/11"
os.makedirs(output_dir, exist_ok=True)

# 2. 目录树遍历与文件排查
target_scan_dir = "/tmp/demo_workspace"
print(f"开始遍历目录: {target_scan_dir}")

for root, dirs, files in os.walk(target_scan_dir):
    # 原地剪枝:跳过所有以 . 开头的隐藏目录(如 .cache、.git)
    dirs[:] = [d for d in dirs if not d.startswith(".")]

    for filename in files:
        full_path = os.path.join(root, filename)
        file_size = os.path.getsize(full_path)
        print(f"找到文件: {full_path} (大小: {file_size} 字节)")
3. 环境变量与工作目录管理
脚本运行时经常需要读取外部配置(如 API Key、数据库连接串),或切换程序当前的执行上下文。
os.environ:系统环境变量映射对象。读取时推荐使用os.environ.get("KEY", "default_val")避免直接下标访问触发KeyError。对os.environ[key] = val的赋值仅影响当前 Python 进程及其后续派生的子进程,不会修改父级终端的环境变量。os.getcwd()与os.chdir(path):分别用于获取当前工作目录与切换工作目录。注意:相对路径均基于os.getcwd()解析,而非当前脚本文件所在的物理目录。
三、sys 模块手册:解释器运行时与控制机制
sys 模块提供了与 Python 解释器紧密相关的变量和函数,主要控制着命令行参数的注入、模块寻址上下文以及异常退出。
1. 命令行参数解析:sys.argv
sys.argv 是一个由字符串构成的 Python 列表,捕获自终端调用:
sys.argv[0]恒为当前执行的脚本名称(或-c/-m标志)。sys.argv[1:]包含了终端随后传入的所有位置参数。
sys.argv 中的所有元素类型均为 str。即使在终端输入整数或浮点数,脚本也必须显式进行 int(sys.argv[1]) 等类型转换,并配合长度校验防止 IndexError。
import sys

def parse_args():
    if len(sys.argv) < 3:
        print(f"用法错误: python {sys.argv[0]} <输入路径> <模式(fast/full)>")
        sys.exit(1) # 非零状态码退出表示异常

    input_file = sys.argv[1]
    run_mode = sys.argv[2].lower()
    return input_file, run_mode

if __name__ == "__main__":
    src_file, mode = parse_args()
    print(f"解析参数成功: 文件={src_file}, 模式={mode}")
2. 解释器模块寻址:sys.path 机制与注入
当执行 import my_module 时,Python 解释器按照 sys.path 列表中的路径顺序逐一查找对应 .py 文件或包目录:
- 启动脚本所在的当前目录(或命令行执行时所在的位置)。
- 系统环境变量
PYTHONPATH指定的目录列表。 - 标准库目录与虚拟环境的
site-packages第三方包目录。
在组织多层级工程结构时,如果子目录脚本需要调用根目录公共模块,可以通过动态追加路径解决导入报错:
import os
import sys

# 动态将项目根目录追加到 sys.path 首位
current_dir = os.path.dirname(os.path.abspath(__file__))
project_root = os.path.abspath(os.path.join(current_dir, "..", ".."))

if project_root not in sys.path:
    sys.path.insert(0, project_root)

# 随后可安全导入项目顶级包
# import core.utils
3. 标准输入输出流与程序终止
sys.stdin,sys.stdout,sys.stderr:这三个是与宿主操作系统的标准输入、标准输出、标准错误文件描述符(0, 1, 2)绑定的文本流对象。通过重定向sys.stdout = open("log.txt", "w")可以劫持全局print输出。sys.stdout.flush():强制刷新控制台缓冲区,常用于输出实时下载进度条或无换行动态刷新。sys.exit([arg]):引发SystemExit异常终止程序。传参整数(通常0表示成功,非 0 表示各类错误码),传参字符串时则将字符串打印至标准错误后以码值 1 退出。
四、re 模块手册:正则表达式引擎与模式匹配
Python 的 re 模块底层通过 C 语言实现了 Perl 风格的正则表达式引擎。高效使用 re 的核心在于掌握不同检索函数的适用边界、掌握分组提取,以及合理运用预编译。
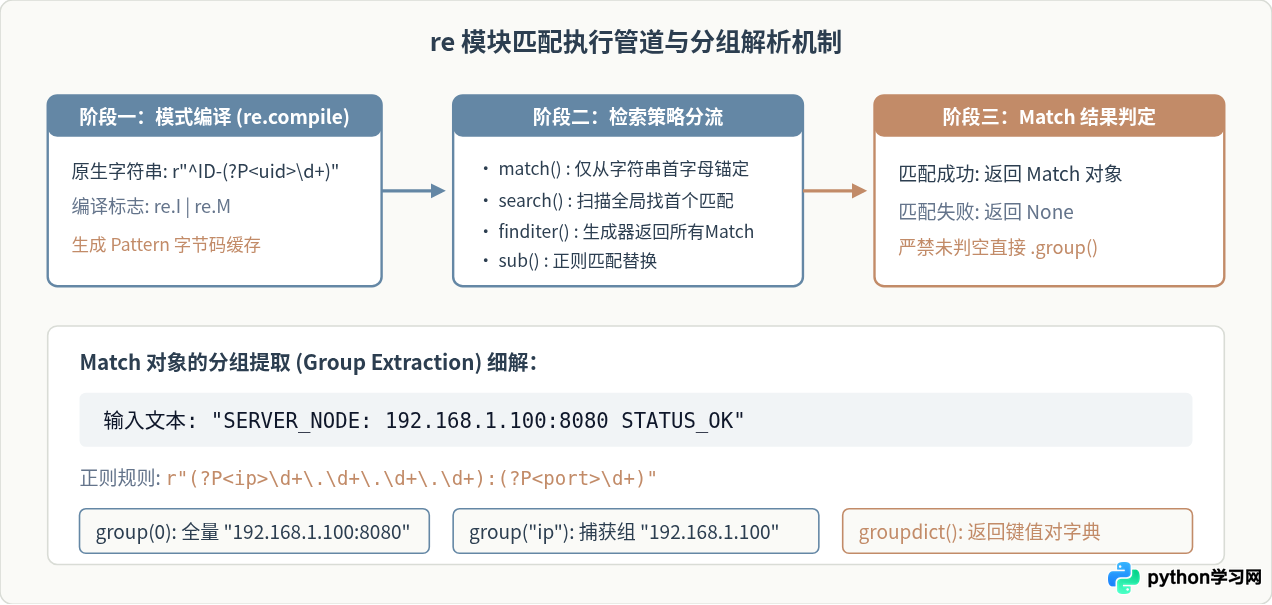
1. 核心检索函数对比与选用规则
| 函数 API | 检索范围与行为 | 返回值类型 | 最佳使用场景 |
|---|---|---|---|
re.match(pattern, string) |
严格从文本的起始位置(0索引)开始匹配 | Match 对象 或 None | 校验整体格式前缀,如判断行首是否为注释标号 |
re.search(pattern, string) |
扫描整个字符串,寻找第一个匹配项后停止 | Match 对象 或 None | 在文本任意位置寻找目标线索(如提取日志中的时间戳) |
re.findall(pattern, string) |
遍历全文,寻找所有不重叠的匹配项 | 列表(str 列表或 tuple 列表) | 快速提取简单数字、URL列表;内存占用高 |
re.finditer(pattern, string) |
惰性迭代全文匹配项 | 可迭代迭代器(元素为 Match) | 处理大文件日志流,需要获得匹配位置 span() |
re.sub(pattern, repl, string) |
正则匹配并执行替换 | 替换后的新字符串 | 文本清洗脱敏、动态格式重组(repl 支持函数回调) |
2. 命名分组与高级捕获实战
常规索引分组 group(1) 在正则表达式规则扩展时极易发生序号漂移,导致代码维护困难。推荐使用命名捕获分组语法 (?P<name>pattern):
import re

log_line = '2026-11-01 10:24:05 [ERROR] [auth_service] User:1082 Authentication failed: Invalid token'
pattern = re.compile(
    r'^(?P<timestamp>\d{4}-\d{2}-\d{2}\s\d{2}:\d{2}:\d{2})\s'
    r'\[(?P<level>[A-Z]+)\]\s'
    r'\[(?P<module>\w+)\]\s'
    r'User:(?P<user_id>\d+)\s'
    r'(?P<message>.*)$'
)

match = pattern.search(log_line)
if match:
    data = match.groupdict()
    print("解析出的结构化字典:")
    for k, v in data.items():
        print(f"  {k}: {v}")
else:
print("日志格式不匹配")timestamp: 2026-11-01 10:24:05
level: ERROR
module: auth_service
user_id: 1082
message: Authentication failed: Invalid token
3. 回调替换:re.sub 的进阶用法
re.sub 的第二个参数 repl 不仅可以传入静态替换模板,还可以传入一个接收 Match 对象的可调用函数。这使得我们能够在替换时动态计算结果(例如将文本中的华氏度自动转换为摄氏度,或脱敏敏感数字):
import re

text = "用户手机号: 13812345678, 备用电话: 13987654321"

def mask_phone(match):
    # match.group(0) 获得匹配的11位号码
    raw = match.group(0)
    return raw[:3] + "****" + raw[7:]

# 使用函数回调进行批量掩码
masked_text = re.sub(r'1\d{10}', mask_phone, text)
print("脱敏后文本:", masked_text)五、三合一工业实战:自动化日志清洗与统计脚本
在生产环境中,这三个模块通常链式配合:通过 sys.argv 接收执行参数并使用 sys.exit 处理异常退出;使用 os 扫描指定目录下的日志树并规整路径;最后利用 re 解析文本内容并生成结构化报表。
import os
import sys
import re

def process_log_files(target_dir, level_filter="ERROR"):
    # 1. os 校验目标目录合法性
    if not os.path.exists(target_dir):
        sys.stderr.write(f"[错误] 目录不存在: {target_dir}\n")
        sys.exit(1)

    # 2. re 预编译日志解析规则与级别过滤器
    log_pattern = re.compile(r'\[(?P<level>INFO|WARN|ERROR|FATAL)\]\s(?P<msg>.*)')
    level_filter = level_filter.upper()

    total_matches = 0
    file_count = 0

    print(f"=== 开始扫描目录: {target_dir} (过滤等级: {level_filter}) ===")

    # 3. os.walk 递归检索 .log 文件
    for root, _, files in os.walk(target_dir):
        for file in files:
            if not file.endswith(".log"):
                continue

            file_count += 1
            file_path = os.path.join(root, file)

            try:
                with open(file_path, "r", encoding="utf-8", errors="ignore") as f:
                    for line_num, line in enumerate(f, start=1):
                        match = log_pattern.search(line)
                        if match and match.group("level") == level_filter:
                            total_matches += 1
                            rel_path = os.path.relpath(file_path, target_dir)
                            print(f"[{rel_path}:{line_num}] {match.group('msg')}")
            except OSError as err:
                sys.stderr.write(f"[警告] 无法读取文件 {file_path}: {err}\n")

    print(f"=== 统计完成: 扫描 {file_count} 个文件,捕获 {total_matches} 条 {level_filter} 记录 ===")

if __name__ == "__main__":
    # sys.argv 参数解析与默认回退
    if len(sys.argv) < 2:
        print(f"参数提示: python {sys.argv[0]} <日志目录> [级别过滤(默认ERROR)]")
        sys.exit(2)

    scan_path = sys.argv[1]
    filter_tag = sys.argv[2] if len(sys.argv) >= 3 else "ERROR"
    process_log_files(scan_path, filter_tag)
六、高频避坑指南
os.path.join(a, b) 时,务必确保 b 的首字符不是 /。例如在 Linux 下 os.path.join("/home/data", "/report.csv") 的计算结果是 "/report.csv",而不是期望的 "/home/data/report.csv"。
r"..." 原生字符串语法。普通字符串中 "\d" 会先被 Python 转义解析;在原生字符串中反斜杠才会原封不动交由正则引擎处理。
*, +, {n,} 默认处于贪婪状态,会尽可能多地消耗字符。在提取带括号的内容时,务必加上 ? 声明为非贪婪,如 r"<h1>(.*?)</h1>",否则当一行中出现多个标签时会跨界吞没中间全部字符。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















