


Python正则表达式字符集[]与范围匹配规则

在 Python 正则表达式中,方括号 [] 用于构建字符集(Character Class / Set)。它的核心规则非常清晰:每次仅匹配目标文本中的单个字符,且括号内部的所有候选字符呈“逻辑或”关系。当需要在字符集中表示一段连续字符时,使用连字符 - 形成范围区间(如 [0-9] 或 [a-z]),该范围由字符的底层 ASCII/Unicode 编码顺序决定。掌握字符集是编写精确、高效正则匹配规则的基础。
一、字符集 [] 的核心本质:单字符匹配与离散枚举
初学者对字符集最常见的误解,是将其视为一个整体词组匹配工具。实际上,无论方括号内填入多少个字符,只要没有搭配量词(如 +、*、{n}),[...] 在任何一次匹配判定中,只且仅只消耗一个字符的位置。
例如,表达式 [abc] 表示“当前位置的字符只要是 a、b 或 c 中的任意一个即可通过”。它与括号分组 (abc) 存在根本区别:前者匹配长度为 1 的备选字符,后者匹配长度为 3 的完整连续字符串 "abc"。
import re

text = "cab, cat, tab, act"

# [abc] 每次只匹配一个字符
matches = re.findall(r'[abc]', text)
print("findall结果:", matches)
# 示例输出:
# findall结果: ['c', 'a', 'b', 'c', 'a', 'a', 'b', 'a', 'c']

# 结合单词结构,匹配以 a/b/c 开头,中间为 a,末尾为 t 的单词
word_matches = re.findall(r'\b[abc]at\b', text)
print("单词匹配结果:", word_matches)
# 示例输出:
# 单词匹配结果: ['cat', 'bat'] (注:若原文本包含bat则匹配,本例只命中cat)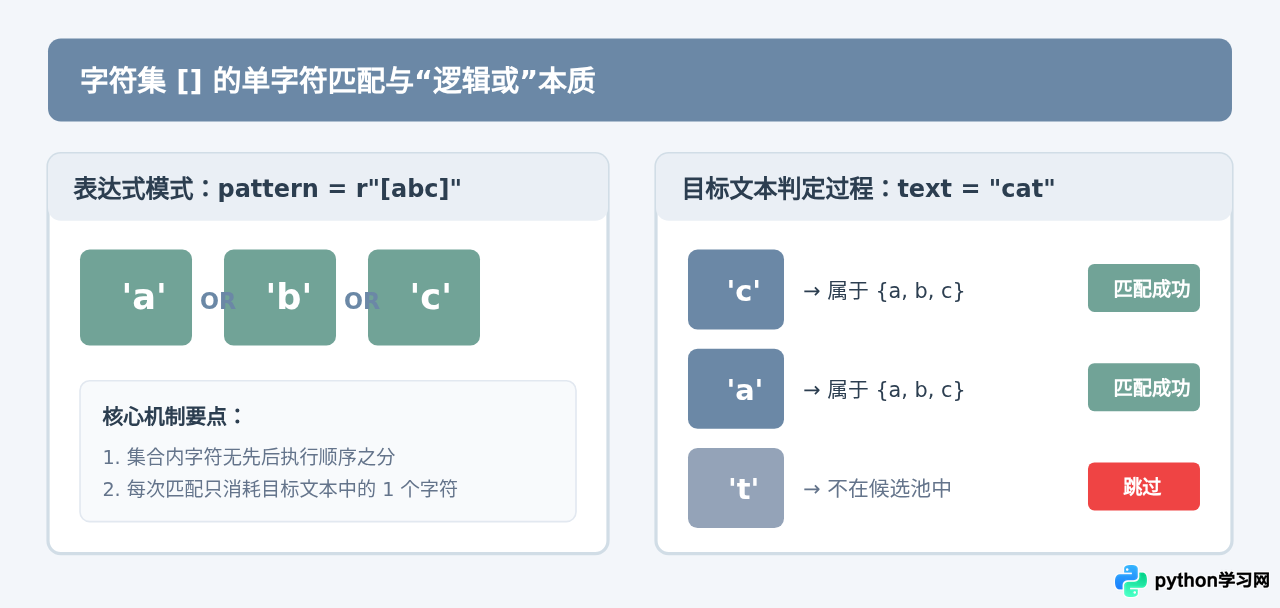
二、范围匹配规则:连字符 - 的区间机制与编码约束
当需要匹配的候选字符具有连续性时,逐一列举所有字符既繁琐又易出错。此时可以在字符集内部使用连字符 - 来声明一个闭区间范围,其语法格式为 [起始字符-结束字符]。
1. 常见范围定义与拼接
连字符范围可以单独使用,也可以在同一个方括号中连续书写多个区间,甚至与离散字符混合排列:
[0-9]:匹配 0 至 9 之间的任意单个阿拉伯数字(等价于\d在 ASCII 模式下的行为)。[a-z]:匹配任意单个小写英文字母。[A-Z]:匹配任意单个大写英文字母。[a-zA-Z0-9_]:匹配大小写字母、数字及下划线,多个范围并列书写时直接首尾相接,不需要任何分隔符。
连字符的范围基于字符的 ASCII / Unicode 编码点。起始字符的码点值必须小于或等于终止字符的码点值。如果颠倒顺序(如写成
[9-0] 或 [z-a]),Python 的 re 编译器将直接抛出 re.error: bad character range ... at position ... 异常。
import re

# 规范的多区间混合使用
identifier_pattern = r'^[a-zA-Z_][a-zA-Z0-9_]*$'

test_cases = ["var_1", "_counter", "2nd_value", "hello-world"]
for item in test_cases:
    matched = bool(re.match(identifier_pattern, item))
    print(f"'{item}' 是否合法标识符: {matched}")

# 示例输出:
# 'var_1' 是否合法标识符: True
# '_counter' 是否合法标识符: True
# '2nd_value' 是否合法标识符: False (首字符不是字母或下划线)
# 'hello-world' 是否合法标识符: False (减号不在允许范围内)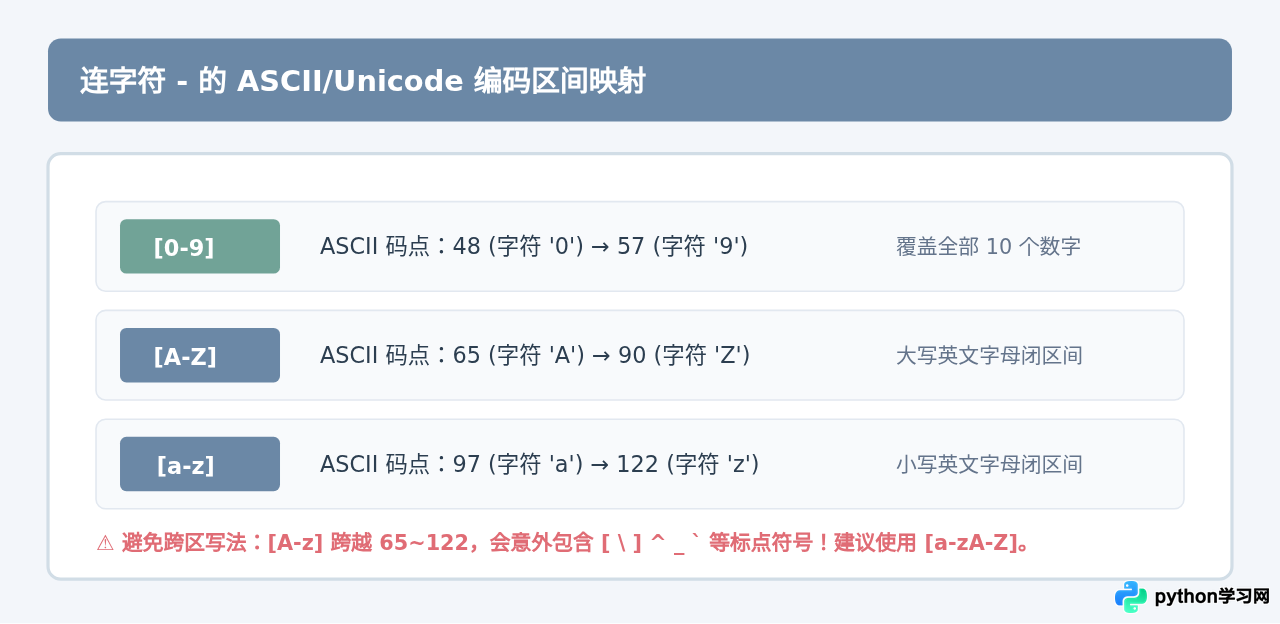
三、方括号内的特殊符号与转义脱敏规则
字符集 [] 内部形成了一个独立的语法微环境。在这个微环境中,绝大多数在外部具有特殊含义的元字符都会自动失去特殊功能,退化为普通字面量。了解这一特性可以避免编写不必要的反斜杠转义,提升正则表达式的可读性。
1. 自动退化为字面量的元字符
在普通正则表达式中,. 表示匹配任意字符,*、+、? 表示量词重复,() 表示分组捕获,$ 表示行尾锚点。但一旦放入 [] 内部:
[.()]:精确匹配字符.、(或),无需写成[\.\(\)]。[*+?]:精确匹配字符*、+或?本身。[$]:精确匹配美元符号$,不再具有锚定行尾的含义。
2. 方括号内仍然保留特殊语义的 3 个关键符号
只有极少数符号在方括号内具有特殊控制功能,当需要匹配它们本身的字面值时,需要遵守位置规则或反斜杠转义:
| 字符 | 特殊含义与触发条件 | 匹配字面量的方法 |
|---|---|---|
^ |
仅在方括号首位触发取反(如 [^0-9] 表示排除数字) |
① 避免放在首位,如 [a^b];② 或者使用转义 [\^] |
- |
位于两个合法端点之间时,触发范围连接(如 [0-9]) |
① 置于最前([-az])或最后([az-]);② 使用转义 [\-] |
] |
字符集闭合界定符 | 必须使用反斜杠转义 [\]],或紧跟在首位([]abc],推荐直接转义) |
import re

text = "价格: $100.00, 算式: 3+2*5=13, 范围: [1-5]"

# 匹配句点、星号、加号或美元符号(方括号内自动脱敏)
res1 = re.findall(r'[$+.*]', text)
print("脱敏符号匹配:", res1)
# 示例输出:
# 脱敏符号匹配: ['$', '.', '.', '+', '*']

# 匹配中括号字面量及减号
res2 = re.findall(r'[\[\]\-]', text)
print("括号与减号匹配:", res2)
# 示例输出:
# 括号与减号匹配: ['[', '-', ']']
四、取反字符集 [^...] 的排他匹配与边界陷阱
在方括号内以脱字符 ^ 开头时(如 [^...]),该字符集转变为否定字符集(Negated Character Class)。
它表示:匹配任意单个“不在方括号列表中”的字符。需要特别强调两点限制:
- 依然只匹配单个字符:
[^0-9]每次只吃掉一个非数字字符,它并不代表“排除一整个词”或“零宽负向断言”。 - 默认包含空白符与换行符:
[^0-9]不仅匹配英文字母和中文汉字,还会匹配空格、制表符\t以及换行符\n。在清洗多行文本时若未显式排除换行符,可能产生跨行抓取的意外后果。
import re

raw_data = "Item1: 250, Item2: 890, Notes: Pass\nNextLine"

# 错误直觉:认为 [^0-9]+ 只匹配英文字符
# 实际结果:标点、空格甚至换行符 \n 都会被吸入
non_digits = re.findall(r'[^0-9]+', raw_data)
print("否定字符集匹配段落:", non_digits)
# 示例输出:
# 否定字符集匹配段落: ['Item', ': ', ', Item', ': ', ', Notes: Pass\nNextLine']

# 正确做法:若仅希望排除数字且不跨行,需显式加入排除列表
safe_non_digits = re.findall(r'[^0-9\r\n]+', raw_data)
print("限制换行后的匹配:", safe_non_digits)
# 示例输出:
# 限制换行后的匹配: ['Item', ': ', ', Item', ': ', ', Notes: Pass', 'NextLine']
五、常用字符集速查与典型避坑指南
在实际工程开发中,开发者容易将某些自然语言逻辑直接带入正则表达式,导致隐蔽的匹配逻辑错误。以下总结了高频使用的规则与常见误区对照。
1. 典型认知误区剖析
- 误区一:把
[10-20]当成匹配 10 到 20 的数值
正如前文所述,字符集只匹配单个字符。[10-20]实际上会被解析为三个组成部分:字符1、区间0-2(即 0, 1, 2)以及字符0。它匹配的是单个数字0、1或2,完全无法用于多位数范围过滤。匹配两位数字应使用1[0-9]|20。 - 误区二:在方括号内部使用管道符
|尝试表示多选
在括号外部,a|b表示匹配 "a" 或 "b"。但在方括号内部,[a|b]会把|视为普通字面量字符,最终匹配a、|或b三者之一。方括号内元素天生具备“或”属性,无需多此一举添加竖线。 - 误区三:忽略原始字符串前缀
r
Python 字符串在解析时也会处理反斜杠。如果不加r前缀,写"[\n]"会在 Python 字符串层级先被转义为换行符字节,导致传入正则引擎的内容与预期偏离。编写任何正则表达式时,始终坚持使用r'...'前缀。
六、总结
理解 Python 中的字符集 [] 与范围匹配,核心在于把握三个基本规律:
- 单字符离散性:方括号表达的是候选集合与单字符匹配,并不表示连续子串,内部也无需添加
|符号。 - 连字符编码顺序:范围
-是基于字符底层编码的闭区间映射,声明时务必遵从由小到大的码点顺序,多区间可直接拼接。 - 符号环境脱敏:多数正则元字符在
[]中自动退化为普通字面量,只需对^(首位)、-(中间位置)和]予以针对性处理或反斜杠转义。
在编写匹配规则时,结合具体业务边界合理选用正向字符集与取反字符集,能够写出既简洁又兼具严谨性的正则表达式。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















