


Python re正则表达式中贪婪与非贪婪模式怎么控制?
深入解析Python re模块中正则表达式贪婪与非贪婪模式的控制方法。通过量词后追加问号切换非贪婪、底层回溯原理剖析、常见数量词对照矩阵、实战场景代码与性能优化建议,帮助读者彻底掌握模式控制技巧。
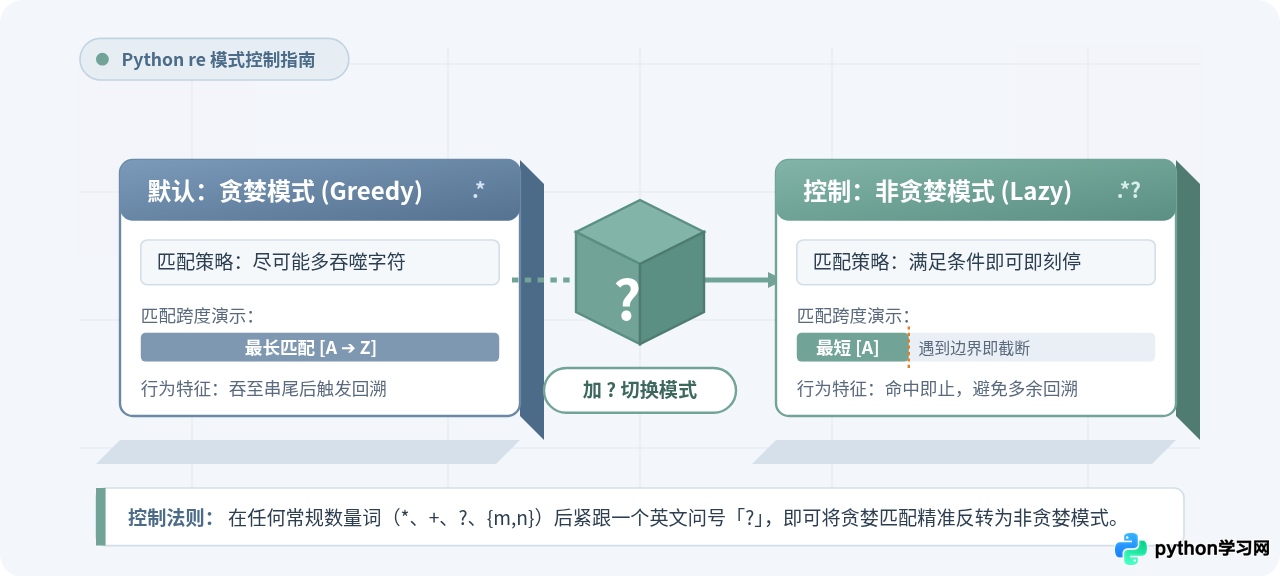
re 模块中,控制贪婪与非贪婪模式的核心开关是在任意数量词(如 *、+、?、{m,n})之后紧跟一个英文问号 ?。默认状态下,Python 正则采用“贪婪模式”,尽可能多地匹配字符直到无法继续为止;一旦在量词后加上 ?,就会立即转变为“非贪婪模式”(也称惰性模式或最小匹配),在满足后续模式的前提下尽可能少地匹配字符。
一、为什么正则默认是贪婪的?从行为看本质区别
在编写文本抓取或数据清洗逻辑时,初学者最常遇到的困惑是:明明想提取被双引号包含的一小段文字,写出的正则却把整行内容甚至多个引号间的数据一次性全“吞”了进去。这种现象的根源正是正则表达式引擎默认的“贪心”策略。
在正则语法中,数量词代表着“匹配多少次”。标准数量词(例如 * 代表 0 次或多次,+ 代表 1 次或多次)被设计为从大到小探索。正则引擎只要看到贪婪数量词,第一反应就是“把能吃的字符全部吞下”,一直吞到字符串末尾;接着再向右查看后续的匹配要求。如果后续要求不满足,它才会极不情愿地一步步“吐出”(即回溯)字符,直到找到一个最靠后的位置使整个表达式成立。
相反,非贪婪模式(惰性模式)则是从小到大探索。只要数量词被追加了 ?,引擎便会奉行“按需满足、绝不多吃”的原则。它先尝试数量词允许的最小匹配次数(例如 *? 优先尝试 0 次,+? 优先尝试 1 次);一旦发现后续字符能够匹配,立刻宣告成功并锁定结果。
代码对比:提取属性值的不同表现
下面的示例清晰地展示了贪婪与非贪婪模式在面对多个闭合字符时的截然不同:
import re

html_data = '<input type="text" name="username" id="user_id">'

# 1. 贪婪模式:r'".*"'
greedy_pattern = r'".*"'
greedy_result = re.findall(greedy_pattern, html_data)

# 2. 非贪婪模式:r'".*?"'
lazy_pattern = r'".*?"'
lazy_result = re.findall(lazy_pattern, html_data)lazy_result: ['"text"', '"username"', '"user_id"']
从输出可见,贪婪模式 r'".*"' 从首个双引号开始,直接吞噬到了最后一个双引号,将中间所有的标签属性合并成了单个大字符串;而非贪婪模式 r'".*?"' 每当遇到一个闭合的双引号就立刻完成一段匹配,最终精确提取出三个独立的属性值。
二、图解匹配原理:从引擎指针与回溯过程看底层运作
为了真正理解模式控制,我们需要直观观察正则表达式引擎内部的指针移动逻辑。很多开发者误以为“非贪婪就是速度快”,但实际上两者的性能取决于文本结构与回溯次数。
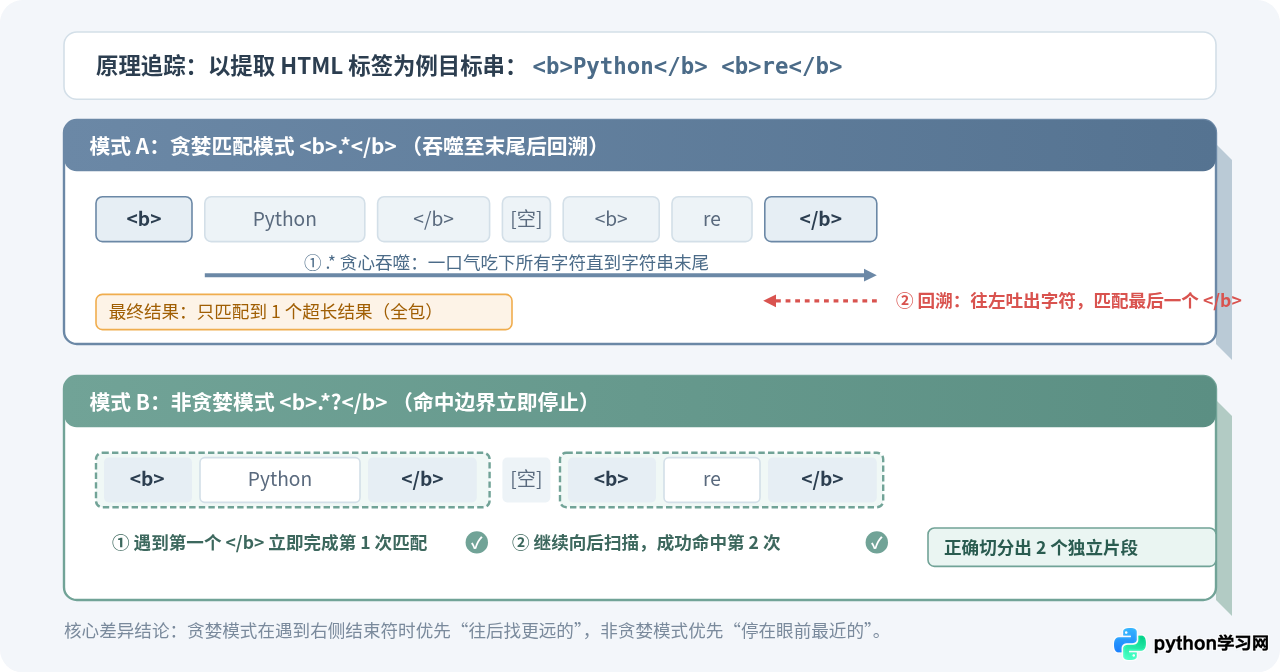
如图 1 所示,面对字符串 <b>Python</b> <b>re</b> 时:
-
贪婪匹配过程:首先
<b>匹配到第一个标签头。随后的.*毫无保留地吃掉了从Python到字符串末尾的全部字符。此时引擎到达字符串末尾,才开始检查模式末尾的</b>。由于末尾已无字符,引擎触发“回溯”(Backtracking),向左退一步检查是否为</b>,退到第二个</b>处刚好匹配成功,因此最终产出了跨越两个标签的超长片段。 -
非贪婪匹配过程:首先
<b>匹配到标签头。随后的.*?优先尝试匹配 0 个字符,并立即测试下一个字符是否能构成</b>。随着指针一步步向右推进,遇到Python之后的首个</b>时,条件立刻完全成立,第 1 次匹配随即封口返回;引擎继续向后扫描,再用同样的方式命中第 2 个独立片段。
三、常用数量词的贪婪与非贪婪转换矩阵
在实际编程中,绝不只有 .* 与 .*? 这一种组合。所有具备重复含义的数量词,都可以通过紧跟英文问号 ? 转换为非贪婪版本。
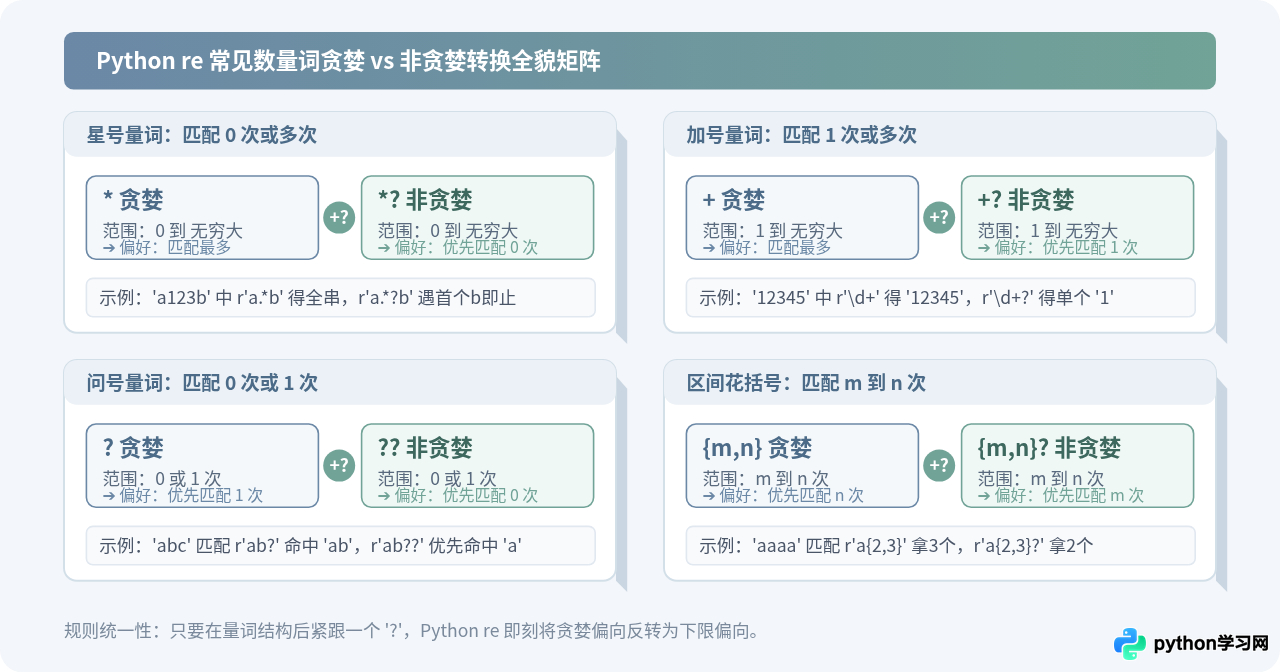
下表列出了 Python 正则中所有标准数量词的对应控制关系与匹配行为:
| 基础数量词 | 贪婪行为(默认) | 非贪婪修饰写法 | 非贪婪行为(加 ? 控制) |
|---|---|---|---|
* |
匹配 0 到任意多次,优先匹配最多次 | *? |
匹配 0 到任意多次,优先匹配 0 次 |
+ |
匹配 1 到任意多次,优先匹配最多次 | +? |
匹配 1 到任意多次,优先匹配 1 次 |
? |
匹配 0 次或 1 次,优先匹配 1 次 | ?? |
匹配 0 次或 1 次,优先匹配 0 次 |
{m,n} |
匹配 m 到 n 次,优先匹配 n 次 | {m,n}? |
匹配 m 到 n 次,优先匹配 m 次 |
{m,} |
匹配至少 m 次,优先匹配最多次 | {m,}? |
匹配至少 m 次,优先匹配 m 次 |
极易混淆的语法点:双问号 ?? 与区间 {m,n}?
初学者常常对 ?? 感到困惑。请记住:前面的问号是数量词(表示“0次或1次”),后面的问号是模式控制符(表示“非贪婪”)。
import re

sample_text = 'abc'

# ? 贪婪匹配:优先抓取 1 次 'b'
print(re.search(r'ab?', sample_text).group())   # 输出: 'ab'

# ?? 非贪婪匹配:优先抓取 0 次 'b'
print(re.search(r'ab??', sample_text).group())  # 输出: 'a'

# {2,4} 贪婪匹配:优先抓取 4 个数字
digit_text = '123456'
print(re.search(r'\d{2,4}', digit_text).group())   # 输出: '1234'

# {2,4}? 非贪婪匹配:优先抓取下限 2 个数字
print(re.search(r'\d{2,4}?', digit_text).group()) # 输出: '12'a
1234
12
四、高频实战场景与控制技巧
场景 1:提取括号或分隔符中的内容
在日志解析或文本清洗中,提取括号内的参数极为常见。如果一行日志中存在多个括号对,贪婪模式会导致整行被串联:
import re

log_line = '[INFO] [UserService] User login successful (uid: 10086) from ip (192.168.1.1)'

# 错误做法(贪婪模式):首尾括号通吃
bad_match = re.findall(r'\(.*\)', log_line)
# 得到: ['(uid: 10086) from ip (192.168.1.1)']

# 正确做法(非贪婪模式):分别提取两组括号
good_match = re.findall(r'\(.*?\)', log_line)
# 得到: ['(uid: 10086)', '(192.168.1.1)']
场景 2:结合 re.DOTALL(re.S)进行跨行提取
默认情况下,元字符点号 . 无法匹配换行符 \n。如果需要跨行提取多段代码或配置块,必须配合 re.DOTALL 旗标使用非贪婪模式,否则不仅匹配不到换行后的内容,或者一旦开启旗标又会贪婪地吞掉整篇文档:
import re

markdown_doc = """```python
def foo():
    pass
```
说明文字
```python
def bar():
    return 1
```"""

# 正确做法:re.DOTALL 配合非贪婪 .*?
code_blocks = re.findall(r'```python\n(.*?)```', markdown_doc, flags=re.DOTALL)
for idx, block in enumerate(code_blocks, 1):
print(f"代码块 {idx}:\n{block.strip()}\n")def foo():
pass
代码块 2:
def bar():
return 1
((a + b) * c))或嵌套标签(如 <div><div>text</div></div>),.*? 会在遇到第一个闭合符号时立即中断,导致外层结构被截断破损。处理嵌套文本请优先使用专门的解析库(如 BeautifulSoup 或状态机解析器)。
五、实战排查与性能防范:避免回溯灾难的标准步骤
在学会了使用 ? 控制非贪婪之后,很多工程师往往会走向另一个极端:到处滥用 .*?。然而,在处理不受信任的外部输入或超长文本时,.*? 可能带来隐蔽的“回溯灾难”(Catastrophic Backtracking)。
当目标字符串并不包含闭合字符(即匹配注定失败)时,.*? 会在字符串的每一个可能位置尝试展开,并在失败后反复退回重新探查,导致 CPU 占用率飙升至 100%,进程陷入假死。
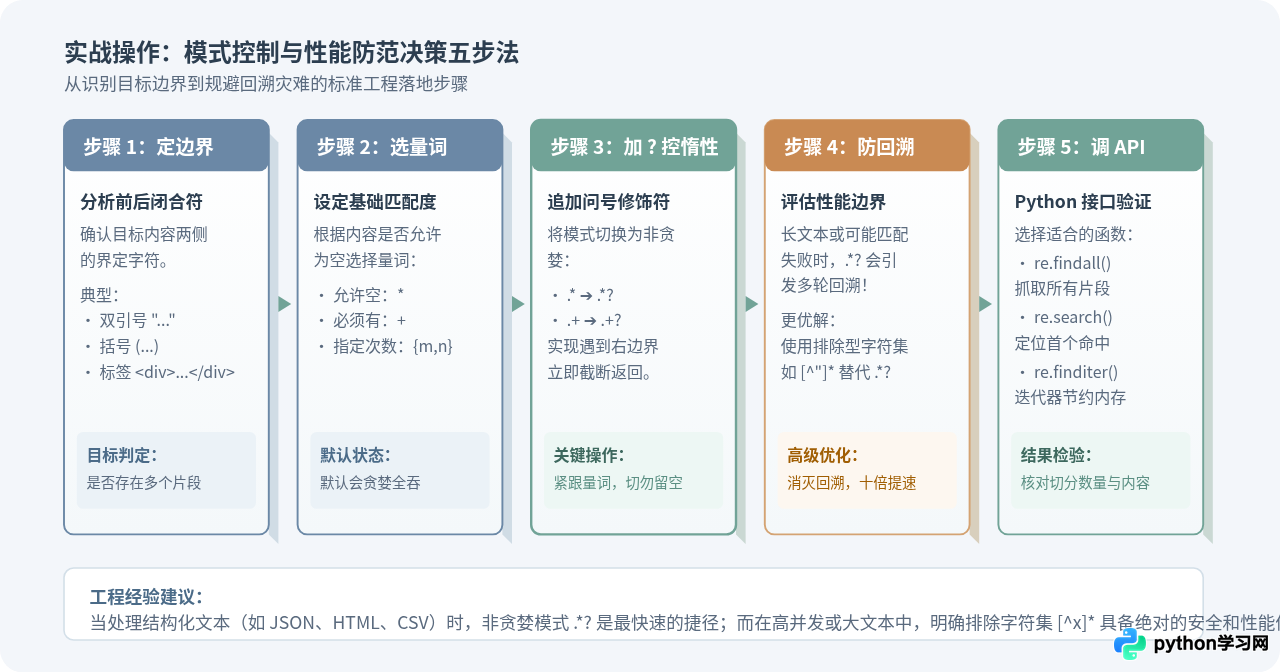
如图 3 所示,在工程实践中,建议遵循以下五步走策略:
- 定边界:明确目标文本的起始与结束分隔符(例如双引号
"或特定结束标记)。 - 选量词:判断分隔符内部的内容是否允许为空(空选
*,非空选+)。 - 加
?控惰性:紧跟数量词后添加?,防止跨片段通吞。 - 防回溯(重要优化):评估是否存在性能风险。如果有性能要求,使用排除型字符集替代
.*?。例如提取双引号内容,写成"[^"]*"远比".*?"健壮:因为[^"]*明确排除了边界字符,引擎永远不需要回溯,性能可提升数倍至数十倍。 - 调 API:根据业务需求选用
re.findall(获取列表)、re.finditer(海量数据流式迭代节约内存)或re.search(仅取首个匹配)。
六、全景知识梳理与核心速查清单
为了在日常开发中随时查阅,以下将全篇核心知识点凝练为全景速查卡片与避坑规则:
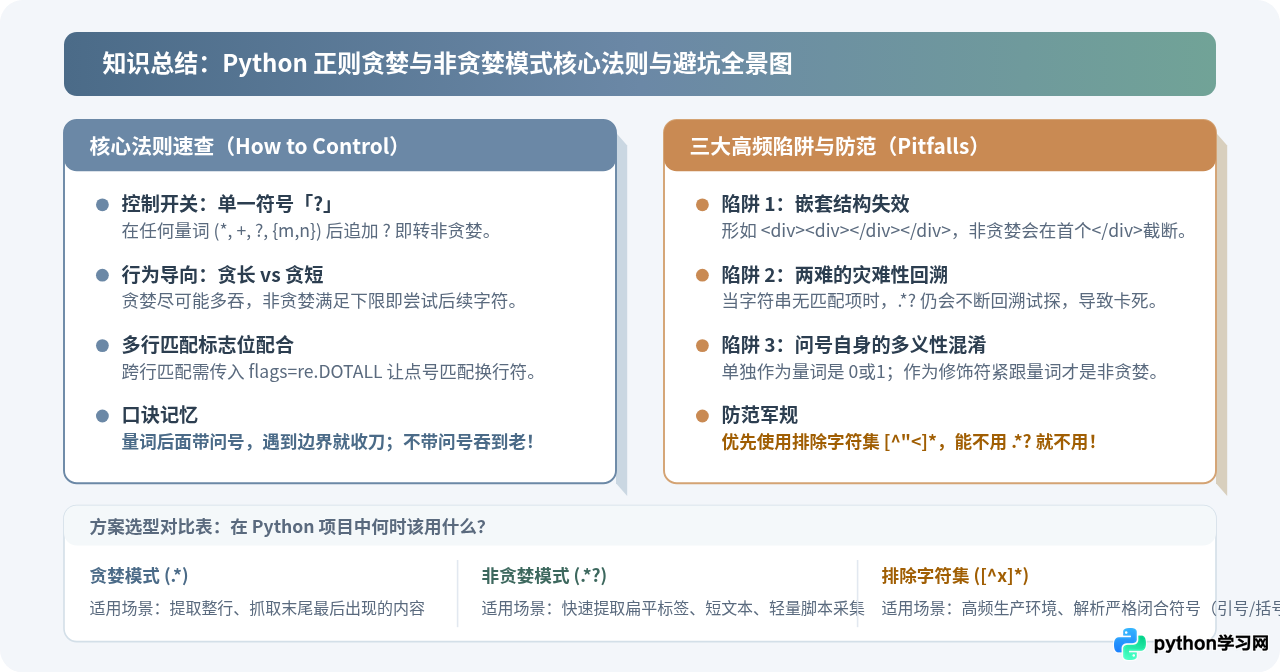
在日常开发与 Code Review 中,请牢记以下三条黄金原则:
- 一个问号定乾坤:在
*、+、?、{m,n}之后添加?是控制非贪婪的唯一标准语法。注意紧密相连,中间不能包含空格。 - 能用排除字符集,就不用通配非贪婪:在解析带有明确单字符闭合边界的格式(如引号、尖括号、方括号)时,优先编写形如
<[^>]+>、"[^"]*"的表达式,天然具备非贪婪效果且零回溯负担。 - 慎用跨行全局通配:当开启
re.DOTALL旗标处理上万行大文件时,务必谨慎使用.*?,必须配合明确的前后锚点,防止出现匹配卡死与内存溢出。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















