


Python爬虫被反爬怎么办?常见User-Agent检测与IP封禁应对策略
深入解析Python爬虫常见的User-Agent检测与IP封禁机制,提供规范的请求头伪装、随机UA轮换、访问节奏控制与高匿代理池架构实战应对策略。
在编写Python网络爬虫的过程中,最常遇到的两道防线是“请求身份标识异常”与“高频请求触发阈值”。前者通常体现为目标服务器直接识别出默认脚本特征并拒绝响应;后者则体现为单IP单位时间内发起的请求量超出正常人类浏览极限,导致IP被临时拉黑或永久封禁。解决这类问题的核心路径十分明确:第一步规范化HTTP请求头信息,消除脚本默认特征并构建真实的User-Agent轮换;第二步调控访问节奏,并引入高匿代理IP池实现网络出口的分散调度。本文将围绕这两种最典型的反爬机制,提供从排查、伪装到架构级防御的完整实战策略。
一、反爬拦截的常见表现与诊断步骤
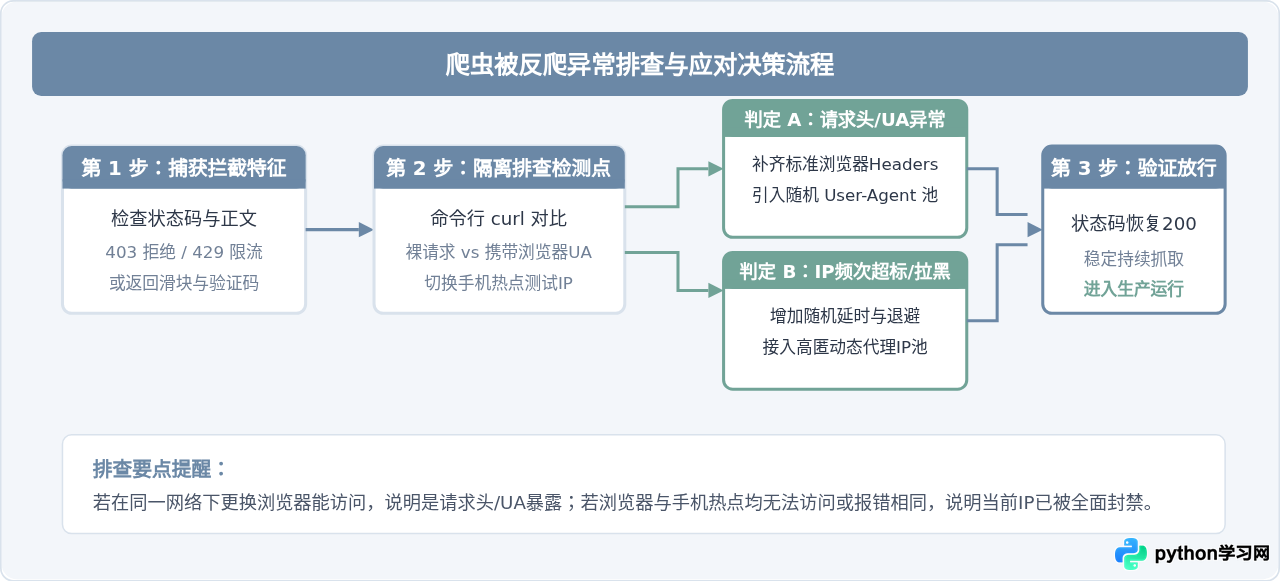
当爬虫程序突然拿不到预期的数据时,切忌盲目更换代码或反复重试。第一步必须通过HTTP状态码和返回的HTML内容,精确区分当前是哪一种检测手段在起作用。
- HTTP 403 Forbidden:服务器理解请求但拒绝执行。这往往是基础反爬规则生效的标志,例如请求头完全缺失、包含默认爬虫标识,或者IP已被加入黑名单。
- HTTP 429 Too Many Requests:客户端在给定时间内发送了过多请求。这是典型的速率限制(Rate Limiting)信号,说明目标系统已经记录了该IP的高频行为。
- HTTP 503 / 502 重定向到验证码页面:返回的内容不再是JSON或目标页面HTML,而是Cloudflare、阿里云WAF等安全厂商的5秒盾、滑块验证或文字点选页面。
遇到拦截后,推荐按照“独立终端复现 → 单独测试请求头 → 切换网络环境测试IP”的三步法进行隔离排查。通过逐步排除变量,可以迅速定位当前瓶颈是出在请求特征上,还是出在网络出口IP上。
二、User-Agent 检测机制与完整伪装方案
User-Agent(简称 UA)是 HTTP 协议中用于向服务器标识客户端操作系统、浏览器内核及版本的核心请求头字段。
1. 为什么默认的爬虫代码会直接暴露?
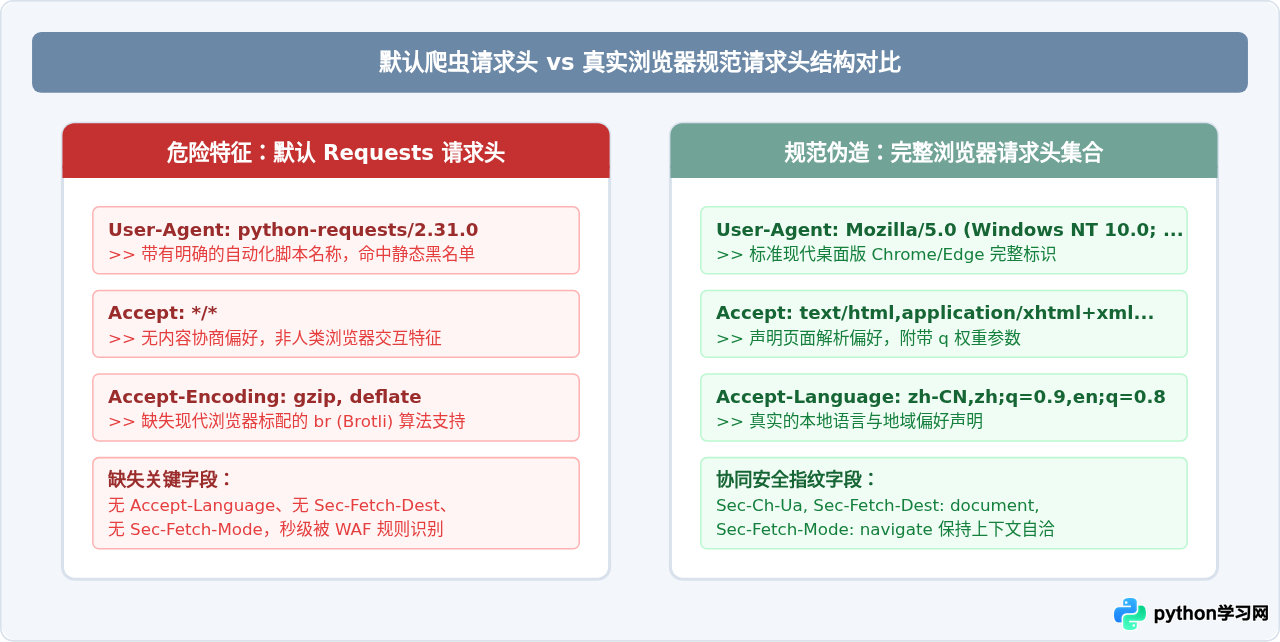
主流的 Python 网络库在发起请求时,都会默认携带带有库名和版本信息的 UA。例如:
requests库默认发送:User-Agent: python-requests/2.31.0urllib库默认发送:User-Agent: Python-urllib/3.11aiohttp库默认发送:User-Agent: Python/3.11 aiohttp/3.8.5
对于网站运维人员或 Web 应用防火墙(WAF)而言,只需编写一行简单的正则规则(如匹配 *python* 或 *urllib*),就能在握手后毫秒级直接丢弃连接或返回 403。
2. 仅修改 User-Agent 为何仍然被识别?
不少初学者仅将 UA 替换为 Chrome 字符串,却依然遭遇拦截。原因在于现代浏览器发出的请求是一个完整的“头部生态”,单一的 UA 无法掩盖缺失的上下文特征。现代浏览器(如 Chromium 体系)在发送 GET 请求时,通常会同时携带如下几组关键头部:
Accept:指示客户端能够处理的内容类型,例如text/html,application/xhtml+xml,application/xml;q=0.9...。默认 requests 的*/*极易暴露。Accept-Language:指示语言偏好,如zh-CN,zh;q=0.9,en;q=0.8。正常用户访问中文站点必带该字段。Accept-Encoding:通常为gzip, deflate, br。Sec-Ch-Ua系列头(Client Hints):现代 Chrome 浏览器会携带Sec-Ch-Ua,Sec-Ch-Ua-Mobile,Sec-Ch-Ua-Platform,如果 UA 声称是 Chrome 120 但完全缺失这些头,就会被判定为伪造指纹。
3. 实战方案:维护真实 UA 池与请求头封装
在实际代码中,应通过维护一份真实的现代浏览器 User-Agent 列表,并在每次请求或创建 Session 时随机选取;同时配套标准的请求头骨架。
import random
import requests

# 常用现代主流浏览器 User-Agent 池
USER_AGENTS = [
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/123.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:125.0) Gecko/20100101 Firefox/125.0",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 14.4; rv:124.0) Gecko/20100101 Firefox/124.0",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 14_4_1) AppleWebKit/605.1.15 (KHTML, like Gecko) Version/17.4.1 Safari/605.1.15"
]

def build_headers():
    ua = random.choice(USER_AGENTS)
    headers = {
        "User-Agent": ua,
        "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8",
        "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
        "Accept-Encoding": "gzip, deflate",
        "Connection": "keep-alive",
        "Upgrade-Insecure-Requests": "1"
    }
    # 针对 Chrome 添加对应的 Client Hints 头保持真实性
    if "Chrome" in ua:
        headers["Sec-Ch-Ua"] = '"Chromium";v="124", "Google Chrome";v="124", "Not-A.Brand";v="99"'
        headers["Sec-Ch-Ua-Mobile"] = "?0"
        headers["Sec-Ch-Ua-Platform"] = '"Windows"' if "Windows" in ua else '"macOS"'
        headers["Sec-Fetch-Dest"] = "document"
        headers["Sec-Fetch-Mode"] = "navigate"
        headers["Sec-Fetch-Site"] = "none"
        headers["Sec-Fetch-User"] = "?1"
    return headers

# 使用示例
session = requests.Session()
response = session.get("https://httpbin.org/headers", headers=build_headers(), timeout=10)
print("响应状态码:", response.status_code)
三、IP 封禁机制与代理 IP 池应对策略
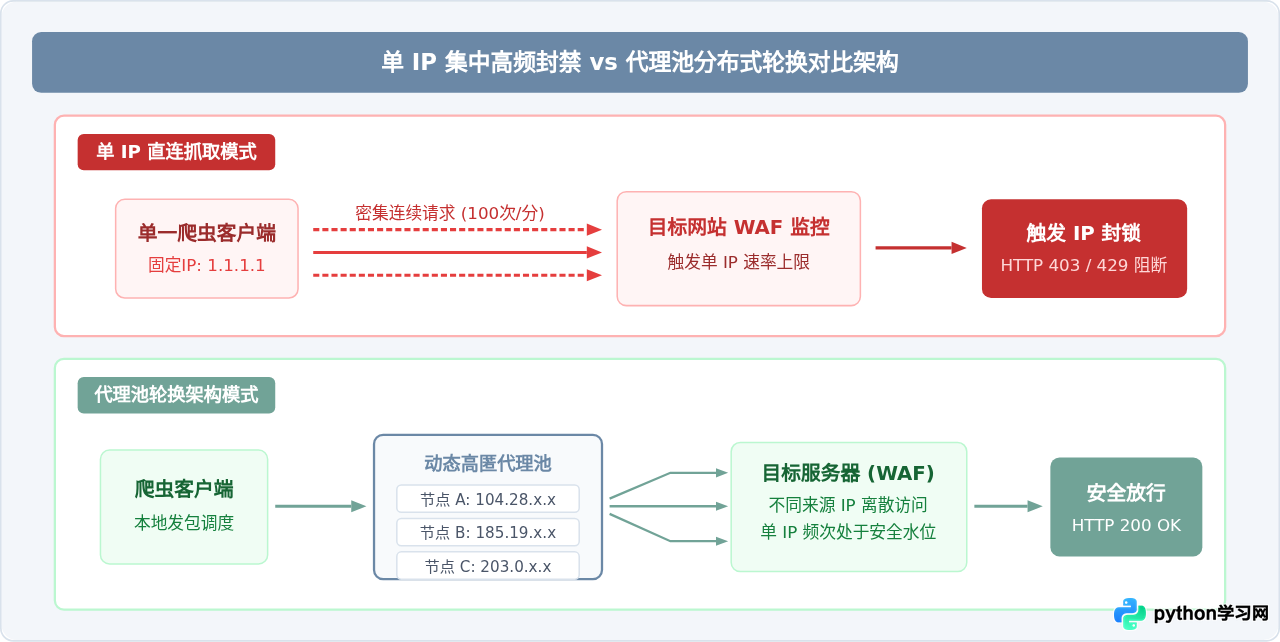
即使将请求头伪装得天衣无缝,只要请求全部来自于同一个公网 IP,在持续抓取时仍会迅速撞墙。这是因为服务器有能力基于客户端的 IP 地址进行流量统计与行为建模。
1. IP 封禁的核心触发场景
服务端的安全防护策略(如 Nginx 限速模块 limit_req_zone、WAF 或风控平台)通常监控以下几个关键维度:
- 单位时间请求频次过高:例如单 IP 每秒发出超过 10 次请求,远远超越了正常人点击阅读网页的极限。
- 访问规律过于机械:每隔精确的 500 毫秒访问一次,没有正常用户的滚动、停留或间隔停顿。
- 只访问数据接口而不加载静态资源:只密集抓取
/api/v1/detail,却从未请求过 CSS、JS 或图片等静态资源。
2. 基础调控:访问节奏与随机延迟
在引入代理 IP 之前,首先必须让爬虫具备“文明抓取”的节奏。通过引入随机停顿(Jitter)与指数退避,可以解决 70% 以上中小网站的轻量级限流。
import time
import random

# 在每次循环请求后加入 1.5 到 3.5 秒的随机延时
sleep_time = random.uniform(1.5, 3.5)
time.sleep(sleep_time)
3. 架构级方案:高匿代理 IP 池轮换调度
面对具有严格 IP 访问配额的站点,单个 IP 无论怎么减慢速度,总抓取量都会受到硬性限制。此时唯一的工程级解法是构建代理 IP 池,将请求流量分散到成百上千个不同的公网出口节点。
必须选用“高匿代理”(Elite / High Anonymity Proxy):
| 代理类型 | REMOTE_ADDR | HTTP_VIA | HTTP_X_FORWARDED_FOR | 防反爬效果 |
|---|---|---|---|---|
| 透明代理 (Transparent) | 代理服务器 IP | 显示代理标识 | 显示爬虫真实 IP | 完全无效,服务器仍能看到真实 IP |
| 普通匿名代理 (Anonymous) | 代理服务器 IP | 显示代理标识 | 隐藏真实 IP | 较弱,服务器虽不知真实IP,但能识别出你在使用代理 |
| 高匿代理 (High Anonymity) | 代理服务器 IP | 不包含该字段 | 不包含该字段 | 极佳,服务器完全将代理视为普通客户端 |
4. 实战代码:集成代理池与失败重试调度器
一个健壮的爬虫不应仅仅在发请求时传入单个 proxies 参数,而必须具备针对代理超时、连接失败或代理失效时的自动摘除与重试机制:
import requests
import random
import time

# 模拟高匿代理池列表(生产中通常由后台健康探测器动态维护与刷新)
PROXY_POOL = [
    "http://user:pass@104.28.19.12:8080",
    "http://user:pass@185.199.110.153:8080",
    "http://user:pass@198.51.100.45:8080",
    "http://user:pass@203.0.113.88:8080"
]

def fetch_with_proxy(url, max_retries=3):
    """
    通过代理池安全抓取数据,支持错误自动轮换与指数重试
    """
    for attempt in range(1, max_retries + 1):
        # 随机抽取可用代理
        proxy_url = random.choice(PROXY_POOL)
        proxies = {
            "http": proxy_url,
            "https": proxy_url
        }
        headers = build_headers() # 复用前面的动态请求头

        try:
            print(f"[Attempt {attempt}] 尝试通过代理 {proxy_url.split('@')[-1]} 请求...")
            response = requests.get(url, headers=headers, proxies=proxies, timeout=8)

            # 若触发限流或反爬特征码,主动视为失败并切换代理
            if response.status_code in [403, 429, 503]:
                print(f"触发反爬状态码 {response.status_code},切换新代理重试...")
                time.sleep(1.5 * attempt)
                continue

            response.raise_for_status()
            return response.text

        except (requests.exceptions.ProxyError, requests.exceptions.ConnectTimeout, requests.exceptions.ReadTimeout) as err:
            print(f"代理节点异常 ({err.__class__.__name__}),正在进行第 {attempt} 次重试...")
            time.sleep(1.0 * attempt)

    raise RuntimeError(f"在经过 {max_retries} 次代理切换重试后,URL仍抓取失败: {url}")
四、反爬攻防中的四个典型认知误区
在处理反爬问题时,常常会因为片面的理解而走入死胡同。以下是四个极易发生的错误操作与避坑建议:
- 误区一:网购万能“免费代理列表”。网络上公开的免费代理通常存活率不足 10%,绝大部分处于高延迟、已被各大知名站点列入封锁黑名单的状态,甚至可能存在中间人流量窃听风险。生产环境建议优先选择正规隧道代理或按量计费的动态住宅代理。
- 误区二:只换 UA 字符串,不换平台指纹。例如将 UA 改成了
Macintosh; Intel Mac OS X,但同时发送了 Windows 系统的默认字体或Sec-Ch-Ua-Platform: "Windows",前后盾直接识别出逻辑矛盾。 - 误区三:误将 404/500 当作反爬虫。如果是 URL 拼写错误或服务端内部程序报错,无论怎样更换代理与 UA 都无济于事。遇到问题务必先用无头浏览器或本地桌面浏览器人工确认接口真实可用性。
- 误区四:加线程而不加代理。多线程爬虫在没有代理池支撑的情况下,会瞬间成倍放大单个 IP 的请求频率,不仅无法加速,反而会加速自身 IP 被锁定封禁。并发数必须与可用高匿 IP 的数量相匹配。
五、反爬防御应对策略全景总结
解决 Python 爬虫被反爬的问题,本质上是一场在成本、复杂度与采集需求之间的动态权衡。应对措施并非只有一种,而是呈现从简单到高阶的阶梯形态:
- 第一层:消除特征(成本最低):彻底替换默认请求头,补齐浏览器标配的
Accept、Accept-Language与Client Hints,使用真实 UA 轮换池。 - 第二层:调控行为(必做基础):放弃极限并发,加入符合人类点击规律的随机停顿,实现 429 状态码的自动退避重试。
- 第三层:分散网络(生产级核心):搭建或接入动态高匿代理池,通过隧道代理自动轮转出口 IP,将海量请求稀释到安全水位。
- 第四层:环境对抗(高阶防线):针对严苛的 JS 加密、Canvas/WebGL 指纹与复杂验证码,结合 Playwright/Selenium 等自动化工具,配合指纹插件(如 stealth)实现全链路拟真。
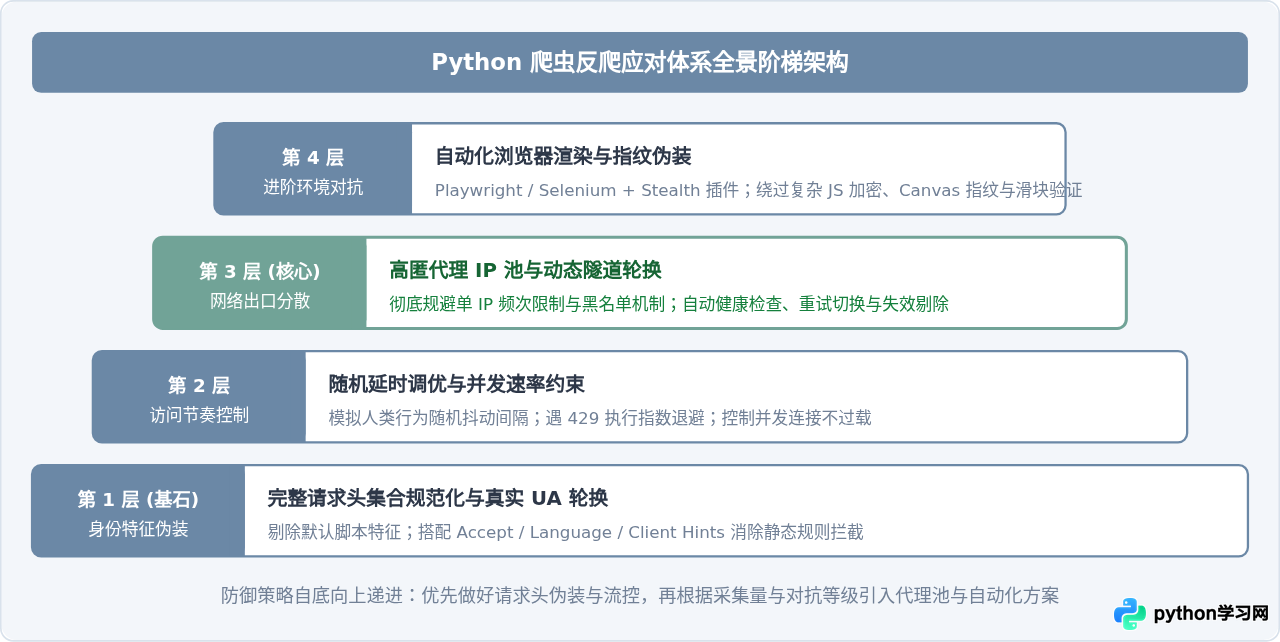
只要严格按照“从请求头排查到网络层分散”的顺序推进,绝大多数中高难度爬虫任务的反爬阻碍都能迎刃而解,实现稳定、可持续的数据抓取。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















