
Python读取CSV中文乱码怎么办?encoding编码设置指南
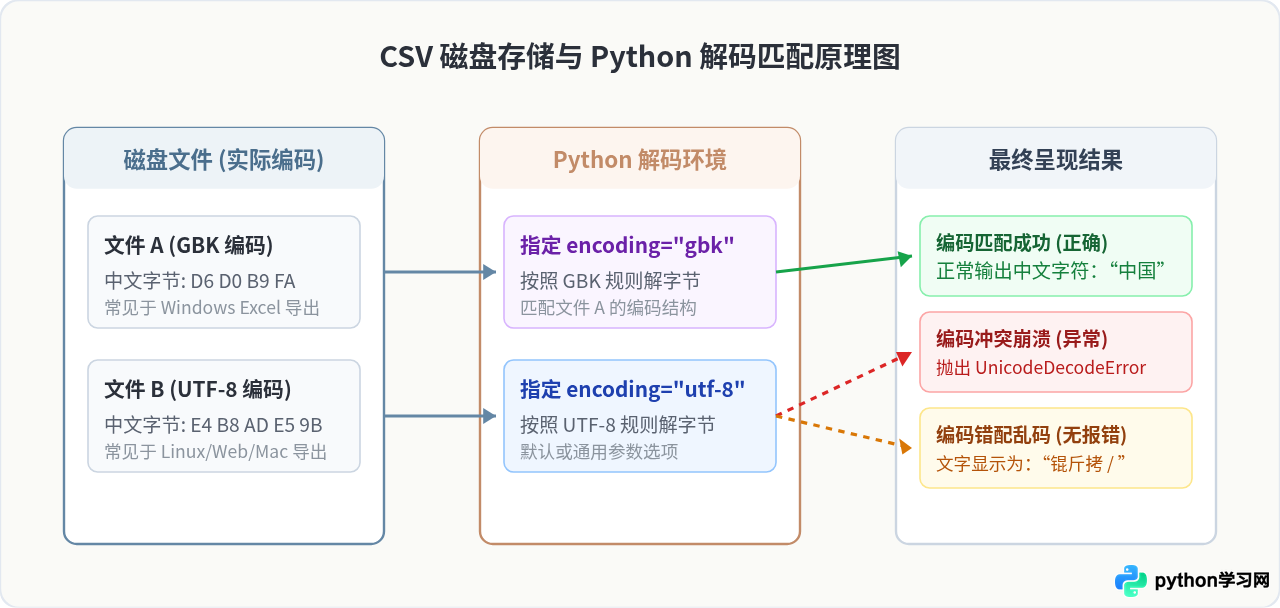
针对Python读取CSV文件时常见的中文乱码问题与UnicodeDecodeError报错,详细梳理UTF-8、UTF-8-SIG、GBK及GB18030的编码机制,提供标准库csv与Pandas的encoding参数配置方案、排查四步法与选型速查。



针对Python读取CSV文件时常见的中文乱码问题与UnicodeDecodeError报错,详细梳理UTF-8、UTF-8-SIG、GBK及GB18030的编码机制,提供标准库csv与Pandas的encoding参数配置方案、排查四步法与选型速查。
本文介绍如何使用Python的pandas库导入CSV文件。涵盖默认导入、指定分隔符(sep)、限制读取行数(nrows)以及处理编码格式(encoding)等关键参数。同时提供解决中文列标题对齐问题的set_option方法,帮助开发者高效处理不同格式的CSV数据。
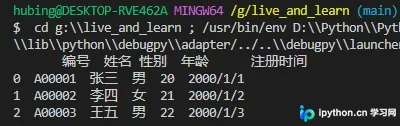
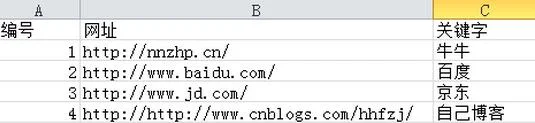
本文详细介绍Python中如何使用csv模块读取和写入CSV文件。通过两个读取示例(手动关闭与with语句)及一个写入示例,展示如何逐行读取数据及将列表或元组写入文件。适用于Python3.x环境,帮助开发者快速掌握基础文件操作技能。
深入对比Python中内置csv模块、NumPy与Pandas读取结构化CSV数据的性能差异与底层机制,涵盖10万与100万行基准测试、内存开销剖析与工程选型建议。
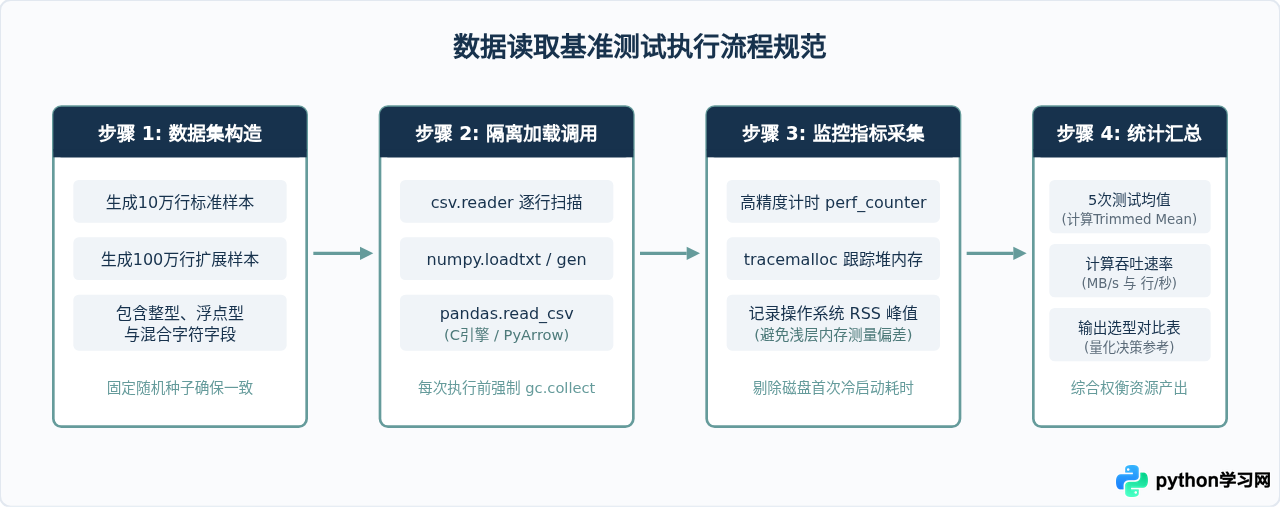
深入对比Python内置csv模块与第三方数据分析库Pandas在写入CSV文件时的性能表现、内存占用机制与开销差异,并给出清晰明确的工程选型决策路径与代码调优建议。
本文介绍如何使用Python的Pandas库将CSV文件高效导入SQLite3数据库。通过示例代码展示利用read_csv读取数据,并借助to_sql方法将数据写入指定表,相比传统Shell模式操作更为便捷,适合初学者参考。
面对数GB甚至更大的CSV文件,Python数据导入常见瓶颈并不只来自文件读取,还涉及解析方式、内存占用、数据类型推断、磁盘与CPU吞吐等环节。本文将从性能定位、导入方式优化、内存控制和结果验证几个方面,系统分析大规模CSV导入中的常见问题与优化方法。
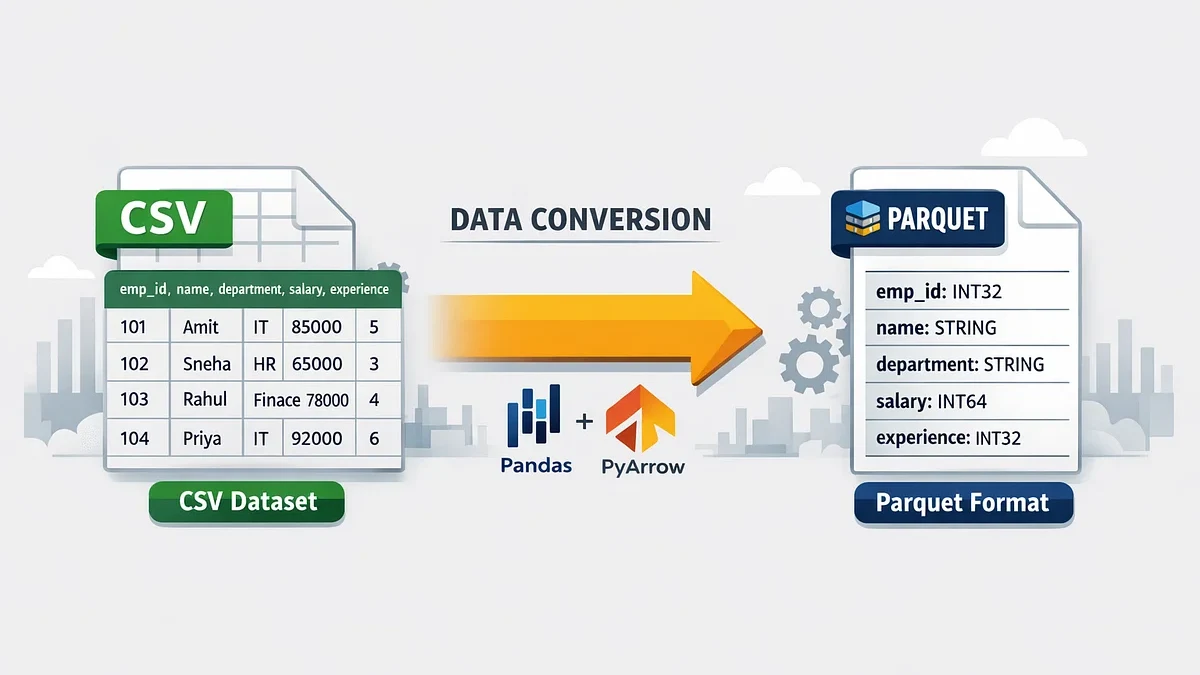
本文介绍如何使用Python脚本结合pandas库与SQLAlchemy引擎,实现将本地CSV文件快速批量插入数据库的功能。脚本通过命令行接收文件名和表名,利用copy_from方法高效处理数据写入,适用于PostgreSQL等支持COPY命令的数据库场景。
本文详细介绍在 Python 中导入 CSV 文件的三种常用方法。首先通过标准库 csv 结合 NumPy 数组处理基础数据;其次利用 NumPy 的 loadtxt 函数处理无表头且类型统一的数据;最后重点推荐 Pandas 库的 read_csv 函数,因其返回 DataFrame 结构,便于后续数据清洗与机器学习建模,是实际开发中的首选方案。
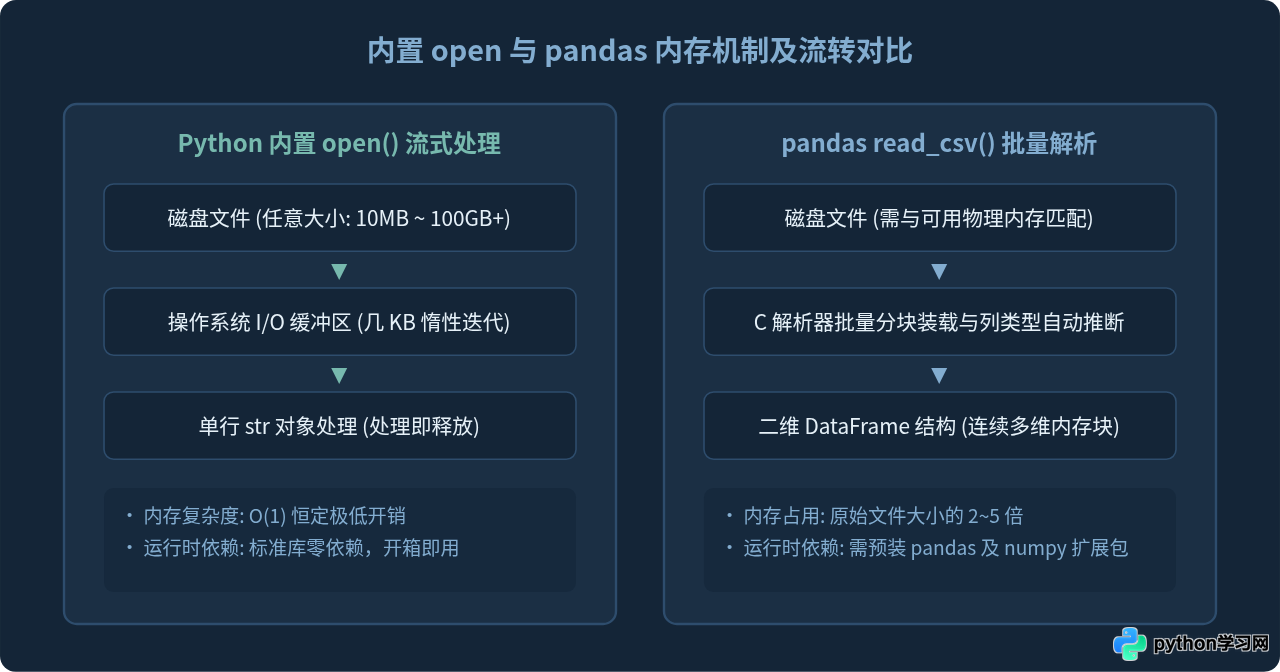
深入对比Python原生内置open函数与pandas库读取txt文本文件的底层机制、内存表现、性能差异与适用场景,提供系统化的工程选型决策建议与实践代码。
本文详细介绍如何使用Python将CSV文件数据导入MySQL数据库,以及将MySQL数据导出为CSV文件。通过pymysql库建立连接,利用csv模块处理数据读写,涵盖建表语句、插入逻辑及查询写入示例,帮助开发者快速掌握数据库与CSV文件交互的核心方法。
本文介绍如何使用Python将CSV文件中的数据读取并导入MySQL数据库。通过示例代码展示连接数据库、解析CSV文件及执行插入语句的具体步骤,帮助开发者快速实现数据迁移功能。



