


Python内置open与pandas读取txt的区别及选型建议
深入对比Python原生内置open函数与pandas库读取txt文本文件的底层机制、内存表现、性能差异与适用场景,提供系统化的工程选型决策建议与实践代码。
假设你正在处理一份大小为 3GB 的服务器访问日志 access.log.txt,需要统计出现频率最高的 IP 地址;或者面对一份由业务系统导出的非规则报表文本,前十几行记录着批次说明与参数配置,末尾附带校验摘要。面对这些文本处理任务,开发者最常提出的问题是:究竟应当使用 Python 原生内置的 open() 函数逐行读取,还是直接调用 pandas.read_csv()?
核心结论非常明确:Python 内置 open() 胜在轻量、零依赖、内存占用极低且对任意文本格式具备高度掌控力;而 pandas 则是规整结构化表格解析与批量分析的性能利器。选择的关键并不在于哪个工具“更高级”,而取决于文件的结构规整度、数据体量相对于可用内存的比例,以及后续是否需要复杂的列式数学计算。本文将系统拆解两者的底层机制、操作规范及关键差异,并给出清晰的工程选型路径。
一、底层机制与内存模型差异
理解两者的核心区别,首先需要厘清它们在数据流动与内存分配机制上的根本分歧。
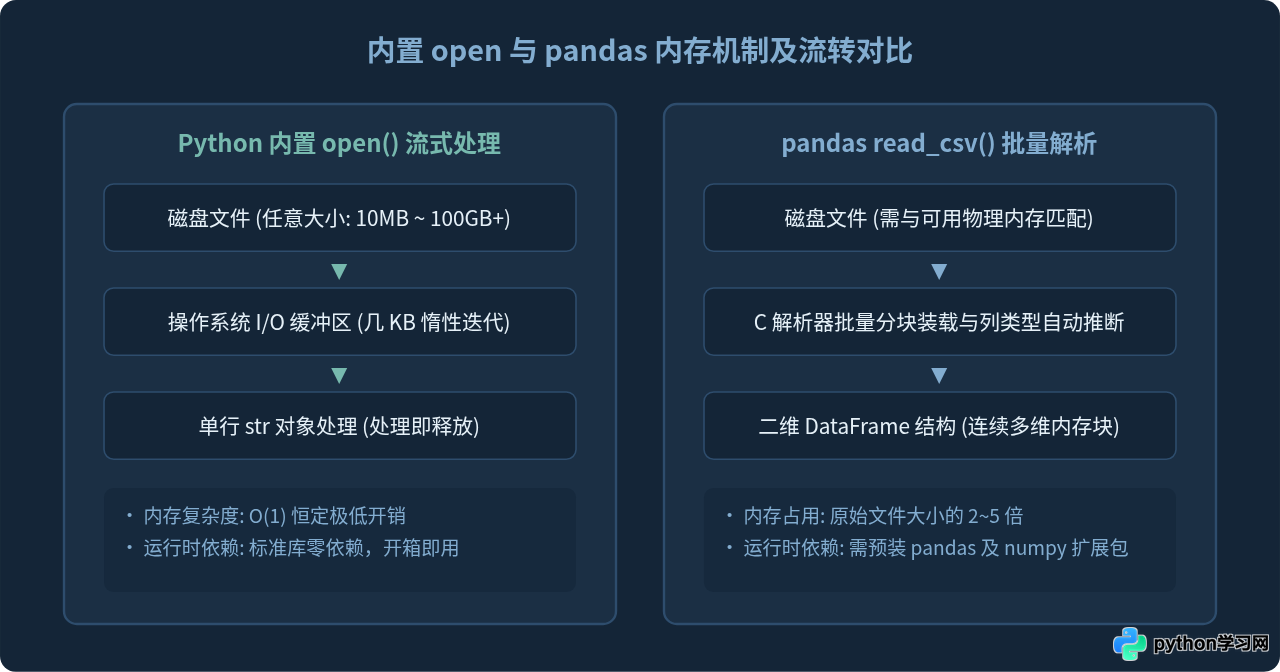
open() 是 Python 核心运行时的标准内置组件,调用时在操作系统与解释器之间建立标准文件描述符句柄。在流式读取模式下(如遍历文件对象),Python 只在内存中维护极小的 I/O 缓冲区(通常为几十 KB 至几百 KB)。每读取一行,生成一个 str 对象,处理完毕后即可被垃圾回收器回收。整个过程的内存复杂度为常数级别 O(1),即便处理数百吉字节(GB)的日志文件,进程内存也可以稳定控制在极低水平。
相比之下,pandas.read_csv()(或 read_table())是面向列式分析的重型解析引擎。底层通常由高性能 C 语言或 PyArrow 解析模块驱动。在默认配置下,它尝试一次性扫描目标文件,按指定分隔符将整块字符切分并推断每列的数据类型(如整型、浮点型、对象型),最终在连续内存区域构建由 numpy.ndarray 支撑的二维 DataFrame。由于需要同时保留原始文本缓冲、转换元数据以及最终的矩阵结构,其驻留内存通常可达到原始文件体积的 2 到 5 倍。一旦文本体积接近或超出物理内存容量,就会迅速引发操作系统交换分区频繁读写甚至内存溢出崩溃(OOM)。
二、核心操作步骤与代码实践
为了让差异更具可操作性,下面分别展示两者的标准代码模版与关键参数使用规范。
1. 使用内置 open 进行流式读取与定制清洗
使用 open() 时,必须使用 with 上下文管理器确保句柄安全释放。切忌调用 f.readlines(),因为该方法会将全部行读入内存列表,直接抵消了原生读取的流式优势。正确的做法是直接迭代文件对象:
# 示例 1: 使用 open 进行逐行流式读取与容错清洗
log_file_path = "server_log.txt"
ip_counts = {}

with open(log_file_path, mode="r", encoding="utf-8", errors="replace") as file:
    for line_num, raw_line in enumerate(file, start=1):
        line = raw_line.strip()
        # 跳过空行或注释行
        if not line or line.startswith("#"):
            continue

        # 按照约定分隔符拆分
        parts = line.split("\t")
        if len(parts) < 3:
            # 容忍格式异常行,避免整体流程中断
            continue

        ip_address = parts[0]
        ip_counts[ip_address] = ip_counts.get(ip_address, 0) + 1

# 输出统计前几位结果示例
top_ips = sorted(ip_counts.items(), key=lambda x: x[1], reverse=True)[:5]
print("访问前五的 IP 统计结果:", top_ips)
2. 使用 pandas 解析结构化文本
当文本内容符合统一的分隔规则时(例如制表符分隔的 .txt 实际等价于 TSV 文件),pandas.read_csv() 可以极大减少数据结构转换代码:
# 示例 2: 使用 pandas 进行表格化批量加载与统计
import pandas as pd

tsv_file_path = "user_behavior.txt"

# 通过指定分隔符、列名及缺失值标识加载文本
df = pd.read_csv(
    tsv_file_path,
    sep="\t",
    names=["user_id", "action", "timestamp", "duration"],
    header=None,
    encoding="utf-8",
    na_values=["-", "NULL", "none"],
    on_bad_lines="skip"  # 跳过异常脏数据行
)

# 快速完成列式统计与分组聚合
summary = df.groupby("action")["duration"].mean()
print(summary)
若文件体积较大但仍需要使用 pandas 的计算能力,必须采用 chunksize 参数分块读取:
# 示例 3: pandas 大文件分块迭代处理模式
chunk_size = 50000
total_users = set()

for chunk in pd.read_csv("large_data.txt", sep="\t", chunksize=chunk_size):
    # 针对每个数据块进行局部计算
    valid_ids = chunk["user_id"].dropna().unique()
    total_users.update(valid_ids)

print("独立用户总数:", len(total_users))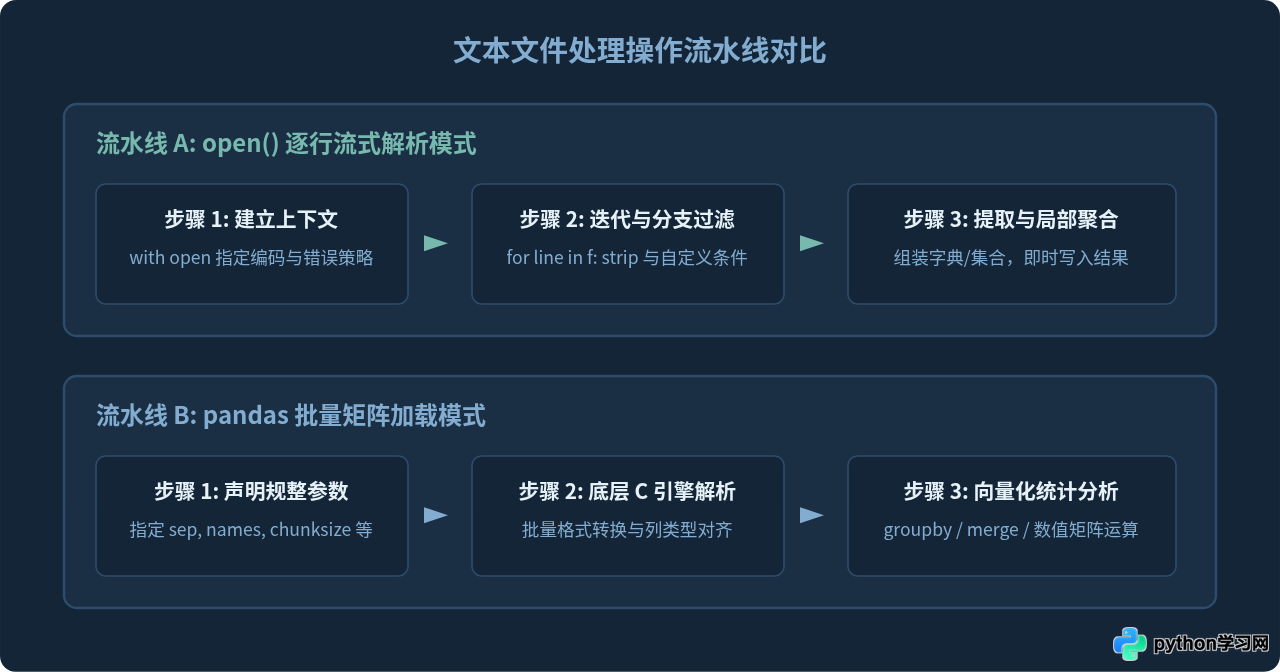
三、多维度关键差异对比
为了在方案评审或日常开发中快速判断,可从以下六个工程维度进行量化与对照:
| 对比维度 | Python 内置 open() | pandas.read_csv() / read_table() |
|---|---|---|
| 环境与依赖 | 标准库原生支持,零依赖,跨环境与无外网环境兼容极佳。 | 需要安装 pandas 及底层 numpy,包体积与版本依赖较重。 |
| 内存资源占用 | 极低且平稳(通常 < 50MB),与文件总大小完全无关。 | 较高,为文件体积的 2 到 5 倍;受物理可用内存严格限制。 |
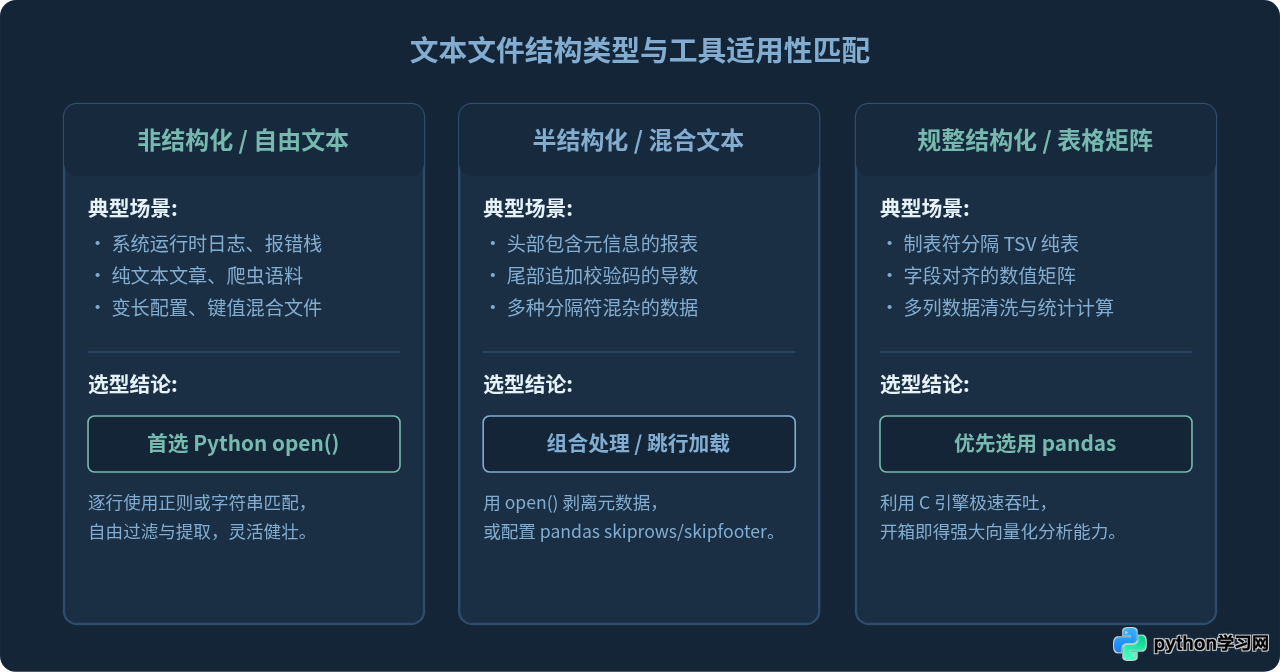
| 格式规整性要求 | 极低。支持不规则格式、混合结构文本、动态长度行与日志。 | 极高。必须有统一分隔符且列数基本对齐,异构文本极易报错。 |
| 脏数据容错能力 | 完全掌控。可在循环内自由编写条件分支过滤或修正单行。 | 主要依赖 on_bad_lines 参数跳过,精细修复成本高。 |
| 规整数据读取性能 | 在纯 Python 层面循环切分较慢,解释器开销明显。 | 底层 C / C++ 引擎快速批量解析,规整数据吞吐速度极快。 |
| 后续数据分析便利度 | 得到的是基础字符串或列表,复杂统计需手写大量代码。 | 直接生成 DataFrame,开箱支持丰富的切片、分组、聚合与导出。 |
四、工程选型决策路径与避坑指南
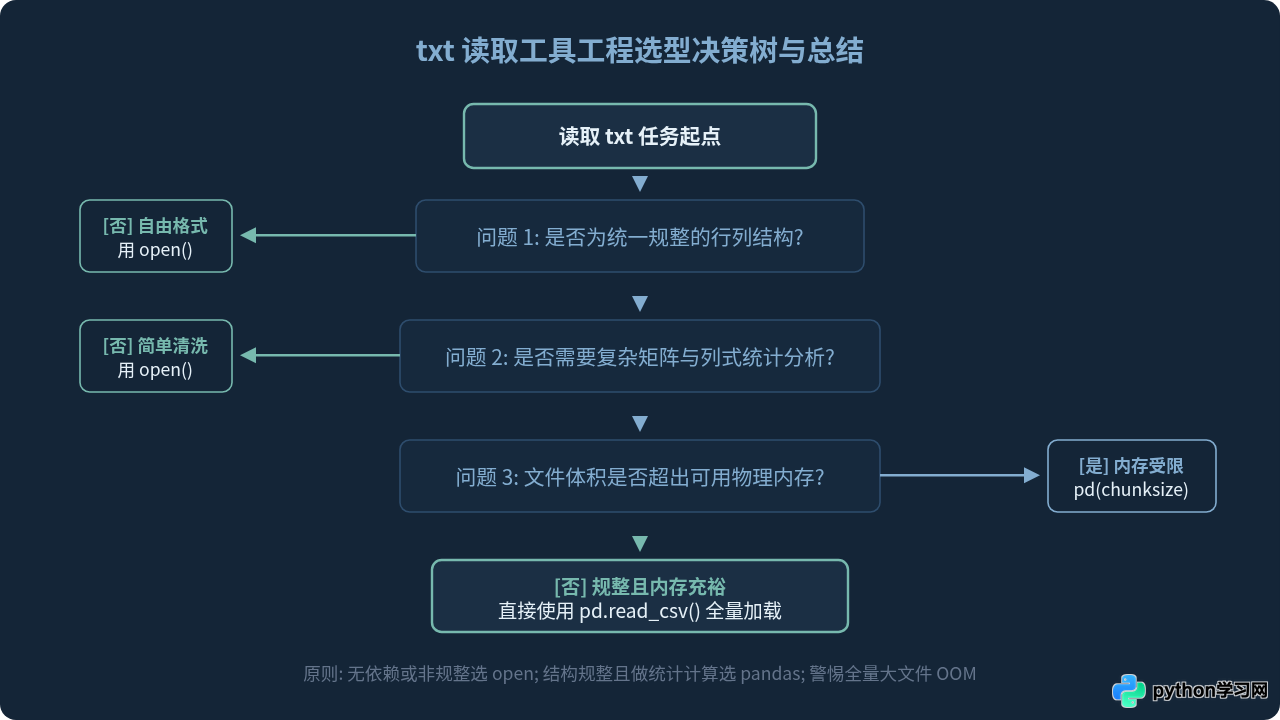
在真实业务工程中,读者可以遵循以下四步决策流程快速锁定最优方案:
- 检查文本行结构是否严格齐整:如果每行具有固定的字段数量、明确的分隔符且无复杂嵌套,可进入下一步评估;若数据结构不固定、掺杂非格式化文本或单行异常率较高,应毫不犹豫选择
open()。 - 评估运行环境与依赖限制:在轻量级定时巡检脚本、AWS Lambda 等 Serverless 算力单元或受限的容器环境中,安装重型第三方库会显著增加镜像体积与冷启动延迟。若无重型统计需求,应首选内置
open()。 - 对比数据体量与物理内存:若文件大小仅在几十 MB 到数百 MB 级别,内存完全充裕,两者均可胜任;若文件体量超过 1GB 且接近可用 RAM 阈值,必须警惕 pandas 的全量加载风险。此时要么采用
open()流式处理,要么在pd.read_csv()中配置chunksize。 - 明确后续分析需求:如果后续操作仅是过滤某几个字段写出新文件、统计简单计数或入库,原生代码即可高效搞定;如果需要进行多表 Join、透视表分析或滑动窗口等复杂运算,pandas 能节省大量开发时间。
避坑提示:文本编码与换行符细节
在实际生产环境中,绝大多数读取失败来自编码不匹配(如 Windows 系统下导出的 GBK / GB2312 编码在默认环境报 UnicodeDecodeError),或带有 UTF-8 BOM 导致首列列名带 \ufeff。处理时建议显式指定 encoding="utf-8-sig" 或 encoding="gb18030";在遇到偶发坏字符时,使用 errors="replace" 或 errors="ignore" 可以防止整个批处理任务意外中断。
综上所述,Python 内置 open() 与第三方 pandas 并不是相互取代的竞争关系,而是各自服务于不同业务侧重的互补利器。理清数据形态与资源边界,按需选用,才能写出既稳定可靠又兼顾开发效率的高质量代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















