


Pandas DataFrame行列数据筛选详解:loc、iloc与ix用法解析

本文深入解析Pandas中DataFrame的行列数据筛选方法。通过对比df[]、df.loc、df.iloc及已弃用的df.ix,详细阐述基于标签与位置的索引逻辑。重点说明列选取时行索引不能为空的操作规范,以及混合索引类型的注意事项,帮助开发者高效处理表格数据。
一、对DataFrame的认知
DataFrame的核心结构由行索引(index)与列索引(column)共同构成,并承载多列数据。
为了更直观地理解其原理,我们可以转换视角进行思考。
在现实场景中,为了简化对复杂事物的描述,人们通常会选取若干关键特征。
例如,通过性别、身高、学历、职业及爱好等维度来刻画一个人,这些维度即被视为“特征”。
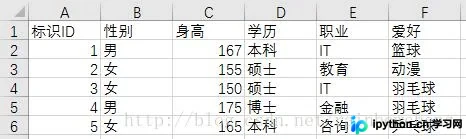
在DataFrame中,不同的行代表不同的数据记录;列则代表特征。由于各记录在各项特征上的取值存在差异,从而形成了独特的数据表现。
DataFrame默认的索引为从0开始的整数序列(0, 1, 2…),这可以理解为位置索引。在实际应用中,我们通常使用id来标识不同记录,且不会随意更改index。然而,为了清晰理解各特征(列)的具体含义,我们往往需要重新指定column名称。
这里提供一种简易但不完全严谨的理解模型:
行列
行 – index – 记录(通常沿用默认索引)
列 – column – 特征(采用自定义索引)
索引
默认索引 – 序号 – 位置 – 便于索引但直观性较差
自定义索引 – 特征名称 – 属性 – 更易于理解
二、对dataframe进行行列数据筛选
import pandas as pd,numpy as np
from pandas import DataFrame
df = DataFrame(np.arange(20).reshape((4,5)),column = list('abcde'))
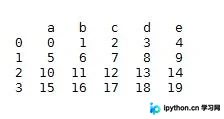
1. df[]与df. 选取列数据
df.a
df[[‘a','b']]
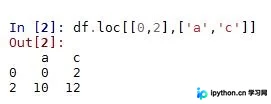
2. df.loc[[index],[column]] 通过标签选择数据
当不对行进行筛选时,[index]处必须填写冒号(:),不能留空。例如,df.loc[:,'a']表示选取a列的全部数据。
df.loc[0,'a']
df.loc[0:1,[‘a','b']]
df.loc[[0,2],[‘a','c']]
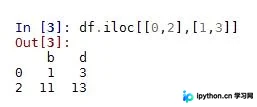
3. df.iloc[[index],[column]] 通过位置选择数据
当不对行进行筛选时,其用法与df.loc[]相同,即[index]处同样不能为空。
df.iloc[0,0]
df.iloc[0:1,1:3]
df.iloc[[0,2],[1,3]]
4. df.ix[[index],[column]] 通过标签或位置选择数据
df.ix[]混合了标签和位置选择。需要注意的是,[index]和[column]的框内需要指定同一类的选择。 df.ix[[0:1],[‘a',3]]报错
以上这篇pandas系列之DataFrame 行列数据筛选实例就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















