



在 TCP/IP 网络编程里,很多人先接触的是 `read`、`write` 这类系统调用,但实际写网络程序时,标准 I/O 也经常会被拿来配合套接字使用。问题不在于“能不能用”,而在于它为什么会更快、代价是什么,以及什么时候必须主动 `fflush` 才不会把数据卡在缓冲区里。下面就从缓冲机制、接口转换到回声程序示例,按使用过程把这件事讲清楚。
标准 I/O 为什么值得放进网络编程里
标准 I/O 的两个直接好处
标准 I/O 函数最常被提到的优点有两个:
- 具备良好的移植性(portability)。
- 可以借助缓冲机制提升性能。
移植性本身不难理解。只要是标准库提供的接口,通常都比依赖具体系统细节的写法更容易跨平台复用。真正值得展开的是第二点,也就是缓冲。
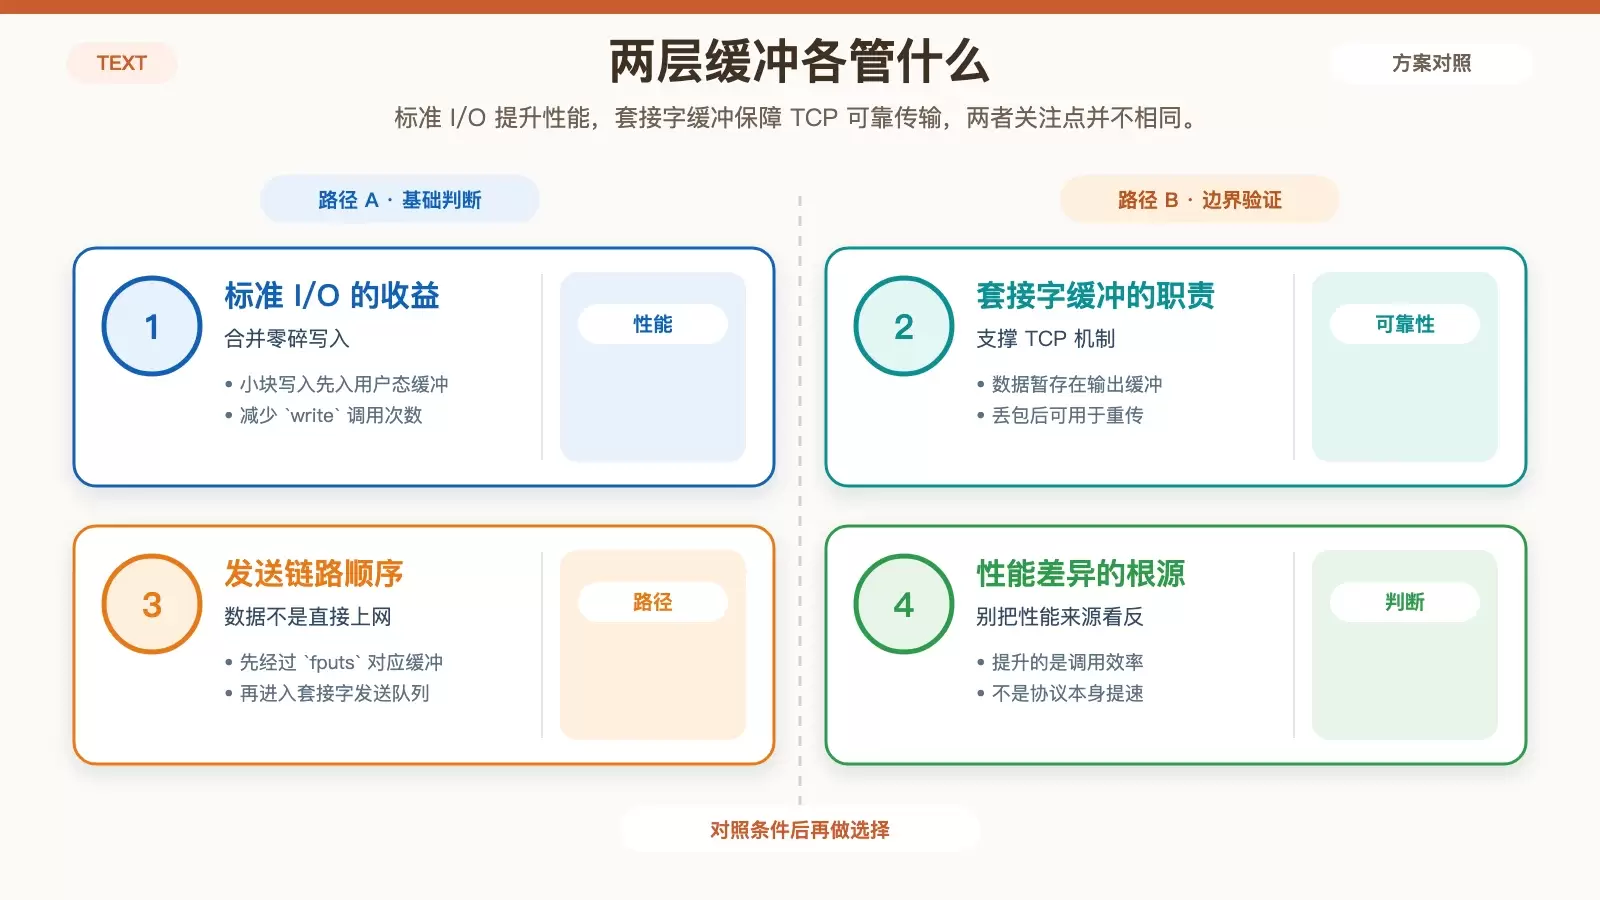
当程序创建套接字时,操作系统本身就会为 I/O 准备缓冲区,这一层缓冲是 TCP 正常工作的基础。若在此之上再使用标准 I/O 函数,那么数据在发送和接收过程中,还会再经过一层由标准库维护的缓冲区。
也就是说,用 `fputs` 之类的函数发送数据时,数据并不是立刻直接发到网络上,而是先进入标准 I/O 缓冲,再转移到套接字输出缓冲,最后才由协议栈发送给对端主机。
两层缓冲分别解决什么问题
这两层缓冲虽然都会“先存一下数据”,但用途并不相同。
套接字缓冲主要是为 TCP 协议服务的。比如 TCP 传输过程中如果发生丢包,需要重传,那么前提就是待发送的数据还保存在套接字输出缓冲中。没有这层缓冲,TCP 的可靠传输机制就无法成立。
标准 I/O 缓冲的重点则是减少系统调用次数,从而提升程序性能。举个典型场景:程序频繁调用 `fwrite` 写入很小的数据块时,这些数据会先进入用户空间缓冲区;只有缓冲区写满,或者程序显式调用刷新操作时,才会真正触发一次 `write` 系统调用。原本很多次零碎的小写入,就被合并成了少量大写入,系统调用开销自然会下降。
从这个角度看,标准 I/O 带来的性能提升,并不是“网络更快了”,而是程序和内核之间交互的次数减少了。
标准 I/O 与系统调用,性能差别体现在哪
对于大文件复制这类场景,标准 I/O 的缓冲优势通常很直观。原文给出的结论是:复制大于 300M 字节的文件时,直接使用系统函数的速度,明显慢于使用标准 I/O 函数。
下面先看使用系统调用复制文件的版本。
系统函数复制文件:`syscpy.c`
#include <stdio.h>
#include <fcntl.h>
#define BUF_SIZE 3

int main(int argc, char *argv[])
{
	int fd1, fd2, len;
	char buf[BUF_SIZE];

	fd1=open("news.txt", O_RDONLY);
	fd2=open("cpy.txt", O_WRONLY|O_CREAT|O_TRUNC);

	while((len=read(fd1, buf, sizeof(buf)))>0)
		write(fd2, buf, len);

	close(fd1);
	close(fd2);
	return 0;
}
这里用到的 `read` 和 `write` 都是系统调用。它们需要直接与操作系统内核交互,来完成对文件、设备或网络资源的读写,因此执行成本高于单纯的用户态函数调用。
尤其是在 `BUF_SIZE 3` 这样极小缓冲区的情况下,程序会频繁进入内核态,反复执行 `read` / `write`,性能自然不理想。
标准 I/O 复制文件:`stdcpy.c`
#include <stdio.h>
#define BUF_SIZE 3

int main(int argc, char *argv[])
{
	FILE * fp1;
	FILE * fp2;
	char buf[BUF_SIZE];

	fp1=fopen("news.txt", "r");
	fp2=fopen("cpy.txt", "w");

	while(fgets(buf, BUF_SIZE, fp1)!=NULL)
		fputs(buf, fp2);

	fclose(fp1);
	fclose(fp2);
	return 0;
}
这段代码表面上同样是小块读写,但 `fgets` 和 `fputs` 背后有标准库缓冲支撑,因此不需要每次都立刻发起系统调用。也正因为如此,在数据量足够大时,它通常能表现出更好的吞吐效率。
这里可以得到一个很实用的判断:如果程序存在大量零碎的读写操作,标准 I/O 往往更有优势;如果你需要更直接地控制文件描述符或系统级行为,系统调用会更合适。
标准 I/O 的短板:为什么它用起来没那么“直接”
标准 I/O 并不是只有优点,放到套接字场景里,它的几个缺点会变得尤其明显:
- 不容易进行双向通信。
- 某些场景下可能需要频繁调用 `fflush`。
- 标准 I/O 使用的是 `FILE` 结构体指针,而套接字默认返回的是文件描述符。
如果希望同一个打开对象既读又写,通常要以 `r+`、`w+`、`a+` 这类模式打开。但一旦读写状态来回切换,缓冲区内容和当前位置管理就会变复杂,因此往往需要在切换前后主动调用 `fflush`。这会削弱一部分缓冲带来的性能收益。
另外,网络编程里通过 `socket()` 创建出来的是文件描述符,不是 `FILE *`。这意味着只要想使用 `fgets`、`fputs`、`fprintf` 之类的标准 I/O 接口,就必须先完成一层转换。
如何在文件描述符和 `FILE*` 之间转换
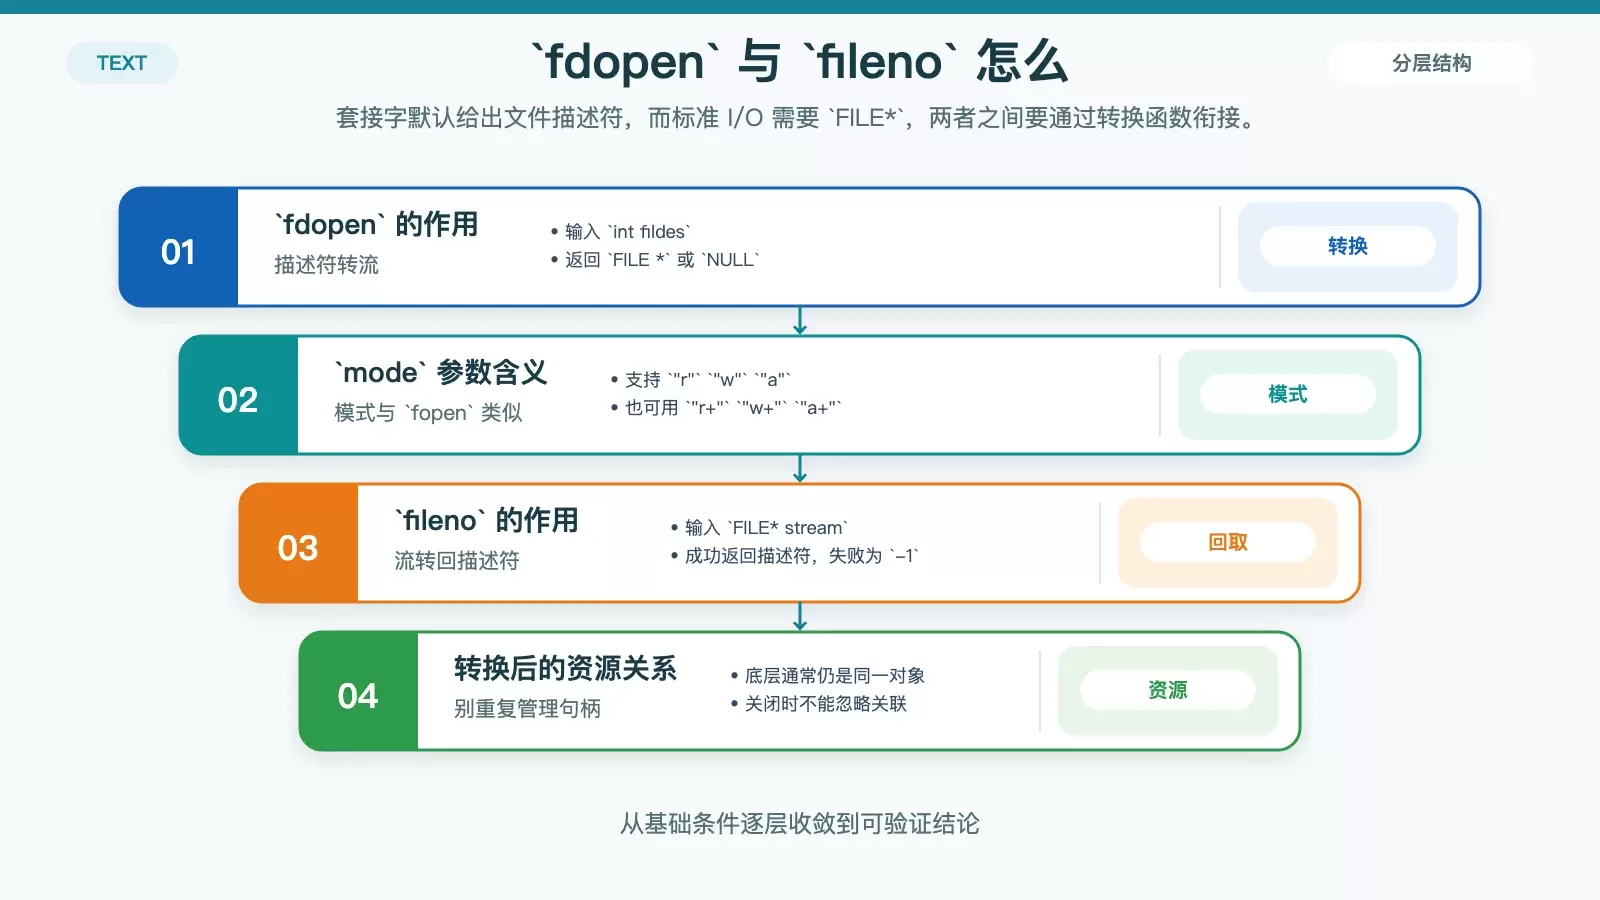
用 `fdopen` 把文件描述符包装成 `FILE*`
#include <stdio.h>
// 成功时返回转换的 FILE 结构体指针,失败时返回 NULL
FILE* fdopen(int fildes, const char* mode);
`fdopen` 的作用很直接:接收一个已经存在的文件描述符,再按指定模式把它转换成标准 I/O 流。
- `fildes`:要转换的文件描述符。
- `mode`:流的访问模式,写法和 `fopen` 类似,比如 `"r"`、`"w"`、`"a"`、`"r+"`、`"w+"`、`"a+"`。
示例代码如下:
#include <stdio.h>
#include <fcntl.h>

int main(void)
{
	FILE *fp;
	int fd=open("data.dat", O_WRONLY|O_CREAT|O_TRUNC);
	if(fd==-1)
	{
		fputs("file open error", stdout);
		return -1;
	}

	fp=fdopen(fd, "w");
	fputs("Network C programming n", fp);
	fclose(fp);
	return 0;
}
这段程序先通过 `open` 获得文件描述符 `fd`,再调用 `fdopen(fd, "w")` 得到 `FILE *fp`,之后就可以按标准 I/O 的方式写入数据。
要注意的是,关闭 `fp` 时本质上也会连带处理底层文件描述符,因此不能再把它当作一个完全独立的资源去重复关闭。
用 `fileno` 从 `FILE*` 取回文件描述符
#include <stdio.h>
// 成功时返回转换后的文件描述符,失败时返回 -1
int fileno(FILE* stream);
`fileno` 则走相反方向。给它一个 `FILE *`,它会返回对应的文件描述符。
调用示例如下:
#include <stdio.h>
#include <fcntl.h>

int main(void)
{
	FILE *fp;
	int fd=open("data.dat", O_WRONLY|O_CREAT|O_TRUNC);
	if(fd==-1)
	{
		fputs("file open error", stdout);
		return -1;
	}

	printf("First file descriptor: %d n", fd);
	fp=fdopen(fd, "w");
	fputs("TCP/IP SOCKET PROGRAMMING n", fp);
  	printf("Second file descriptor: %d n", fileno(fp));
	fclose(fp);
	return 0;
}
这个例子要表达的重点很明确:转换前后的访问方式不同,但底层对应的仍然是同一个文件对象,因此 `fd` 和 `fileno(fp)` 表示的是同一资源。
套接字配合标准 I/O 的实际写法
理解完接口转换后,再看网络程序就比较顺了。下面这组回声服务器与客户端示例,展示了标准 I/O 如何直接套在套接字上使用。
服务器端:`echo_stdserv.c`
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <arpa/inet.h>
#include <sys/socket.h>

#define BUF_SIZE 1024
void error_handling(char *message);

int main(int argc, char *argv[])
{
	int serv_sock, clnt_sock;
	char message[BUF_SIZE];
	int str_len, i;

	struct sockaddr_in serv_adr;
	struct sockaddr_in clnt_adr;
	socklen_t clnt_adr_sz;
	FILE * readfp;
	FILE * writefp;

	if(argc!=2) {
		printf("Usage : %s <port>n", argv[0]);
		exit(1);
	}

	serv_sock=socket(PF_INET, SOCK_STREAM, 0);
	if(serv_sock==-1)
		error_handling("socket() error");

	memset(&serv_adr, 0, sizeof(serv_adr));
	serv_adr.sin_family=AF_INET;
	serv_adr.sin_addr.s_addr=htonl(INADDR_ANY);
	serv_adr.sin_port=htons(atoi(argv[1]));

	if(bind(serv_sock, (struct sockaddr*)&serv_adr, sizeof(serv_adr))==-1)
		error_handling("bind() error");

	if(listen(serv_sock, 5)==-1)
		error_handling("listen() error");

	clnt_adr_sz=sizeof(clnt_adr);

	for(i=0; i<5; i++)
	{
		clnt_sock=accept(serv_sock, (struct sockaddr*)&clnt_adr, &clnt_adr_sz);
		if(clnt_sock==-1)
			error_handling("accept() error");
		else
			printf("Connected client %d n", i+1);

		readfp=fdopen(clnt_sock, "r");
		writefp=fdopen(clnt_sock, "w");

		while(!feof(readfp))
		{
			fgets(message, BUF_SIZE, readfp);
			fputs(message, writefp);
			fflush(writefp);
		}
		fclose(readfp);
		fclose(writefp);
	}
	close(serv_sock);
	return 0;
}

void error_handling(char *message)
{
	fputs(message, stderr);
	fputc('n', stderr);
	exit(1);
}
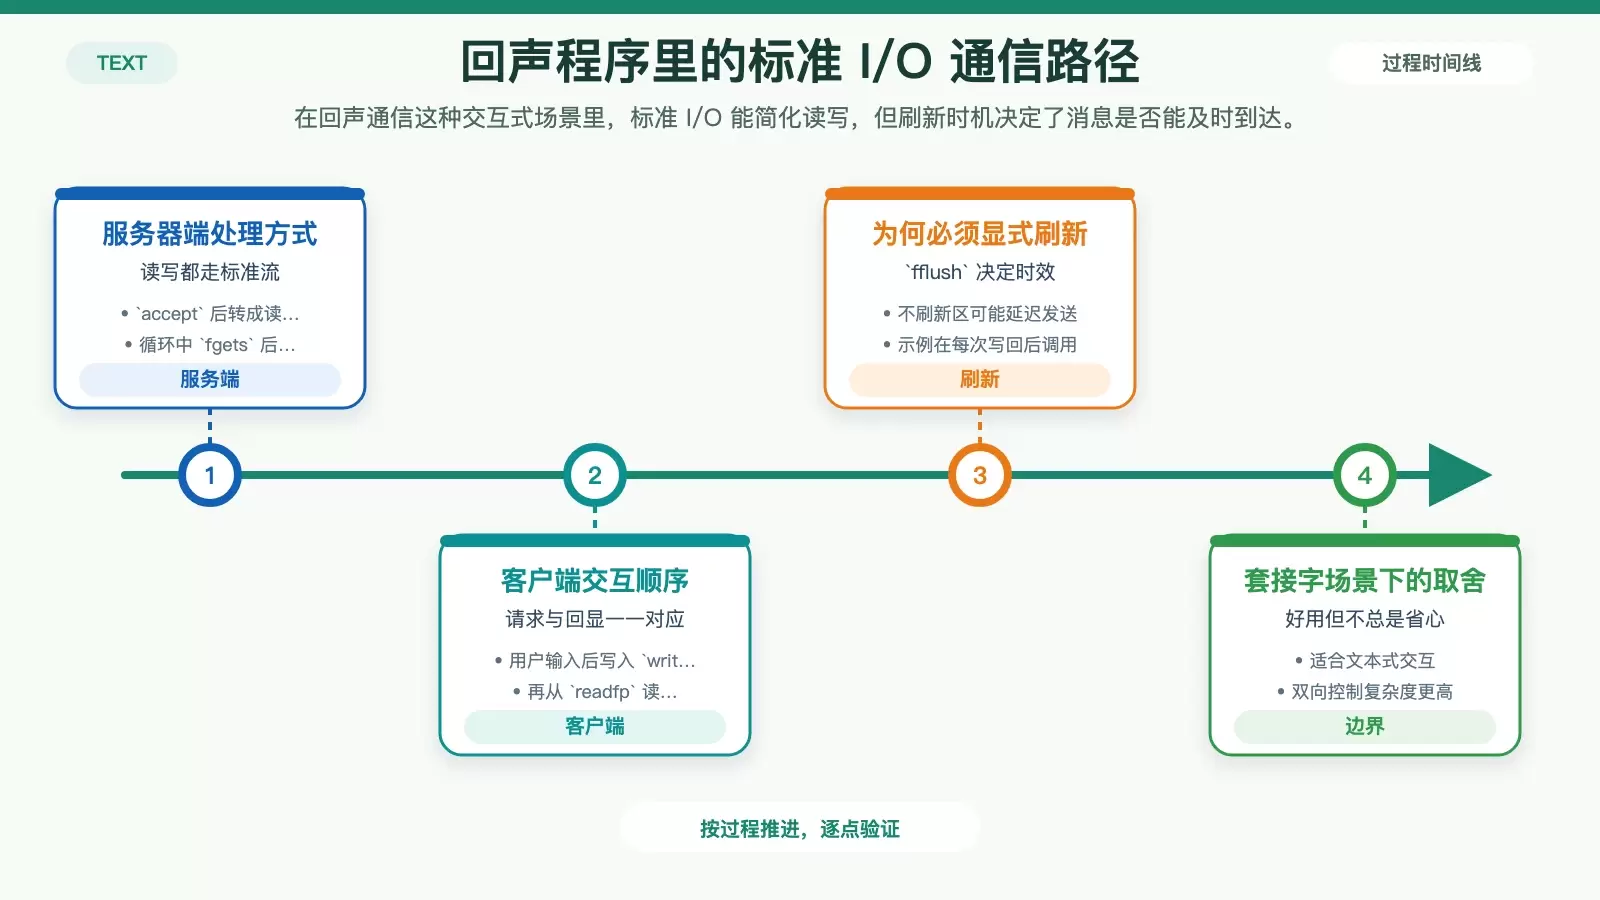
这段服务器程序的关键不在建连流程,而在 `accept` 之后的两步处理:
- 调用 `fdopen(clnt_sock, "r")` 获取读流。
- 调用 `fdopen(clnt_sock, "w")` 获取写流。
随后服务端通过 `fgets` 读取客户端消息,再用 `fputs` 把消息写回去,形成最简单的 echo 行为。
这里最容易忽略的一行就是循环里的 `fflush(writefp);`。如果不主动刷新,数据可能仍然停留在标准 I/O 缓冲区中,客户端就不能及时收到回应。也就是说,在交互式网络程序里,标准 I/O 的“自动缓冲”不一定总是你想要的行为,必要时必须显式刷新。
`fflush` 的作用,就是把某个输出流缓冲区里的数据立刻推送到底层目标,而不是继续等待缓冲区满或程序结束后再写出。
客户端:`echo_stdclnt.c`
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <unistd.h>
#include <arpa/inet.h>
#include <sys/socket.h>

#define BUF_SIZE 1024
void error_handling(char *message);

int main(int argc, char *argv[])
{
	int sock;
	char message[BUF_SIZE];
	int str_len;
	struct sockaddr_in serv_adr;
	FILE * readfp;
	FILE * writefp;

	if(argc!=3) {
		printf("Usage : %s <IP> <port>n", argv[0]);
		exit(1);
	}

	sock=socket(PF_INET, SOCK_STREAM, 0);
	if(sock==-1)
		error_handling("socket() error");

	memset(&serv_adr, 0, sizeof(serv_adr));
	serv_adr.sin_family=AF_INET;
	serv_adr.sin_addr.s_addr=inet_addr(argv[1]);
	serv_adr.sin_port=htons(atoi(argv[2]));

	if(connect(sock, (struct sockaddr*)&serv_adr, sizeof(serv_adr))==-1)
		error_handling("connect() error!");
	else
		puts("Connected...........");

	readfp=fdopen(sock, "r");
	writefp=fdopen(sock, "w");

	while(1)
	{
		fputs("Input message(Q to quit): ", stdout);
		fgets(message, BUF_SIZE, stdin);
		if(!strcmp(message,"qn") || !strcmp(message,"Qn"))
			break;

		fputs(message, writefp);
		fflush(writefp);
 		fgets(message, BUF_SIZE, readfp);
		printf("Message from server: %s", message);
	}
	fclose(writefp);
	fclose(readfp);
	return 0;
}

void error_handling(char *message)
{
	fputs(message, stderr);
	fputc('n', stderr);
	exit(1);
}
客户端逻辑和服务器端是对应的:连接建立后,同样先把套接字转成读写两个标准 I/O 流。用户输入一行消息后,客户端用 `fputs` 发给服务器,再立即 `fflush(writefp)`,确保消息不会滞留在本地缓冲区;之后再通过 `fgets` 读取服务器回传的数据。
这也解释了为什么标准 I/O 在网络交互里经常“能用但要小心用”:代码风格更接近文本流处理,读写表达也比较直观,但一旦程序要求实时回显、命令交互或请求-响应式通信,刷新时机就必须由程序员明确控制。
什么时候适合用标准 I/O,什么时候该回到系统调用
把整篇内容串起来,其实可以得到一个比较清晰的判断标准。
如果你的程序以文本处理为主,读写操作零碎而频繁,希望减少系统调用次数,那么标准 I/O 很有价值。它的缓冲能换来更好的性能,接口形式也更适合按行读取、按字符串写入。
如果你的程序对双向通信控制要求较高,或者你需要非常明确地掌握发送时机、资源管理方式和底层文件描述符行为,那么直接使用 `read`、`write` 这类系统调用通常更直接,也更不容易被缓冲行为“拖慢响应”。
在套接字场景下,标准 I/O 不是不能用,而是要先接受它的工作方式:你需要通过 `fdopen` 把文件描述符转换成 `FILE *`,必要时还要借助 `fileno` 反向取回描述符;一旦程序存在交互式发送,就要认真处理 `fflush`。理解了这些约束,标准 I/O 就不只是“文件编程那套接口”,它同样可以成为网络程序里一套可用、而且在某些场景下更高效的工具。















