


pandas DataFrame多列条件判断生成新列实战

发布时间:2026-10-13 |
6人浏览过
本文介绍如何利用pandas DataFrame的apply函数,基于多列条件生成新列。通过设置axis=1逐行处理,结合自定义函数或lambda表达式,实现如城市名含特定字符且年份匹配时的赋值逻辑。同时对比Series的apply用法,提供完整代码示例与运行结果参考。
开发环境为Python3.6.4配合pandas 0.22版本。
核心在于DataFrame.apply函数的使用:当axis参数设为1时,函数每次取一行数据进行计算;若axis为0,则每次取一列。
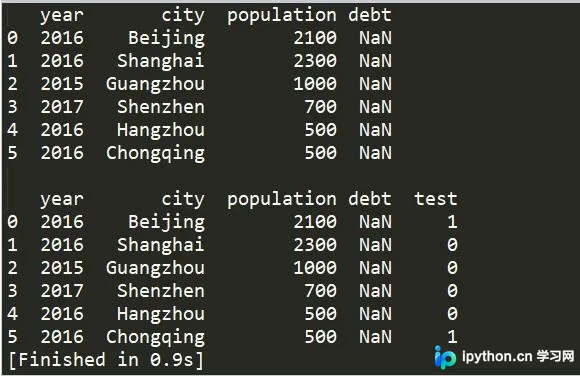
具体逻辑如代码所示:若城市名称包含字符'ing'且年份等于2016,则新列test赋值为1,否则为0。
import numpy as np
import pandas as pd

data = {'city': ['Beijing', 'Shanghai', 'Guangzhou', 'Shenzhen', 'Hangzhou', 'Chongqing'],
 'year': [2016,2016,2015,2017,2016, 2016],
 'population': [2100, 2300, 1000, 700, 500, 500]}
frame = pd.DataFrame(data, columns = ['year', 'city', 'population', 'debt'])

def function(a, b):
 if 'ing' in a and b == 2016:
 return 1
 else:
 return 0
print(frame, '\n')
frame['test'] = frame.apply(lambda x: function(x.city, x.year), axis = 1)
print(frame)
执行上述代码后的输出结果如下所示:
此外,Series类型同样支持apply方法,其使用方式示例如下:
import numpy as np
import pandas as pd

data = {'city': ['Beijing', 'Shanghai', 'Guangzhou', 'Shenzhen', 'Hangzhou', 'Chongqing'],
 'year': [2016,2016,2015,2017,2016, 2016],
 'population': [2100, 2300, 1000, 700, 500, 500]}
frame = pd.DataFrame(data, columns = ['year', 'city', 'population', 'debt'])

print(frame, '\n')
frame['panduan'] = frame.city.apply(lambda x: 1 if 'ing' in x else 0)
print(frame)
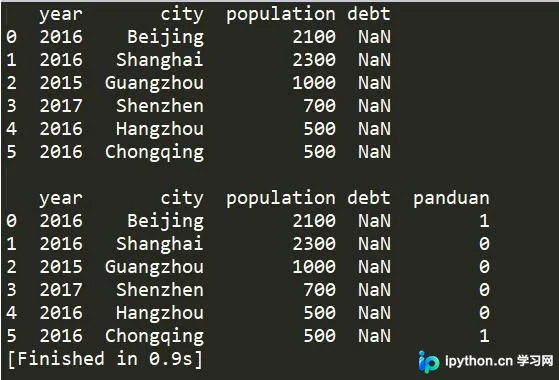
该Series操作的运行结果如下:
以上关于pandas DataFrame多列条件判断生成新列的实例分享完毕,希望能为读者提供实用参考,欢迎继续支持本站内容。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















