


Python使用pandas处理CSV文件的实例讲解

本文介绍如何利用Python的Pandas库高效处理大型CSV文件。通过实例演示从Linux终端数据重定向保存,到使用pandas.read_csv读取、查看前后行数据,以及自定义列索引的全过程。涵盖分隔符设置、header参数及names重命名技巧,帮助开发者快速掌握大数据量下的CSV处理方案。
Python生态中拥有众多便捷的数据处理库,其中NumPy和Pandas尤为突出。若再结合Matplotlib绘图模块,整体功能将变得非常强大。
CSV(Comma-Separated Values)是一种以纯文本形式存储表格数据的格式。由于无法直接通过Excel等表格工具进行简单处理,且Excel对数据量的支持有限,因此使用Pandas来处理海量CSV文件显得更为轻松高效。
本例中的数据源自其他硬件工具抓取,硬件环境搭建于Linux平台。脚本运行后,数据直接输出至终端(terminal)。鉴于数据量庞大,为保存结果,在Linux环境下利用数据流重定向技术,将所有数据保存至文本文件,最终生成本地CSV文件。
接下来演示如何使用Pandas读取本地CSV文件,并设置相应的DataFrame(数据框)。
import pandas as pd
import numpy as np
df=pd.read_csv('filename',header=None,sep=' ') #filename可以直接从盘符开始,标明每一级的文件夹直到csv文件,header=None表示头部为空,sep=' '表示数据间使用空格作为分隔符,如果分隔符是逗号,只需换成 ‘,'即可。
print df.head()
print df.tail()
#作为示例,输出CSV文件的前5行和最后5行,这是pandas默认的输出5行,可以根据需要自己设定输出几行的值
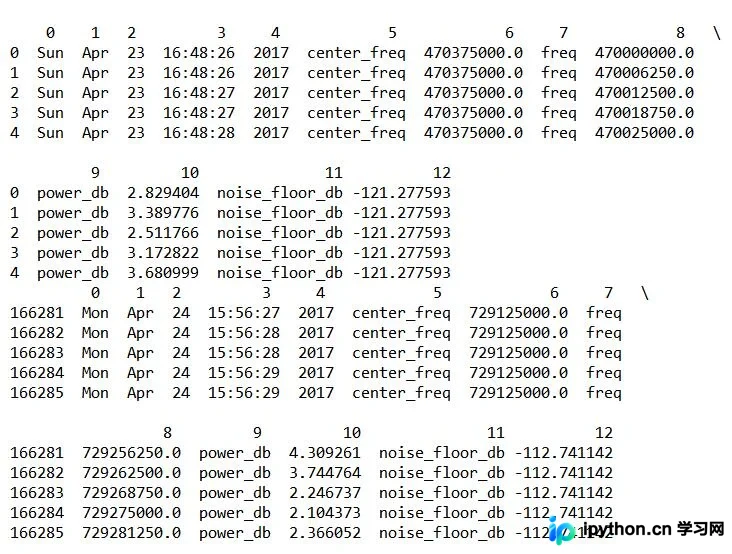
以下是数据读取的具体示例。
图片展示了本地数据的前5行与最后5行。最左侧未标号的列为行号,数据共包含13列,索引从0至12。因一行显示不全,第9列之后的内容换行,并使用反斜杠“\”进行标注。
2017年4月28日更新
使用Pandas直接读取本地CSV文件后,列索引默认从0开始编号。若需重定义列索引,可参考以下语句:
import pandas as pd
import numpy as np
df=pd.read_csv('filename',header=None,sep=' ',names=["week",'month','date','time','year','name1','freq1','name2','freq2','name3','data1','name4','data2'])
print df
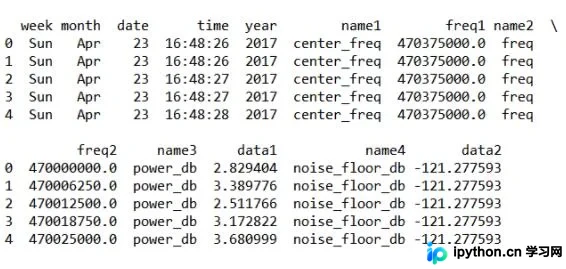
执行上述操作后,打印出的文件信息如下,此时列索引已成功重命名:
以上即为Python使用Pandas处理CSV文件的完整实例分享,希望能对读者有所帮助,也欢迎大家继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















