



多线程程序挂住却没有崩溃时,很多人第一反应是等它自行恢复,结果往往把最关键的现场错过。对 Linux 上的 C++ 服务来说,gcore 的价值就在于:进程还活着时,先把当下内存和线程栈完整备份下来,再用 gdb 回头分析阻塞点。
不过它并不是“抓了就能判死锁”的万能工具。下面按几个最常见的问题展开:先确认什么情况下能抓,再看怎样减少现场丢失,最后说明为什么有了 core 仍然可能看不到足够的信息,以及这些现象该如何判断。
gcore 能不能对挂死的多线程进程生成可用快照?
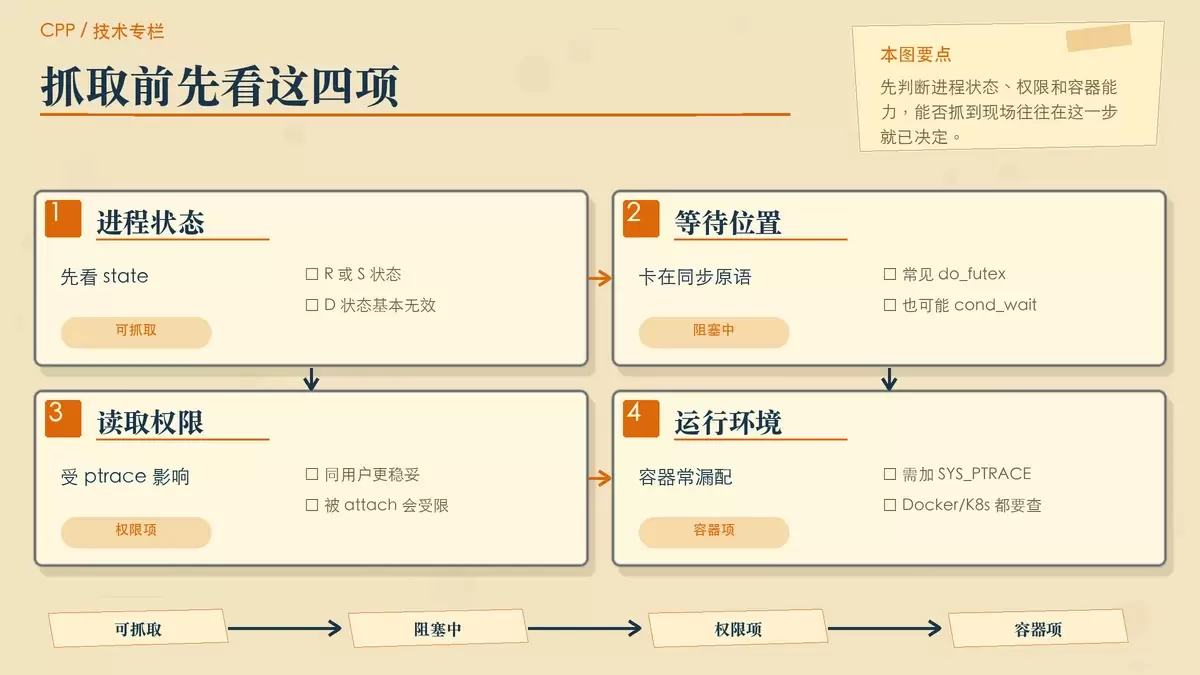
可以,但前提条件比较硬。目标进程必须处于 R(运行中)或 S(可中断睡眠)状态,不能被 ptrace 限制,同时当前用户要对该进程具备读取内存的权限。多数死锁线程虽然卡住了,通常仍停在 pthread_mutex_lock、__lll_lock_wait 这类同步调用上,进程状态依旧是 S,因此仍有机会被 gcore 抓到。
这也是它适合“挂死排查”的原因:进程没退出,线程没消失,调用栈还能保留下来。
先确认进程状态
正式抓取前,先看目标进程是不是处于可读取状态:
ps -o pid,comm,wchan,state -p <pid>重点看两列:
state是否为S或Rwchan是否落在pthread_cond_wait、do_futex等同步原语上
如果线程普遍停在这些位置,通常说明它们是在等待锁、条件变量或 futex,这类情况正是 gcore 能发挥作用的典型场景。
常见失败原因
如果命令执行失败,通常不是 gcore 本身的问题,而是进程状态或权限不满足条件。
例如:
gcore: failed to open /proc/12345/mem: Permission denied这往往意味着权限不足,或者进程被 seccomp / ptrace 限制,已经被其他调试器 attach 也会触发类似问题。
gcore: unable to dump process memory这类报错则更像是目标进程进入了不可中断的 D 状态,或者内核配置禁止了 ptrace。前者在死锁问题里不算常见,但一旦出现,gcore 基本就帮不上忙。
容器和权限也要提前判断
- 非 root 用户时,目标进程通常需要是当前用户自己启动的
- root 一般可以绕过大多数常规限制
- 如果程序运行在容器里,启动时通常要补上
--cap-add=SYS_PTRACE
无论是 docker run 还是 kubectl 场景,这个能力缺失都会让你看起来“命令没问题,但就是抓不到”。
gcore 命令怎么写,才能尽量不丢现场?
gcore 的优点是不会主动向目标进程发送终止信号,它只是读取内存并生成转储文件,因此通常不会改变线程当前停住的位置。这很适合在线上先留证据,再慢慢分析。
但也要明确它的边界:core 文件能保留寄存器、内存和调用栈,却不会直接给出“哪把 std::mutex 正被谁持有”的完整锁关系。它更像是保住现场,而不是自动给出死锁结论。
推荐命令
gcore -o /tmp/core.hang.$(date -u +%s) <pid>这个写法主要解决三个常见问题。
- 指定绝对路径,避免程序内部
chdir()后把 core 写进难以发现的目录 - 用时间戳命名,避免多次抓取时文件互相覆盖
- 显式带上
-o,不要依赖默认输出位置
如果省略 -o,默认会生成 core.<pid> 到当前目录;而当前目录可能没有写权限,也可能磁盘空间不足,最终表现为命令执行后看似没报大错,实际文件不可用。
抓完立刻检查结果
生成完成后,建议马上确认文件大小:
ls -lh /tmp/core.hang.*正常情况下,文件通常应大于 10MB,具体大小取决于目标进程的内存占用。如果只有很小的体积,或者文件根本没生成出来,就不要直接进入 gdb 分析阶段,先回头排查权限、路径和存储空间。
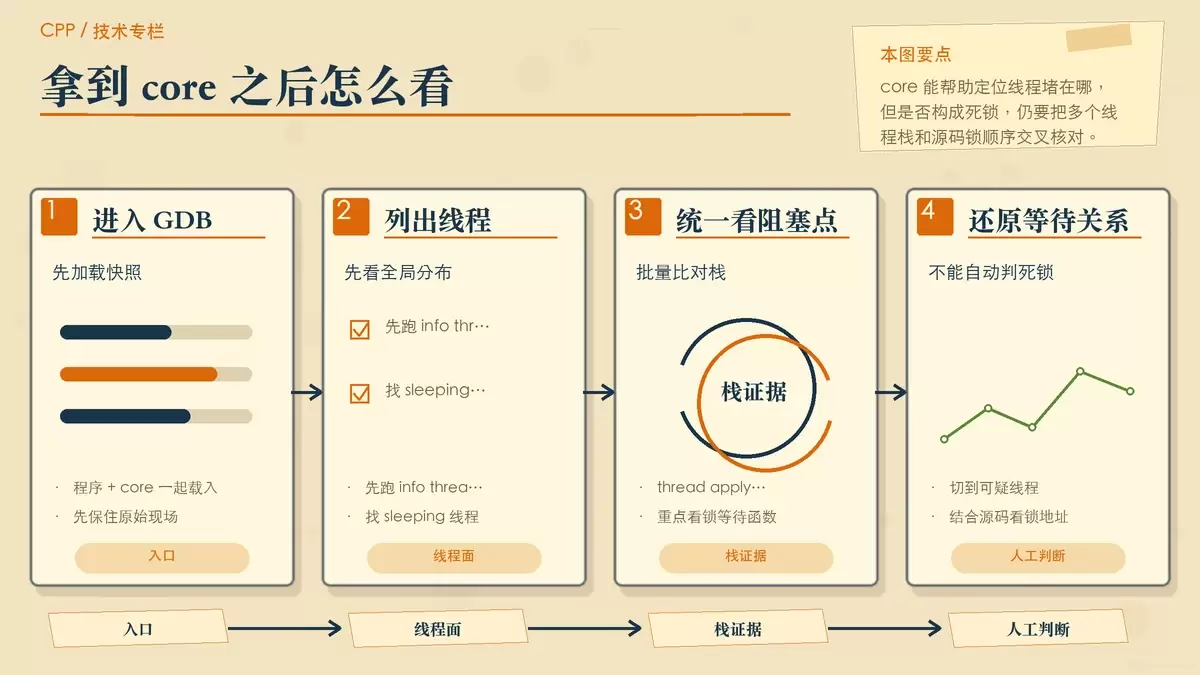
gcore 生成的 core,能不能直接用 gdb 查死锁?
可以查阻塞点,但不能自动判定死锁。这是很多人最容易高估的地方。
gdb 能告诉你某个线程卡在 pthread_mutex_lock,也能告诉你另一个线程卡在 sem_wait 或 __lll_lock_wait;但它不会直接下结论说“这里存在循环等待”。是否真的构成死锁,仍然要靠你把多个线程的等待关系和源码逻辑交叉比对出来。
基本分析顺序
先加载程序和快照:
gdb ./your_program /tmp/core.hang.1724126760然后按下面的顺序看:
- 列出所有线程:
info threads - 批量打印线程栈:
thread apply all bt - 切换到可疑线程:
thread 3 - 查看当前线程栈:
bt
这里最有价值的是批量栈信息。你需要观察是否有多个线程集中停在下面这些位置:
pthread_mutex_locksem_wait__lll_lock_waitnanosleep
如果多个线程都堵在锁相关调用上,再结合业务代码里的锁顺序,就能逐步还原谁在等谁。
怎么看“等哪把锁”
只看函数名通常不够,需要切到具体线程,顺着栈帧看局部变量和对象地址。例如线程栈里出现某个 mtx_a 的地址,就可以回到源码中判断:这个线程正等待哪把锁,它进入当前函数前又可能已经持有哪把锁。
真正的死锁判断,往往来自这种人工交叉分析,而不是某条自动化命令。
GDB 的辅助能力有限
如果 GDB 版本不低于 8.0,且符号没有被优化掉,可以尝试:
info mutex它有机会列出初始化过的 pthread_mutex_t 以及 owner LWP ID。不过这一步不能当成稳定依赖,因为不同构建方式、不同库版本下,可见信息差异很大。它更适合作为辅助线索,而不是最终依据。
为什么 gcore 成功了,gdb 里却看不到源码行号?
这是另一个常见误区:很多人以为 core 抓到了,源码上下文自然就有了。实际上并不是。
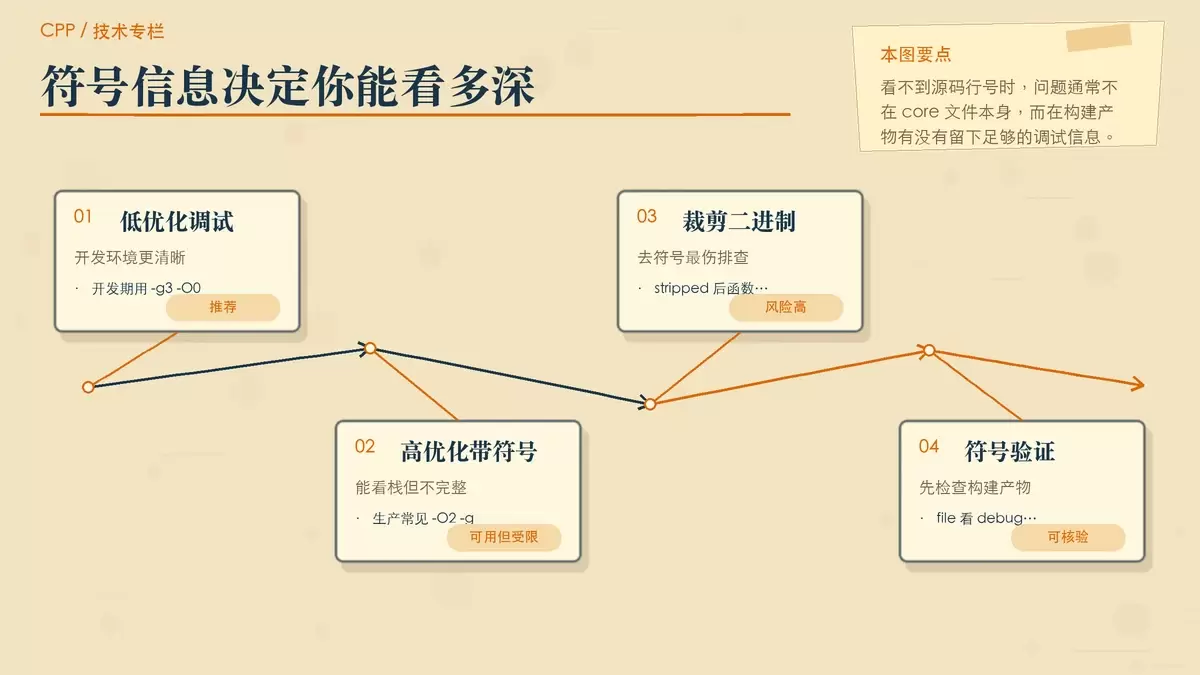
gcore 只负责复制目标进程当下的内存状态,不会额外补齐符号表。gdb 能不能把地址还原成函数名、源码行号和局部变量,取决于你的可执行文件里是否保留了调试信息,也就是 .debug_* 段是否还在。
编译参数直接决定可分析程度
- 开发环境建议使用
-g3 -O0 - 生产环境如果只能接受
-O2 -g,就要接受部分变量显示为<optimized out> - 如果发布的是 stripped 二进制,连函数名都可能看不到,
gcore的诊断价值会明显下降
也就是说,core 能不能帮你定位问题,很多时候不是出在抓取阶段,而是早在编译和发布阶段就已经决定了上限。
如何验证调试符号是否可用
可以直接检查二进制:
file ./your_program正常应能看到 with debug_info。
再进一步确认调试段是否存在:
readelf -S ./your_program | grep debug如果输出里能看到多个 .debug_* 段,说明符号信息基本还在,后续进 gdb 看源码和变量的成功率会高很多。
为什么仍然可能误判死锁
即便你有 core,也不代表锁关系一定能完整还原。容易被忽略的一点是:gcore 抓到的是某一时刻的内存快照,而锁 owner 等状态信息未必以一种直观、稳定的方式保存在内存里。
尤其是 std::mutex 这类 C++ 封装对象,底层依赖的仍是 pthread 原语。一部分 owner 信息可能落在栈上、寄存器里,或者被优化后的代码路径打散。分析时如果只看单个线程、只盯某一帧栈,很容易把“等待锁”误读成“死锁已经形成”。
更稳妥的方式是把多个线程的栈一起看,再和源码中的加锁顺序、调用路径、资源依赖关系对应起来。只有出现明确的循环等待链路,才能较有把握地认定为死锁。
实际排查时,应该怎样判断 gcore 值不值得用?
如果你的 C++ 多线程程序只是“挂住不动”,而进程还在、状态为 R 或 S、权限也满足,那么 gcore 仍然是保留第一现场的高性价比手段。它特别适合在线问题刚出现、还来不及重启服务时先把证据拿下来。
但如果目标进程已经进入 D 状态、二进制被 strip、调试符号缺失,或者你本来就需要的是锁持有链的自动化结论,那它的效果就会明显打折。这时更现实的做法,往往是提前准备好崩溃转储方案,例如配合 kill -3 <pid> 和预先配置的 /proc/sys/kernel/core_pattern,或者直接改进程序的锁监控和诊断日志。
归根结底,gcore 最擅长的是“把挂死时的线程栈和内存保下来”,而不是替你完成死锁定性。把这个边界想清楚,才能在故障现场少走弯路。















