


朴素贝叶斯分类算法原理详解与Python实战代码

本文深入解析朴素贝叶斯分类算法的核心原理,包括条件概率独立性假设与贝叶斯公式应用。通过电商评论情感分析案例,演示从特征提取到概率计算的完整流程,并提供Python代码实现,帮助开发者掌握该算法在文本分类中的实际使用方法。
本文详细介绍朴素贝叶斯分类算法的理论基础及其在Python中的具体实现与应用方法,旨在为读者提供清晰的参考指南。
朴素贝叶斯分类算法
1、朴素贝叶斯分类算法原理
1.1、概述
贝叶斯分类算法涵盖了一类基于概率模型的分类方法。
其核心依据是计算样本归属于各个类别的概率,并以此作为分类决策的基础。
在贝叶斯分类算法家族中,朴素贝叶斯是最基础且简单的一种形式。
注:这里的“朴素”指的是算法假设特征之间相互独立。
若满足条件概率独立性,则有公式:P(A|x1x2x3x4)=p(A|x1)*p(A|x2)p(A|x3)p(A|x4)。同时,联合概率可表示为:P(xy|z)=p(xyz)/p(z)=p(xz)/p(z)*p(yz)/p(z)。
1.2、算法思想
朴素贝叶斯的基本逻辑如下:
当给定某些属性条件时,若事物属于类别A的概率大于属于类别B的概率,则判定该事物属于类别A。
通俗举例:若在街上看到一位黑人,让你推测其来源地,你大概率会猜测是非洲。这是为什么?
这一判断过程基于以下逻辑链条:
①、观察到的特征:肤色为黑色。 ②、基于历史数据,黑色人种来自非洲的条件概率最高。 ③、在缺乏其他辅助信息的情况下,最合理的推断是此人来自非洲。
这就是朴素贝叶斯判断的思想基础。
进一步扩展:如果在街上看到一位黑人且正在讲英语,我们该如何判断其来源?
首先提取关键特征:
肤色: 黑 语言: 英语
基于统计数据的条件概率: 黑色人种来自非洲的概率: 80% 黑色人种来自于美国的概率:20%
基于语言统计的条件概率: 讲英语的人来自于非洲的概率:10% 讲英语的人来自于美国的概率:90%
依据自然思维逻辑进行综合判断:
计算来自非洲的联合概率:80% * 10% = 0.08 计算来自美国的联合概率:20% * 90% = 0.18
比较结果,0.18 > 0.08,因此判断此人来自美国。
其背后的数学推导原理如下:
根据贝叶斯定理及独立性假设:p(A|xy)=p(Axy)/p(xy)=p(Axy)/p(x)p(y)=p(A)/p(x)*p(A)/p(y)* p(xy)/p(xy)=p(A|x)p(A|y)。
通用公式为:P(类别 | 特征)=P(特征 | 类别)*P(类别) / P(特征)。
1.3、算法步骤
①、对各类别先验样本数据进行特征分解。 ②、计算各类数据中,各特征出现的条件概率。 (例如:在特征1出现的情况下,属于A类的概率p(A|特征1),属于B类的概率p(B|特征1),属于C类的概率p(C|特征1)等)。 ③、对待分类数据进行特征分解(提取特征1、特征2、特征3、特征4等)。 ④、计算各特征条件概率的乘积,具体计算方式如下: 判断为A类的概率:p(A|特征1)*p(A|特征2)*p(A|特征3)*p(A|特征4)..... 判断为B类的概率:p(B|特征1)*p(B|特征2)*p(B|特征3)*p(B|特征4)..... 判断为C类的概率:p(C|特征1)*p(C|特征2)*p(C|特征3)*p(C|特征4)..... ...... ⑤、选取计算结果中的最大值,该值对应的类别即为样本所属类别。
1.4、算法应用举例
大众点评、淘宝等电商平台积累了大量用户评论数据,例如:
| 1、衣服质量太差了!!!!颜色根本不纯!!! | 0 |
| 2、我有一有种上当受骗的感觉!!!! | 0 |
| 3、质量太差,衣服拿到手感觉像旧货!!! | 0 |
| 4、上身漂亮,合身,很帅,给卖家点赞 | 1 |
| 5、穿上衣服帅呆了,给点一万个赞 | 1 |
| 6、我在他家买了三件衣服!!!!质量都很差! | 0 |
其中编号1/2/3/6的评论为差评,4/5为好评。
现在需要利用朴素贝叶斯分类算法自动对新评论进行分类,例如:
a、这么差的衣服以后再也不买了 b、帅,有逼格 ……
1.5、算法应用流程
①、对先验数据进行分词处理,提取各特征。 (例如:“衣服”“质量太差”“差”“不纯”“帅”“漂亮”,“赞”等)。 ②、计算各类别(如好评、差评)中,各特征的条件概率。 (例如 p(“衣服”|差评)、p(“衣服”|好评)、p(“差”|好评) 、p(“差”|差评)等)。 ③、对待分类样本进行特征分解。 (例如对评论a分解为:“差” “衣服” 等)。 ④、计算各类别的后验概率。 P(好评) = p(好评|“差”) *p(好评|“衣服”)*…… P(差评) = p(差评|“差”) *p(差评|“衣服”)*…… ⑤、比较概率值,显然P(差评)的结果值更大,因此评论a被判定为“差评”。
1.6、朴素贝叶斯分类算法案例
核心计算方法如下:
P(好评 | 单词1,单词2,单词3) = P(单词1,单词2,单词3 | 好评) * P(好评) / P(单词1,单词2,单词3)。
由于分母P(单词1,单词2,单词3)对所有类别相同,因此只需比较分子即可,即比较:P(单词1,单词2,单词3 | 好评) * P(好评)。
基于单词相互独立的假设,分子可展开为:P(单词1 | 好评) * P(单词2 | 好评) * P(单词3 | 好评) * P(好评)。
其中,P(单词1 | 好评) = 单词1在好评样本中出现的总次数 / 好评样本句子中总的单词数。
先验概率 P(好评) = 样本好评的条数 / 样本的总条数。
同理,对于差评的计算:
P(差评 | 单词1,单词2,单词3) = P(单词1,单词2,单词3 | 差评) * P(差评) / P(单词1,单词2,单词3)。
同样因分母相同,只需比较分子:P(单词1,单词2,单词3 | 差评) * P(差评)。
基于独立性假设,展开为:P(单词1 | 差评) * P(单词2 | 差评) * P(单词3 | 差评) * P(差评)。
2、 Python案例
#!/usr/bin/python
# coding=utf-8
from numpy import *
# 过滤网站的恶意留言 侮辱性:1   非侮辱性:0
# 创建一个实验样本
def loadDataSet():
  postingList = [['my','dog','has','flea','problems','help','please'],
          ['maybe','not','take','him','to','dog','park','stupid'],
          ['my','dalmation','is','so','cute','I','love','him'],
          ['stop','posting','stupid','worthless','garbage'],
          ['mr','licks','ate','my','steak','how','to','stop','him'],
          ['quit','buying','worthless','dog','food','stupid']]
  classVec = [0,1,0,1,0,1]
  return postingList, classVec
# 创建一个包含在所有文档中出现的不重复词的列表
def createVocabList(dataSet):
  vocabSet = set([])   # 创建一个空集
  for document in dataSet:
    vocabSet = vocabSet | set(document)  # 创建两个集合的并集
  return list(vocabSet)
# 将文档词条转换成词向量
def setOfWords2Vec(vocabList, inputSet):
  returnVec = [0]*len(vocabList)    # 创建一个其中所含元素都为0的向量
  for word in inputSet:
    if word in vocabList:
      # returnVec[vocabList.index(word)] = 1   # index函数在字符串里找到字符第一次出现的位置 词集模型
      returnVec[vocabList.index(word)] += 1   # 文档的词袋模型  每个单词可以出现多次
    else: print "the word: %s is not in my Vocabulary!" % word
  return returnVec
# 朴素贝叶斯分类器训练函数  从词向量计算概率
def trainNB0(trainMatrix, trainCategory):
  numTrainDocs = len(trainMatrix)
  numWords = len(trainMatrix[0])
  pAbusive = sum(trainCategory)/float(numTrainDocs)
  # p0Num = zeros(numWords); p1Num = zeros(numWords)
  # p0Denom = 0.0; p1Denom = 0.0
  p0Num = ones(numWords);  # 避免一个概率值为0,最后的乘积也为0
  p1Num = ones(numWords);  # 用来统计两类数据中,各词的词频
  p0Denom = 2.0; # 用于统计0类中的总数
  p1Denom = 2.0 # 用于统计1类中的总数
  for i in range(numTrainDocs):
    if trainCategory[i] == 1:
      p1Num += trainMatrix[i]
      p1Denom += sum(trainMatrix[i])
    else:
      p0Num += trainMatrix[i]
      p0Denom += sum(trainMatrix[i])
      # p1Vect = p1Num / p1Denom
      # p0Vect = p0Num / p0Denom
  p1Vect = log(p1Num / p1Denom)  # 在类1中,每个次的发生概率
  p0Vect = log(p0Num / p0Denom)   # 避免下溢出或者浮点数舍入导致的错误  下溢出是由太多很小的数相乘得到的
  return p0Vect, p1Vect, pAbusive
# 朴素贝叶斯分类器
def classifyNB(vec2Classify, p0Vec, p1Vec, pClass1):
  p1 = sum(vec2Classify*p1Vec) + log(pClass1)
  p0 = sum(vec2Classify*p0Vec) + log(1.0-pClass1)
  if p1 > p0:
    return 1
  else:
    return 0
def testingNB():
  listOPosts, listClasses = loadDataSet()
  myVocabList = createVocabList(listOPosts)
  trainMat = []
  for postinDoc in listOPosts:
    trainMat.append(setOfWords2Vec(myVocabList, postinDoc))
  p0V, p1V, pAb = trainNB0(array(trainMat), array(listClasses))
  testEntry = ['love','my','dalmation']
  thisDoc = array(setOfWords2Vec(myVocabList, testEntry))
  print testEntry, 'classified as: ', classifyNB(thisDoc, p0V, p1V, pAb)
  testEntry = ['stupid','garbage']
  thisDoc = array(setOfWords2Vec(myVocabList, testEntry))
  print testEntry, 'classified as: ', classifyNB(thisDoc, p0V, p1V, pAb)
# 调用测试方法----------------------------------------------------------------------
testingNB()
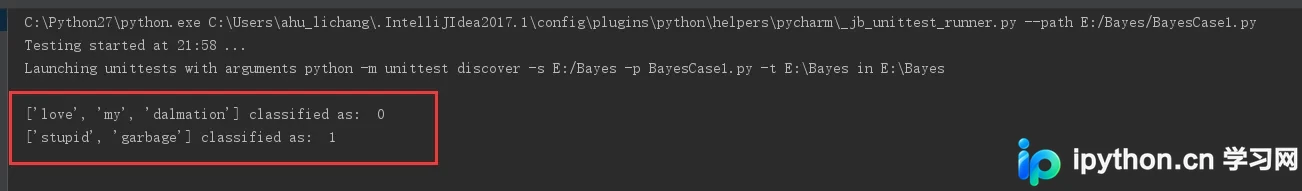
运行结果:
更多关于Python相关内容感兴趣的读者可查看本站专题:《Python数学运算技巧总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》及《Python文件与目录操作技巧汇总》。
希望本文所述对大家Python程序设计有所帮助。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















