


Python人工智能实战案例精选:从入门到进阶的代码示例
精选Python人工智能从入门到进阶的典型实战案例,涵盖基础机器学习分类、PyTorch卷积神经网络、Hugging Face自然语言处理及大模型RAG检索增强系统,提供完整代码与清晰技术解析。
学习人工智能最有效的路径不是单纯啃读数学理论,而是结合具体业务场景,通过由浅入深的典型代码项目建立对算法结构、数据流水线以及模型调优的直观认知。本文精选了四个不同难度梯度的实战案例,从经典机器学习表格预测入手,递进到基于 PyTorch 的计算机视觉图像分类、Hugging Face 框架的现代自然语言处理,再到进阶阶段的大语言模型 RAG(检索增强生成)系统构建。每个案例均包含运行环境配置、可执行代码和核心技术点剖析,帮助读者系统掌握 Python 人工智能工程开发全流程。
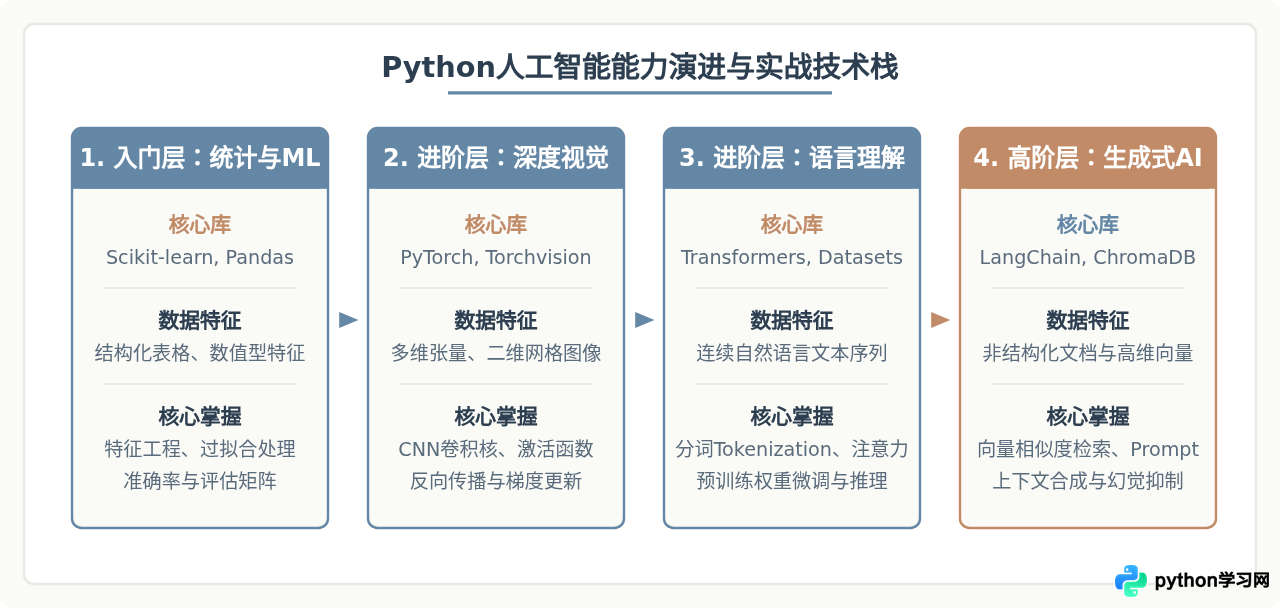
一、入门基础:使用 Scikit-learn 构建表格分类预测
对于刚接触人工智能的开发者,最适合建立概念的是经典机器学习分类任务。在这个场景中,数据以表格形式存在,算法需要从已知的数值特征中学习规律,进而对新样本所属类别作出概率判断。相比深度学习,经典算法对算力要求极低,同时能清晰暴露特征归一化、数据集划分、过拟合与模型评估等所有通用概念。
本案例模拟一个电信客户流失预测场景。我们将构造特征数据,使用 RandomForestClassifier(随机森林)进行训练,并评估模型的精确度(Precision)与召回率(Recall)。
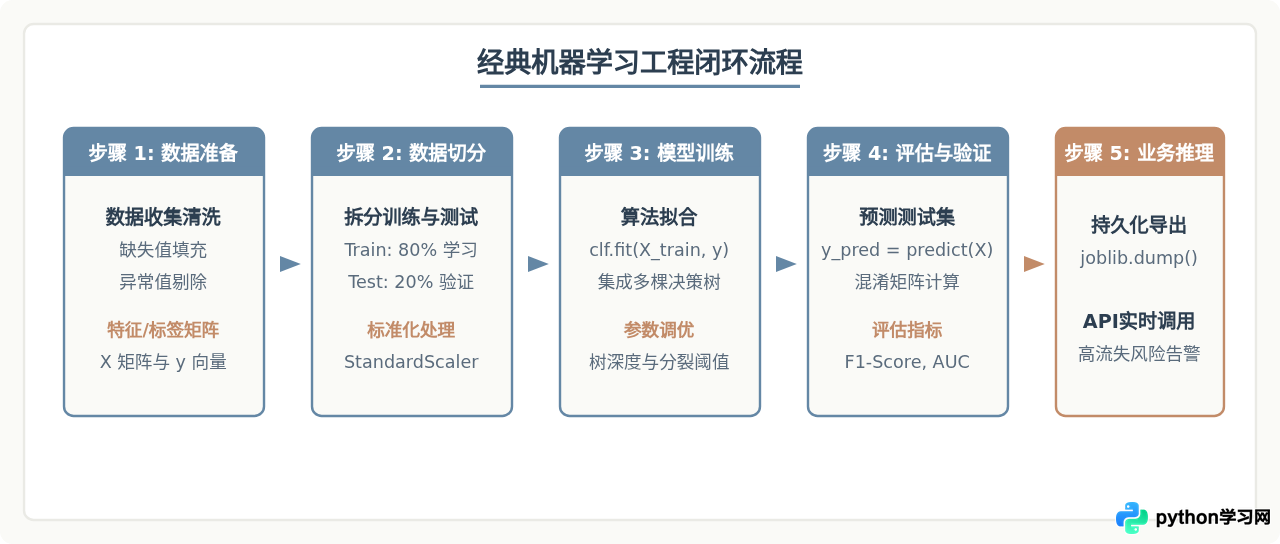
环境准备与完整代码
# 依赖安装
pip install numpy pandas scikit-learn
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report, confusion_matrix
# 1. 模拟生成数据集(特征包括:账单金额、月均使用时长、投诉次数、合约期长短)
np.random.seed(42)
num_samples = 1000
features = {
'monthly_fee': np.random.normal(70, 20, num_samples),
'usage_hours': np.random.normal(50, 15, num_samples),
'complaints': np.random.poisson(1.2, num_samples),
'contract_months': np.random.choice([1, 12, 24], size=num_samples, p=[0.5, 0.3, 0.2])
}
df = pd.DataFrame(features)
# 构造流失规则(投诉多、单月合约且月费高的人更容易流失)
churn_prob = (
0.3 * (df['complaints'] > 2) +
0.4 * (df['contract_months'] == 1) +
0.2 * (df['monthly_fee'] > 75)
)
df['churn'] = (churn_prob + np.random.normal(0, 0.15, num_samples) > 0.5).astype(int)
# 2. 特征与标签切分
X = df[['monthly_fee', 'usage_hours', 'complaints', 'contract_months']]
y = df['churn']
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.2, random_state=42, stratify=y
)
# 3. 特征标准化(保持特征尺度统一)
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)
# 4. 训练随机森林分类器
model = RandomForestClassifier(n_estimators=100, max_depth=6, random_state=42)
model.fit(X_train_scaled, y_train)
# 5. 模型预测与评估
y_pred = model.predict(X_test_scaled)
print("=== 分类性能报告 ===")
print(classification_report(y_test, y_pred, target_names=['留存', '流失']))
# 6. 单个样本在线预测示例
new_customer = np.array([[85.0, 30.0, 3, 1]]) # 高月费、低时长、多投诉、单月约
new_scaled = scaler.transform(new_customer)
prob = model.predict_proba(new_scaled)[0][1]
print(f"新客户流失预估概率: {prob:.2%}")fit_transform 只能作用于训练集 X_train,对测试集 X_test 和新样本只能使用 transform。如果对整个数据集一次性进行标准化,会导致“数据穿越”(Data Leakage),使得测试集的评估指标虚高。
二、进阶视觉:基于 PyTorch 的卷积神经网络图像分类
当输入数据从一维表格转换为包含空间局部相关性的二维图像像素时,常规的全连接网络参数量会呈几何级数爆炸,且无法捕获位置平移不变性。这时就需要引入卷积神经网络(CNN)。PyTorch 提供了动态计算图机制与优雅的面向对象编程范式,是工业界与学术界首选的深度学习框架。
在本案例中,我们搭建一个轻量级 CNN 模型,用于对经典的 Fashion-MNIST 图像数据集进行训练和分类,涵盖卷积层、池化层、损失计算与反向传播的完整循环。
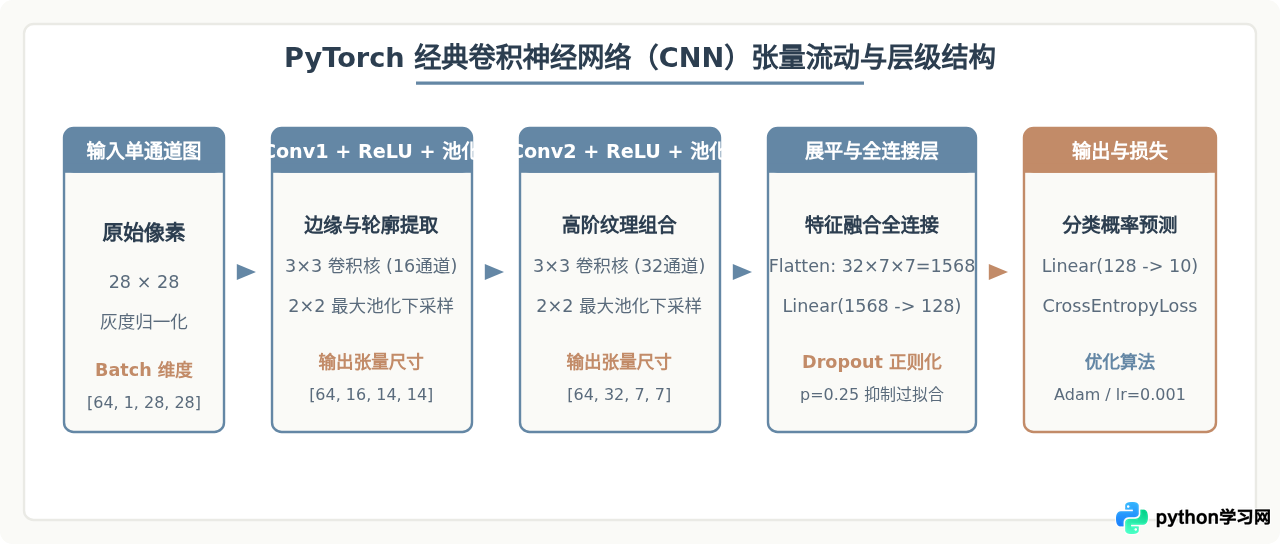
环境准备与模型实现代码
# 依赖安装
pip install torch torchvision
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader
from torchvision import datasets, transforms
# 1. 设置运算设备(自动检测 GPU/MPS 或回退到 CPU)
device = torch.device("cuda" if torch.cuda.is_available() else ("mps" if torch.backends.mps.is_available() else "cpu"))
print(f"当前计算后端: {device}")
# 2. 数据流水线构建(包含数据增强与标准化)
transform = transforms.Compose([
transforms.ToTensor(),
transforms.Normalize((0.5,), (0.5,))
])
# 加载测试与训练集(自动下载)
train_dataset = datasets.FashionMNIST(root='./data', train=True, download=True, transform=transform)
test_dataset = datasets.FashionMNIST(root='./data', train=False, download=True, transform=transform)
train_loader = DataLoader(train_dataset, batch_size=64, shuffle=True)
test_loader = DataLoader(test_dataset, batch_size=64, shuffle=False)
# 3. 定义轻量级 CNN 架构
class SimpleCNN(nn.Module):
def __init__(self):
super(SimpleCNN, self).__init__()
self.conv_layers = nn.Sequential(
nn.Conv2d(1, 16, kernel_size=3, padding=1),
nn.ReLU(),
nn.MaxPool2d(2, 2), # 28x28 -> 14x14
nn.Conv2d(16, 32, kernel_size=3, padding=1),
nn.ReLU(),
nn.MaxPool2d(2, 2) # 14x14 -> 7x7
)
self.fc_layers = nn.Sequential(
nn.Flatten(),
nn.Linear(32 * 7 * 7, 128),
nn.ReLU(),
nn.Dropout(0.25),
nn.Linear(128, 10) # 10 个服装类别
)
def forward(self, x):
x = self.conv_layers(x)
x = self.fc_layers(x)
return x
model = SimpleCNN().to(device)
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=0.001)
# 4. 训练与验证循环
def train_one_epoch(epoch):
model.train()
running_loss = 0.0
for images, labels in train_loader:
images, labels = images.to(device), labels.to(device)
optimizer.zero_grad() # 梯度清零
outputs = model(images) # 前向计算
loss = criterion(outputs, labels) # 损失评估
loss.backward() # 反向传播
optimizer.step() # 权重更新
running_loss += loss.item()
print(f"Epoch [{epoch+1}] 训练损失均值: {running_loss/len(train_loader):.4f}")
def evaluate():
model.eval()
correct, total = 0, 0
with torch.no_grad(): # 评估阶段关闭梯度节省内存
for images, labels in test_loader:
images, labels = images.to(device), labels.to(device)
outputs = model(images)
_, predicted = torch.max(outputs, 1)
total += labels.size(0)
correct += (predicted == labels).sum().item()
print(f"测试集准确率: {100 * correct / total:.2f}%")
# 执行 3 个轮次演示
for epoch in range(3):
train_one_epoch(epoch)
evaluate()optimizer.zero_grad() 必须位于 loss.backward() 之前。在 PyTorch 中梯度默认是累加(accumulate)计算的,如果遗漏清零操作,上一批次的梯度会与当前批次叠加,导致梯度爆炸与训练发散。
三、进阶自然语言处理:基于 Hugging Face Transformers 的语义分析
处理文本数据与图像有本质区别:文字是离散符号,不能直接进行算术运算。早期的词袋模型(BoW)与 Word2Vec 无法解决一词多义与长距离语法依赖。现代 NLP 的事实标准是基于自注意力机制的 Transformer 架构。
借助工业界标准的 transformers 库,我们无需从零编写注意力矩阵乘法,而能够快速利用预训练语言模型(如 BERT 或 RoBERTa)进行微调与语义分类推断。下面示例演示如何加载 Tokenizer 分词器,并将文本转化为输入张量进行情感极性判定。
# 依赖安装
pip install transformers torch
from transformers import AutoTokenizer, AutoModelForSequenceClassification
import torch
# 1. 指定预训练模型权重(采用轻量多语言或中文模型)
model_name = "distilbert-base-uncased-finetuned-sst-2-english"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForSequenceClassification.from_pretrained(model_name)
model.eval()
# 2. 待分析文本列表
texts = [
"The runtime performance of this new deep learning pipeline is phenomenal!",
"Unfortunately, the model latency is far too high for real-time production serving.",
"The documentation provides straightforward steps and great code snippets."
]
# 3. 文本分词与张量编码(包含 Padding 与截断)
inputs = tokenizer(
texts,
padding=True,
truncation=True,
max_length=64,
return_tensors="pt"
)
print("分词张量维度 (Batch, Sequence):", inputs["input_ids"].shape)
# 4. 模型前向推断与 Softmax 归一化
with torch.no_grad():
logits = model(**inputs).logits
probabilities = torch.softmax(logits, dim=1)
# 5. 解析预测结果
id2label = model.config.id2label
for text, prob in zip(texts, probabilities):
predicted_idx = torch.argmax(prob).item()
label = id2label[predicted_idx]
confidence = prob[predicted_idx].item()
print(f"\n文本内容: \"{text}\"")
print(f"情感判定: {label} (置信度: {confidence:.2%})")input_ids(词元序号)与 attention_mask(注意力掩码)。对短文本进行批次补齐(Padding)时,掩码中为 0 的位置会在注意力计算中被忽略,防止无意义的补齐符号干扰实际语义。
四、高阶前沿应用:大模型 RAG(检索增强生成)轻量落地实战
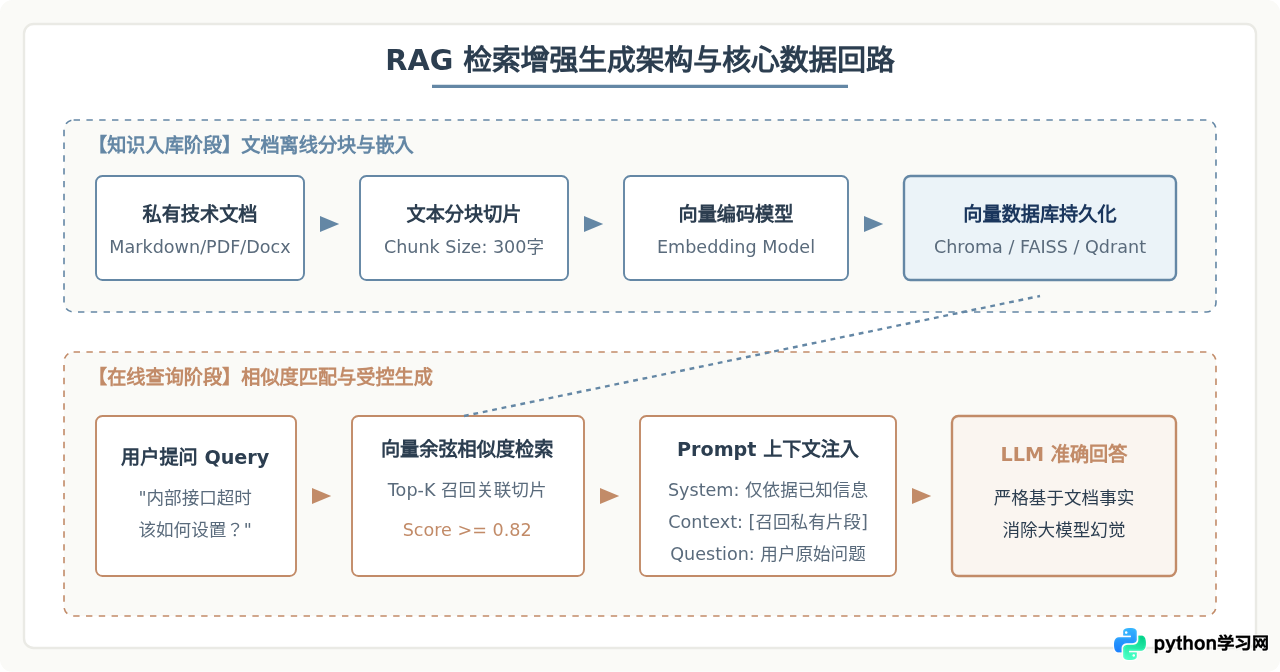
在大语言模型(LLM)落地企业知识库或垂直问答时,常面临两大痛点:一是模型存在“幻觉”(编造不实信息),二是模型缺乏私有业务数据与最新资讯。重新微调(Fine-tuning)不仅算力开销巨大,还容易遗忘通用能力。RAG(Retrieval-Augmented Generation)技术通过先从向量数据库检索高匹配片段,再注入 Prompt 上下文让大模型归纳输出,成为了当下的工程首选架构。
纯 Python 零依赖轻量 RAG 实现
为了让读者彻底理解向量余弦相似度匹配与上下文拼装的底层机理,下面提供一个使用 NumPy 实现的纯轻量 RAG 最小可行性工程:
import numpy as np

# 1. 模拟领域知识库(三条私有文档切片)
document_chunks = [
    "支付服务超时配置:所有第三方支付回调接口超时阈值统一设置为 5000 毫秒,重试次数不超过 3 次。",
    "数据库连接池规则:生产环境读写分离节点最小空闲连接为 10,最大峰值连接不得超过 50。",
    "开发联调安全规范:本地研发禁止直连生产数据库,必须通过堡垒机只读账号或沙箱脱敏数据验证。"
]

# 2. 为简化演示,构建一个特征词袋伪嵌入函数(生产环境替换为 OpenAI 或 BGE 向量模型)
vocabulary = ["支付", "超时", "重试", "数据库", "连接池", "生产", "安全", "沙箱"]

def text_to_embedding(text: str) -> np.ndarray:
    vec = np.zeros(len(vocabulary), dtype=float)
    for i, word in enumerate(vocabulary):
        if word in text:
            vec[i] += 1.0
    norm = np.linalg.norm(vec)
    return vec / norm if norm > 0 else vec

# 为所有文档计算向量
doc_embeddings = np.array([text_to_embedding(doc) for doc in document_chunks])

# 3. 向量检索函数:计算 Query 与文档向量的余弦相似度
def retrieve_relevant_context(query: str, top_k: int = 1) -> str:
    query_vec = text_to_embedding(query)
    # 余弦相似度点乘
    similarities = np.dot(doc_embeddings, query_vec)
    best_idx = np.argsort(similarities)[::-1][:top_k]

    retrieved_texts = [document_chunks[i] for i in best_idx if similarities[i] > 0]
    return "\n".join(retrieved_texts) if retrieved_texts else "无相关参考文档。"

# 4. 组装增强 Prompt 并调用回答生成器
def generate_rag_response(user_query: str) -> str:
    context = retrieve_relevant_context(user_query)

    prompt = f"""【系统指令】你是一名专业技术运维专家。请严格基于给定的【参考资料】回答用户问题,不要编造任何参考资料中没有的信息。

【参考资料】:
{context}

【用户问题】:
{user_query}

【回答】:"""

    # 模拟 LLM 依据 Context 的提炼逻辑
    if "支付" in context and "超时" in context:
        answer = "根据技术规范,支付回调接口超时时间应配置为 5000 毫秒,且重试次数最多 3 次。"
    else:
        answer = "未能从参考资料中找到相关规则,请核对问题或补充对应知识文档。"

    return f"--- 最终组装的 Prompt ---\n{prompt}\n\n--- 最终输出结果 ---\n{answer}"

# 运行测试
user_question = "请问我们的支付回调接口超时该怎么设置?"
print(generate_rag_response(user_question))五、从入门到进阶的开发避坑指南
在实际工程中,人工智能项目往往受制于工程规范与数据质量,以下是各技术阶段最易忽视的痛点与规避手段:
- 不可重现的随机性:无论是机器学习划分数据集,还是深度学习初始化卷积核,务必在脚本头部固定随机种子(
np.random.seed、torch.manual_seed),确保结果可复现。 - 数据倾斜与标签不平衡:在样本类别比例悬殊(如 99:1)时,模型若全部预测为多数类,准确率虽高却毫无业务价值。此时应切换为 Precision、Recall、PR-AUC 或 F1 指标,并配置类别权重(
class_weight='balanced')。 - GPU 显存泄漏与失控:深度学习在评估与验证阶段,必须使用
with torch.no_grad():上下文管理器,防止前向计算构建并驻留计算图,导致CUDA out of memory崩溃。 - 分块重叠(Chunk Overlap):在构建大模型 RAG 时,简单的定长切片容易将句首主语与句末结论割裂。建议在相邻文本切片之间设置 10%~15% 的重叠区域,以保持语义的连续性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















