


Python3中字符串与字节编码转换详解

发布时间:2026-10-13 |
5人浏览过
本文详解Python3中str与bytes的编码转换机制。Python3默认使用Unicode,需通过encode方法转换为UTF-8或GBK等字节格式以用于存储传输。文章对比了UTF-8(通常24位)与GBK(通常16位)的位数差异,并提供Python交互环境下的具体代码示例,帮助开发者解决中文字符编码问题。
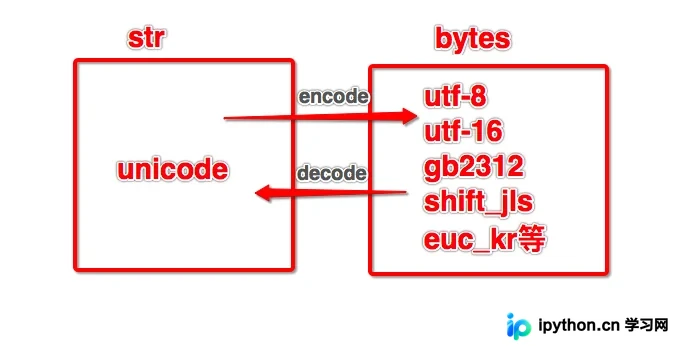
在Python3中,字符串(str)类型默认采用Unicode编码格式进行存储。
Unicode是一种32位编码标准,由于体积较大,不适合直接用于网络传输或文件存储,因此通常需要将其转换为UTF-8、GBK等更紧凑的编码格式。
基于上述原因,在Python3中进行数据交互时,必须将str类型显式转换为bytes类型。
在Python语言中,可以使用字符串对象的encode()方法来实现字符编码的转换。
具体的代码调用方式如下所示:
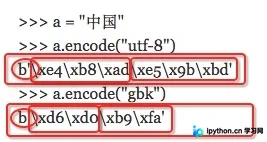
>>>a = "中国"
>>> a.encode("utf-8")
b'\xe4\xb8\xad\xe5\x9b\xbd'
>>> a.encode("gbk")
b'\xd6\xd0\xb9\xfa'
核心要点总结:
- 在Python3中,将str类型转换为bytes类型,本质上就是执行从Unicode编码到UTF-8、GBK等具体编码格式的转换过程。
- 结果以b'开头表示该对象为bytes类型,代表具体的字符编码格式。
- UTF-8编码默认情况下占用24位,即3个字节(每个字节8位,共3个8位16进制数)。
- GBK作为中国国家标准编码,默认情况下占用16位,即2个字节(2个8位16进制数字)。
以上内容介绍了Python3中解决中文字符编码问题的核心方法,希望能对大家有所帮助。如有疑问欢迎留言,小编会及时回复。感谢对本站的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















