



为什么幂函数不能只会算结果
在 C++ 里,幂运算看起来只是一个简单的 x^n 计算,但一旦进入数值计算、工程模拟、金融建模或图形程序,问题就不再只是“能不能算出来”,而是“结果是否可靠”。如果没有处理好负指数、极端输入、浮点误差、上溢和下溢,幂函数很容易在边界条件下失真,甚至直接产生 inf、nan 或未定义行为。
这篇文章按“实现方式、风险来源、安全策略、错误处理”四个层次整理 C++ 幂函数的使用方法。你不仅能看到 std::pow()、递归和迭代写法的差别,也能据此判断:什么时候直接调用标准库就够了,什么时候应该自己封装一层安全计算逻辑。
幂函数基础与三种常见实现
幂函数到底在算什么
幂函数通常表示为 f(x) = x^n,其中:
x是底数n是指数
对开发者来说,真正要关心的不只是数学定义,还包括指数是否为负、底数是否接近极值,以及采用哪种实现才能在性能和正确性之间取得平衡。
C++ 里常见的三种实现方式
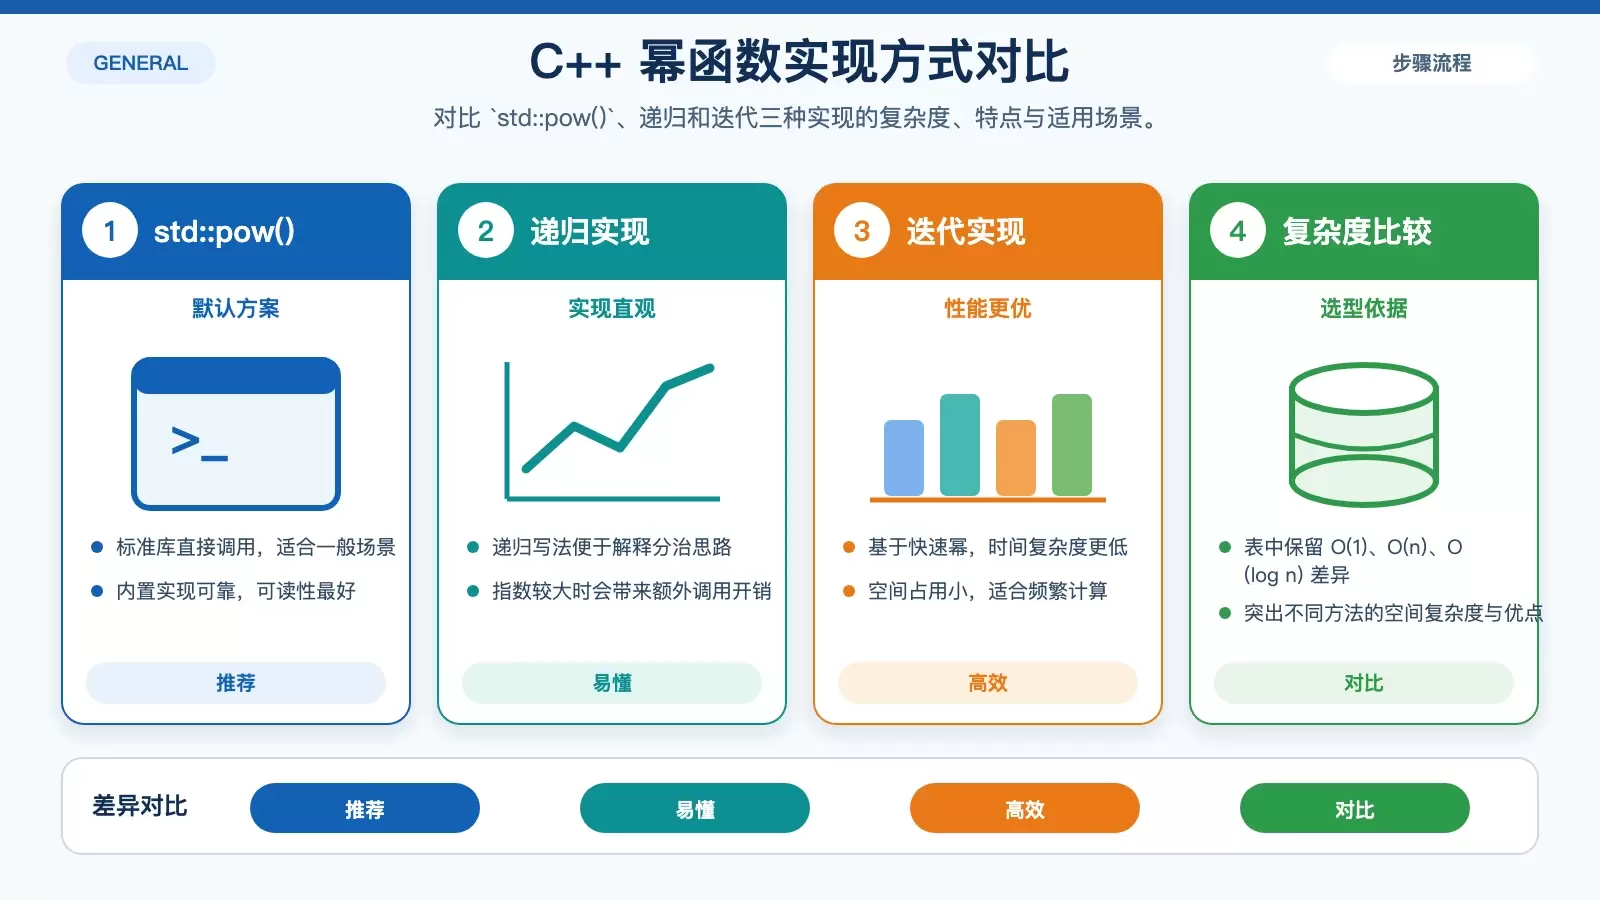
在 C++ 中,幂函数通常有三种实现路径:标准库、递归、自定义迭代。
1. 标准库 std::pow()
#include <cmath>

double result = std::pow(base, exponent);
std::pow() 的优点是调用直接、可读性高,而且由标准库提供,适合作为大多数普通场景的默认方案。
2. 递归实现
double powerRecursive(double base, int exponent) {
    if (exponent == 0) return 1;
    if (exponent < 0) {
        base = 1 / base;
        exponent = -exponent;
    }
    double half = powerRecursive(base, exponent / 2);
    if (exponent % 2 == 0) {
        return half * half;
    } else {
        return half * half * base;
    }
}
递归写法容易理解,也很适合说明“分治”思路,但在指数较大时会引入额外调用开销。原始资料中还出现了一段重复且损坏的递归代码,这里保留可用版本,便于直接阅读和使用。
3. 迭代实现
double powerIterative(double base, int exponent) {
    double result = 1.0;
    bool isNegative = exponent < 0;

    exponent = std::abs(exponent);

    while (exponent > 0) {
        if (exponent & 1) {
            result *= base;
        }
        base *= base;
        exponent >>= 1;
    }

    return isNegative ? 1.0 / result : result;
}
这类写法本质上是快速幂。它的时间复杂度更低,适合频繁计算或对性能较敏感的场景。
性能差异怎么选
| 方法 | 时间复杂度 | 空间复杂度 | 优点 |
|---|---|---|---|
std::pow() | O(1) | O(1) | 内置,可靠 |
| 递归 | O(n) | O(n) | 实现简单 |
| 迭代 | O(log n) | O(1) | 高效,内存占用低 |
如果你只是做一般数值计算,std::pow() 往往足够;如果你需要更明确地控制边界行为,迭代版通常更适合封装为“安全幂函数”。
一个基础示例
#include <iostream>
#include <cmath>

int main() {
    double base = 2.5;
    int exponent = 3;

    // 使用标准库
    double result1 = std::pow(base, exponent);

    // 使用自定义实现
    double result2 = powerIterative(base, exponent);

    std::cout << "结果 (std::pow): " << result1 << std::endl;
    std::cout << "结果 (自定义): " << result2 << std::endl;

    return 0;
}
这类示例适合验证实现是否一致,但在真实项目中,还需要额外处理输入合法性和异常情况。
把幂运算写安全:输入校验、溢出控制与流程设计
幂函数最常见的风险有哪些
原始资料提到的主要风险包括:
- 处理负指数
- 防止溢出
- 管理浮点精度
这些问题往往不会在“正常输入”下暴露,但会在极大指数、极小底数、非法参数或跨平台环境中集中出现。
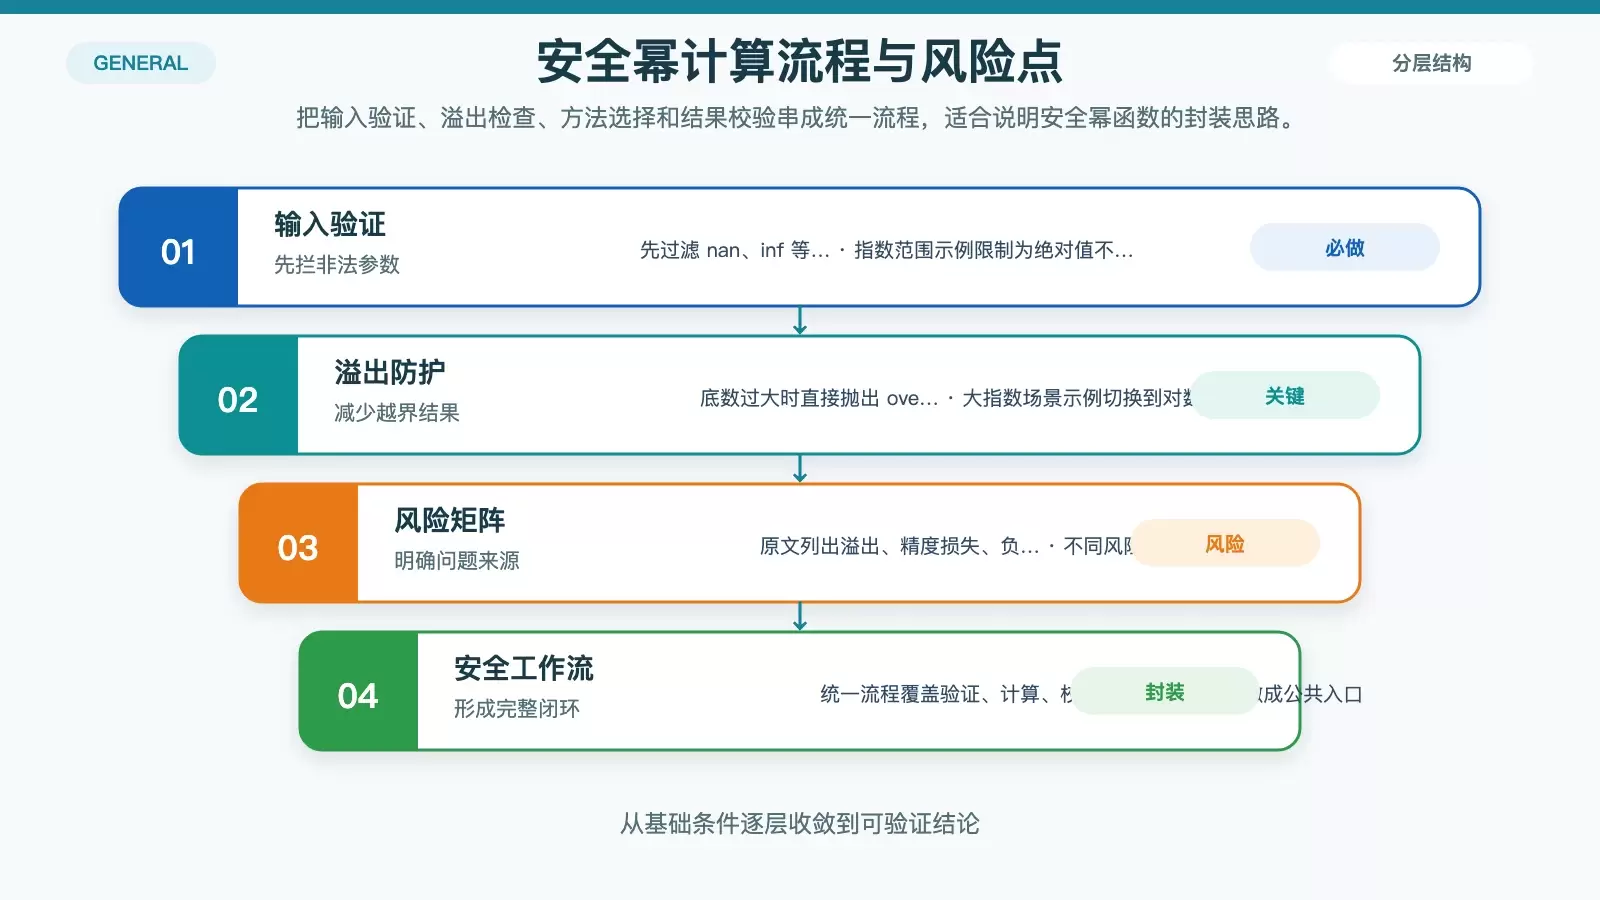
先做输入验证
bool validatePowerInput(double base, int exponent) {
    // 检查极端值
    if (std::isinf(base) || std::isnan(base)) return false;

    // 限制指数范围
    if (std::abs(exponent) > 1000) return false;

    return true;
}
这一步的作用很直接:先把明显不安全的输入拦在外面。比如 nan、inf,或者超出预期范围的指数,都不应该直接送进计算逻辑。
再处理溢出风险
double safePowerCalculation(double base, int exponent) {
    // 检查潜在溢出
    if (std::abs(base) > std::numeric_limits<double>::max()) {
        throw std::overflow_error("底数过大");
    }

    // 对于大指数使用对数方法
    if (std::abs(exponent) > 100) {
        return std::exp(exponent * std::log(base));
    }

    return std::pow(base, exponent);
}
这里展示的是一种常见防护思路:先检查明显越界的底数,再针对大指数切换到对数形式。不过要注意,std::exp(exponent * std::log(base)) 也有自己的适用前提,尤其在底数取值范围和定义域上需要谨慎判断。
用风险矩阵梳理问题来源
| 风险类型 | 潜在影响 | 缓解策略 |
|---|---|---|
| 溢出 | 无穷大/非数字结果 | 限制输入范围 |
| 精度损失 | 计算不准确 | 使用适当的数据类型 |
| 负指数 | 意外除法 | 实施特殊处理 |
这个表格的价值在于把“数学问题”转成“工程判断”:你要不要限制输入、是否要换算法、遇到异常结果是返回错误还是抛异常,都可以从这三类风险展开。
一套完整的安全计算流程
flowchart TD
    A[输入参数] --> B{验证输入}
    B -->|有效| C[检查溢出可能性]
    B -->|无效| D[拒绝计算]
    C --> E[选择计算方法]
    E --> F[执行计算]
    F --> G[验证结果]
    G --> H{结果安全吗?}
    H -->|是| I[返回结果]
    H -->|否| J[处理错误]
如果项目里幂计算调用很多,最实用的做法通常不是在每个地方分别判断,而是封装一个统一入口,把“验证、计算、校验、报错”全部纳入同一条流程。
进一步封装为模板安全幂函数
template<typename T>
T safePower(T base, int exponent) {
    // 编译时类型检查
    static_assert(std::is_arithmetic<T>::value,
                  "仅支持算术类型");

    // 运行时安全检查
    if (!validatePowerInput(base, exponent)) {
        throw std::invalid_argument("无效的幂计算");
    }

    // 高效幂计算
    T result = 1;
    bool negative = exponent < 0;
    exponent = std::abs(exponent);

    while (exponent > 0) {
        if (exponent & 1) {
            result *= base;
        }
        base *= base;
        exponent >>= 1;
    }

    return negative ? T(1) / result : result;
}
这段代码把类型约束、输入检查和快速幂计算合在了一起,是比较接近“可复用工具函数”的版本。资料中给出的建议也很明确:始终验证输入、使用类型安全实现、处理潜在计算错误,并根据输入范围选择合适方法。
出错后怎么办:异常、日志与错误码设计
先区分错误类型
| 错误类型 | 描述 | 潜在影响 |
|---|---|---|
| 溢出 | 结果超出数据类型限制 | 计算错误 |
| 下溢 | 结果太小无法表示 | 精度损失 |
| 定义域错误 | 无效的输入参数 | 计算失败 |
| 精度错误 | 浮点不精确 | 细微的计算错误 |
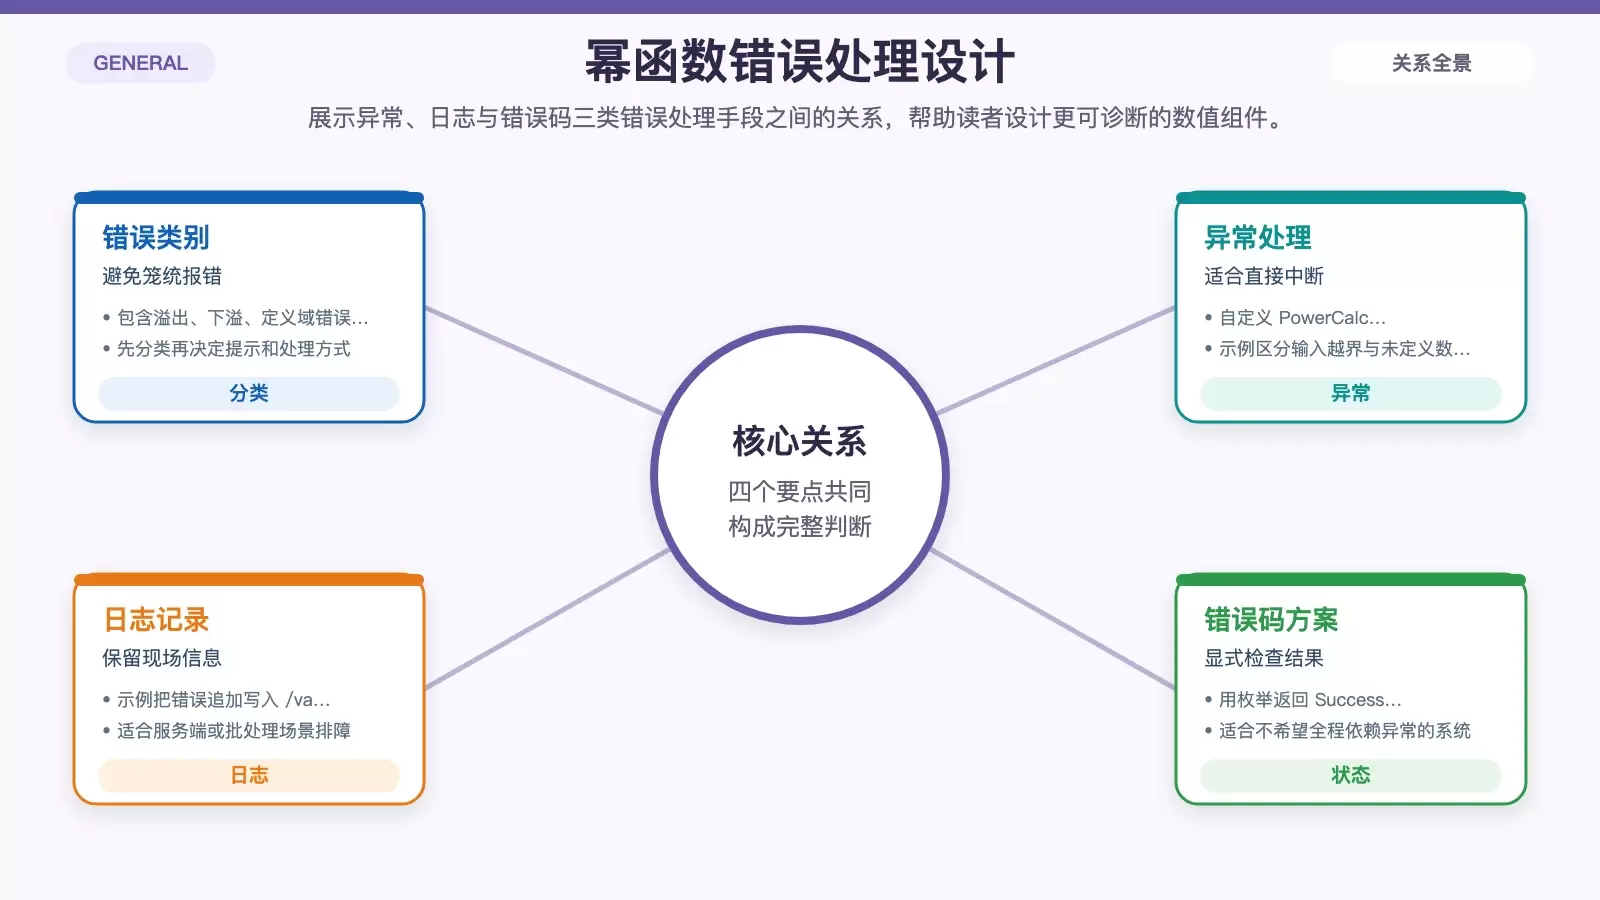
只有把错误分类讲清楚,后面的异常消息、日志内容和返回状态才有意义。否则线上排查时,所有问题都会被模糊成“算错了”。
用异常处理非法输入和危险计算
class PowerCalculationException : public std::runtime_error {
public:
    PowerCalculationException(const std::string& message)
        : std::runtime_error(message) {}
};

double safePowerCalculation(double base, int exponent) {
    // 验证输入范围
    if (std::abs(base) > 1e308 || std::abs(exponent) > 1000) {
        throw PowerCalculationException("输入参数超出安全范围");
    }

    // 处理特殊情况
    if (base == 0 && exponent <= 0) {
        throw PowerCalculationException("未定义的数学运算");
    }

    try {
        return std::pow(base, exponent);
    } catch (const std::overflow_error& e) {
        throw PowerCalculationException("计算导致溢出");
    }
}
这里的重点不是“抛异常”本身,而是把不同错误变成能被调用方理解的信息,例如“输入越界”还是“数学上未定义”,这两类问题的处理方式往往完全不同。
错误检测流程可以单独设计
flowchart TD
    A[幂计算输入] --> B{输入验证}
    B -->|有效| C[执行计算]
    B -->|无效| D[引发输入错误]
    C --> E{结果有效吗?}
    E -->|是| F[返回结果]
    E -->|否| G[引发计算错误]
这类流程适合在公共数学库或基础组件中实现,让调用方不必关心每一种底层细节,只需处理成功或失败两种出口。
日志记录机制怎么加
class ErrorLogger {
public:
static void logError(const std::string& errorMessage) {
std::ofstream logFile("/var/log/power_calculations.log", std::ios::app);
if (logFile.is_open()) {
logFile << "[" << getCurrentTimestamp() << "] "
<< errorMessage << std::endl;
logFile.close();
}
}
private:
static std::string getCurrentTimestamp() {
auto now = std::chrono::system_clock::now();
std::time_t currentTime = std::chrono::system_clock::to_time_t(now);
return std::ctime(¤tTime);
}
};
记录日志的意义主要体现在排障阶段。尤其是当幂函数出现在批处理、服务端计算或工程模拟程序里时,单靠终端输出很难复盘问题发生时的输入条件。
不想全用异常,也可以返回错误码
enum class PowerCalculationResult {
    Success,
    OverflowError,
    UnderflowError,
    DomainError
};

struct PowerCalculationOutput {
    double result;
    PowerCalculationResult status;
};

PowerCalculationOutput robustPowerCalculation(double base, int exponent) {
    PowerCalculationOutput output;

    try {
        output.result = std::pow(base, exponent);
        output.status = PowerCalculationResult::Success;
    } catch (const std::overflow_error&) {
        output.result = 0.0;
        output.status = PowerCalculationResult::OverflowError;
        ErrorLogger::logError("幂计算中发生溢出");
    }

    return output;
}
错误码方式更适合对异常敏感的环境,或者需要显式状态流转的系统。它的好处是行为可预测,代价是调用方必须认真检查返回值。
一个完整的错误处理示例
int main() {
    try {
        double result = safePowerCalculation(1.5, 1000);
        std::cout << "计算结果:" << result << std::endl;
    } catch (const PowerCalculationException& e) {
        std::cerr << "幂计算错误:" << e.what() << std::endl;
        ErrorLogger::logError(e.what());
    }

    return 0;
}
这一层把异常输出和日志落盘结合起来,适合需要定位线上问题的程序。原始资料还提到几条实践建议:优先做输入验证、有效使用异常机制、实施全面日志记录,并提供清晰的错误通信。
实用结论:什么时候用哪种方案
如果只是常规计算,优先使用 std::pow(),它简单而且可靠;如果你需要控制性能和边界行为,自定义迭代版快速幂更有优势;如果幂运算位于核心计算路径,最好再加上一层统一的安全封装,把输入验证、溢出检查、结果校验和错误处理收拢到一起。
从原始内容给出的方向看,真正“安全”的幂函数并不是某一段特定代码,而是一套完整机制:根据场景选实现、提前约束输入、在异常情况下给出可诊断的反馈。这样写出来的数值逻辑,才能在真实项目里长期稳定运行。















