



在 CentOS 上盯住一个 C++ 应用是否正常运行,往往不是靠单一工具就能解决。临时排查时,你需要快速看到进程和资源占用;进入生产环境后,又要补上日志、告警、历史趋势和网络状态,才能把问题定位得更准。
这篇文章把常见监控手段按场景重新整理了一遍:先看最直接的命令行观察,再到 systemd 与日志,再延伸到性能分析、自定义脚本、第三方平台和容器网络监控。读完后,你可以判断哪些工具适合临时排障,哪些更适合长期运行的 C++ 服务。
先用命令行确认进程和资源占用
如果你只是想先判断应用是不是还活着、是否突然吃满 CPU 或内存,命令行工具通常是最快的入口。
top / htop:实时看资源是否异常
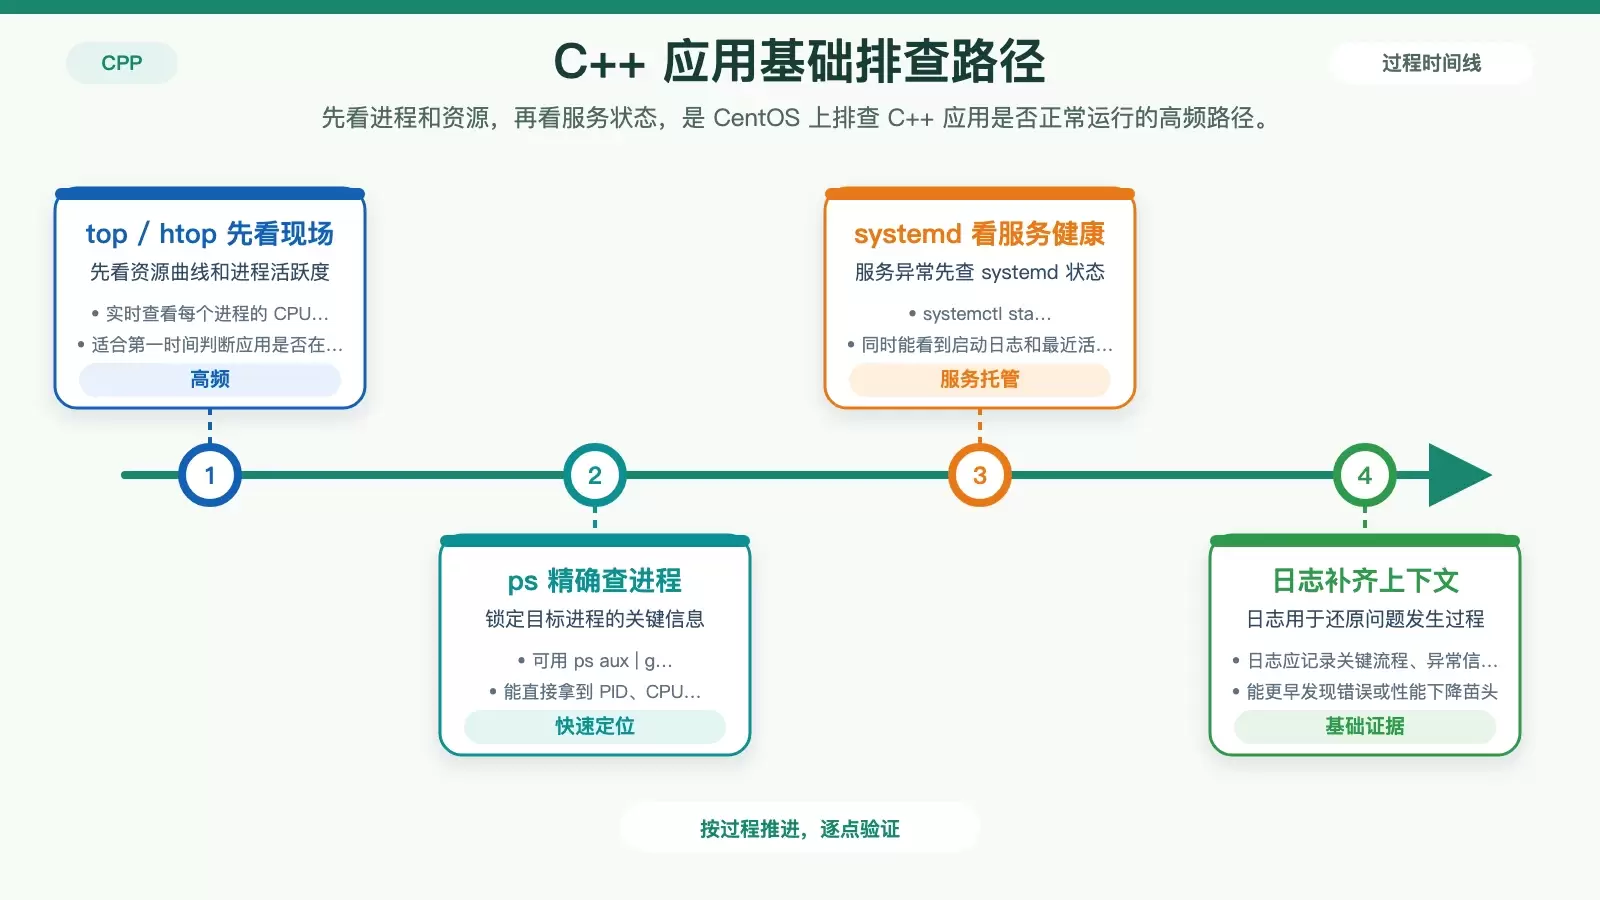
top 和 htop 是最直接的资源监控工具。运行后可以实时看到每个进程的 CPU 和内存占用,适合第一时间确认你的 C++ 应用是不是正在持续消耗资源。
如果你更在意交互体验,htop 会更顺手一些,它支持鼠标操作和树状视图,查看父子进程关系时更方便;而 top 则几乎在所有常见环境里都能直接用。
top
htop
ps:快速定位指定应用的进程信息
当你只想查看某个目标进程,而不是翻完整个实时列表时,ps 更高效。配合 grep 过滤应用名,可以快速拿到 PID、CPU、内存和运行时长等关键信息。
ps aux | grep your_cpp_app这种方式很适合临时排查,例如确认应用是否已经启动、是否存在多个实例,或者先找到 PID 再继续做更深入的分析。
把 systemd 和日志接入日常排障
如果 C++ 应用已经作为服务运行,那么仅靠看进程还不够。服务状态和程序日志,往往能更快说明它为什么异常。
systemd:直接查看服务状态和最近活动
如果你已经把应用注册成 systemd 服务,那么 systemctl status 基本就是排查入口。它可以同时展示服务是否正在运行、最近的启动日志,以及近期活动记录。
systemctl status your_cpp_app.service这种方式适合排查服务拉起失败、异常退出、重启频繁等问题,尤其适合由运维脚本或系统启动流程托管的 C++ 程序。
日志文件:最基础也最可靠的运行证据
日志输出仍然是监控运行状态最基础、也最可靠的手段。只要应用在代码里把关键流程、错误信息和时间点记录清楚,很多问题不用附加工具就能先缩小范围。
实践中,建议至少记录关键节点、异常信息和时间戳。日志粒度可以按场景调整:开发期可以更细,生产环境则更关注稳定性和定位效率。定期检查日志文件,往往能比资源图表更早发现错误、异常或性能下降的苗头。
性能瓶颈要交给分析工具
当问题已经不是“进程在不在”,而是“为什么慢、为什么耗资源、有没有内存问题”时,就该进入性能分析阶段。
gprof、valgrind、perf 分别适合看什么
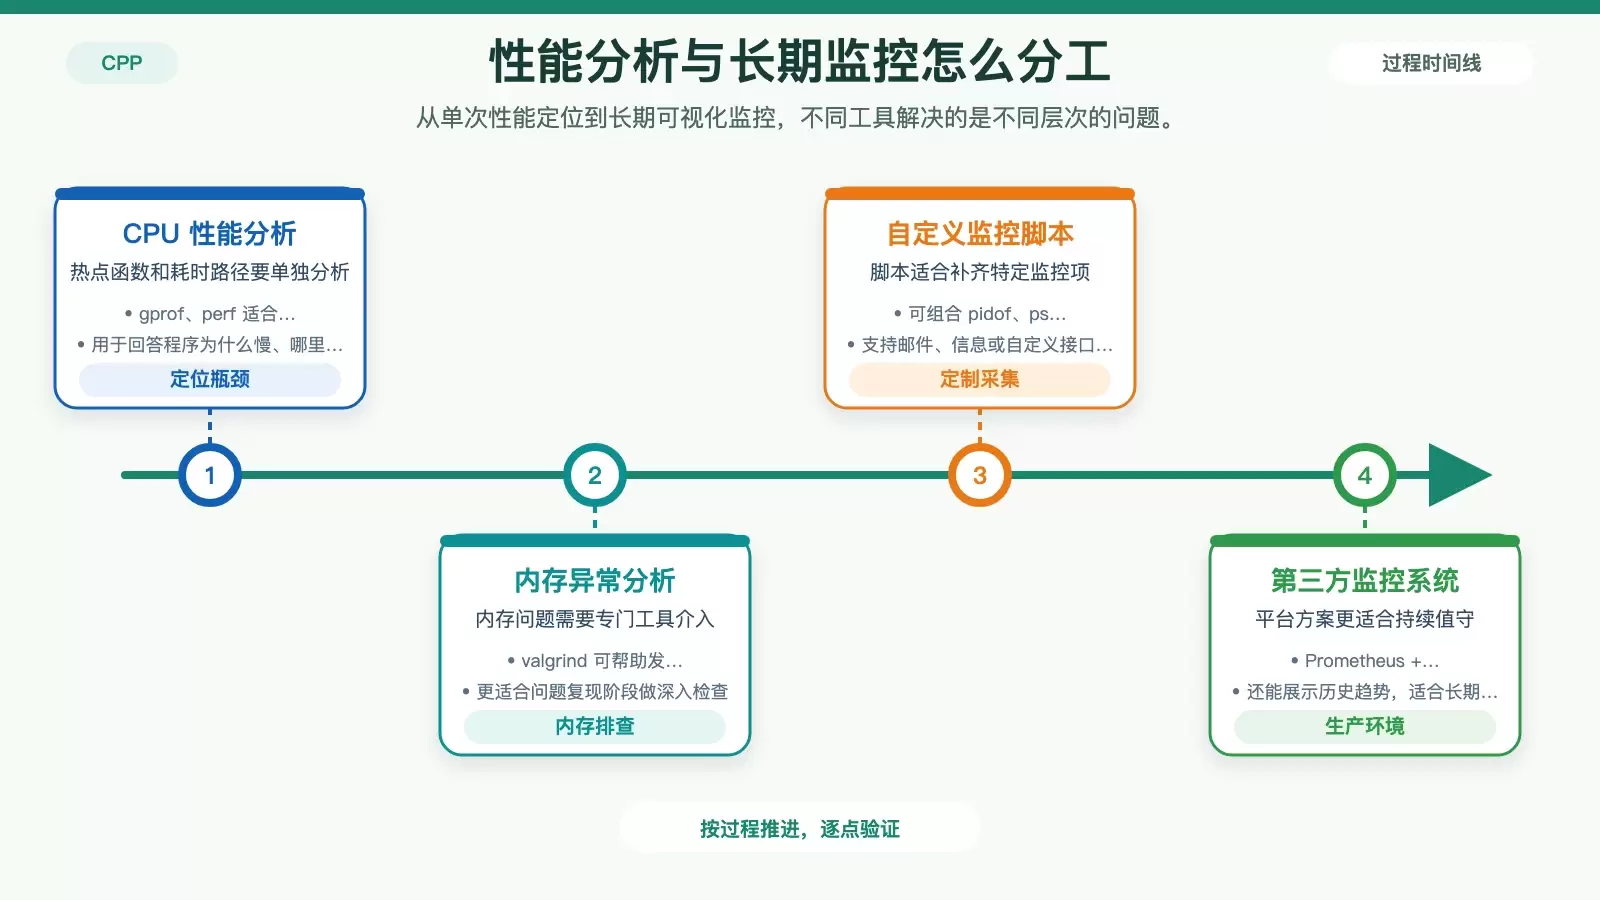
gprof、valgrind、perf 这类工具更适合深挖性能瓶颈。它们可以帮助你分析 CPU 热点、内存泄漏、函数调用耗时等细节,是做优化时常用的一组工具。
如果你怀疑热点函数导致 CPU 异常,可以优先考虑 perf 或 gprof;如果问题更像是内存泄漏、非法访问或堆使用异常,valgrind 往往更有针对性。它们不一定要全天候在线,但在问题复现阶段价值很高。
需要长期监控时,再上脚本和平台
命令行和日志适合人工排查,但如果应用需要长期运行,就要考虑自动采集、告警和历史趋势展示。
自定义监控脚本:灵活拼出自己的监控项
当现成工具不能完全覆盖需求时,可以自己写监控脚本。常见做法是组合 pidof、ps、vmstat、iostat 等命令,定期采集 CPU、内存、磁盘 I/O 等数据,再通过邮件、信息或自定义接口发送告警。
这种方式最大的优势是灵活。比如你可以只监控某个关键进程的内存波动,也可以把业务侧指标和系统指标放在一起采集,适合中小规模环境或有明确定制需求的服务。
Prometheus + Grafana、Nagios:适合生产环境的长期方案
如果团队已经进入多机器、多服务、需要历史趋势和集中告警的阶段,第三方监控系统通常更合适。比如 Prometheus + Grafana、Nagios 等,都能提供更完整的监控能力。
这类方案不只是采集性能指标,还能配置告警规则、可视化展示历史趋势,更适合长期、多维度监控。对于生产环境中的 C++ 应用,它们能把“是否异常”升级为“异常发生在什么时候、持续了多久、影响了哪些指标”。
容器和网络场景别漏看
如果应用运行在容器里,或者本身就是网络通信密集型程序,那么还要补上容器资源和网络状态这两个维度。
容器化部署时,用 docker stats 看资源占用
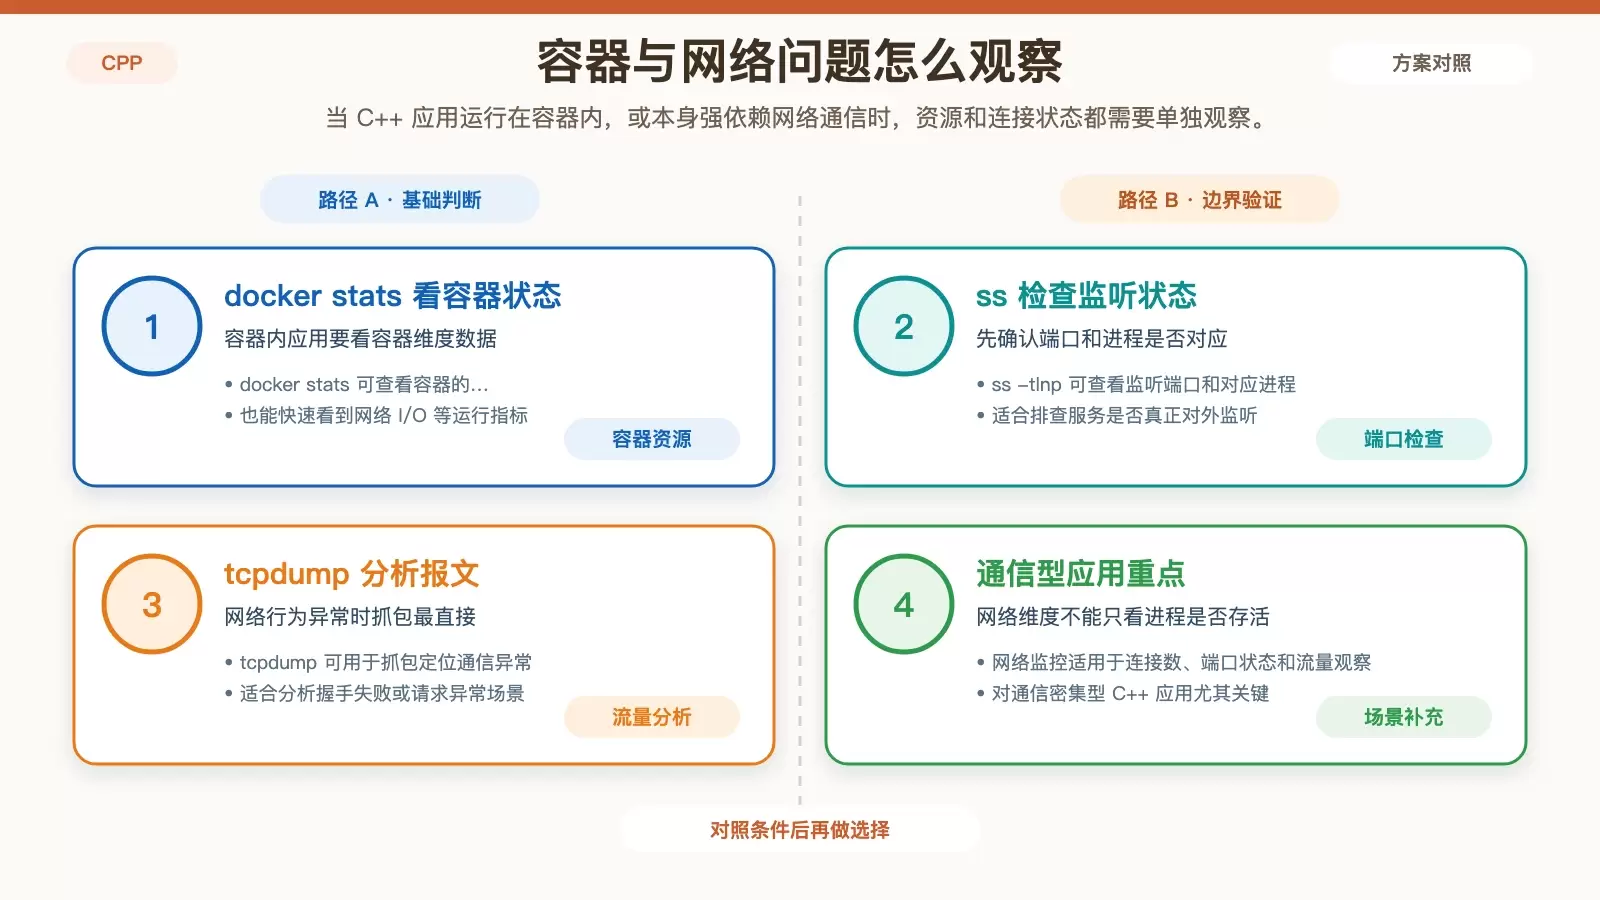
当 C++ 应用跑在 Docker 或其他容器环境里时,直接看宿主机进程未必够用。此时可以先用 docker stats 观察容器维度的 CPU、内存、网络 I/O 等资源使用情况。
docker stats如果后续再配合容器编排工具使用,通常还能实现更细粒度的监控,适合服务拆分较多的环境。
netstat、ss、tcpdump:定位连接和流量问题
对于涉及网络通信的 C++ 应用,网络层面的工具非常关键。netstat、ss、tcpdump 可以帮助你观察连接数、端口状态和流量情况。
例如,使用 ss -tlnp 可以查看监听端口;如果怀疑请求异常、握手失败或流量不稳定,再用 tcpdump 抓包分析会更直接。
ss -tlnp
tcpdump
怎么组合这些手段更实用
选哪种监控方式,最终还是取决于应用特点和团队需求。多数情况下,真正有效的做法不是单选,而是组合使用。
一个比较常见的搭配是:先用 top/htop、ps 和 systemctl status your_cpp_app.service 做快速排查;再靠日志文件补齐上下文;遇到性能问题时引入 gprof、valgrind、perf;需要长期监控时,再接入脚本或 Prometheus + Grafana、Nagios 这类平台。
换句话说,命令行工具负责快速看现场,日志负责还原过程,性能工具负责找根因,平台型监控负责长期值守。把这些视角拼起来,才更接近 C++ 应用在 CentOS 上的完整运行状态图。















