



在 Go 的数据处理链路里,最常见的难题之一,是上游只能不断写出数据,下游却要求拿到一个 io.Reader。很多实现会先用 bytes.Buffer 把内容攒起来再交给后续环节,但这个方案只适合小体量数据,一旦碰到导出、压缩、上传这类长链路任务,内存压力会迅速放大。本文从这个典型痛点切入,拆开 io.Pipe 的同步特性、使用方式与陷阱,帮助你判断什么时候该用缓冲,什么时候该直接切到流式传输。
大数据流转时,为什么 bytes.Buffer 容易出问题
假设有这样一个场景:从数据库导出海量 JSON,压缩后再上传到对象存储,例如 S3。
很多人最先写出的流程通常是这样:
- 先把 JSON 全部写进一个
bytes.Buffer。 - 再把
Buffer的内容交给压缩逻辑。 - 最后执行上传。
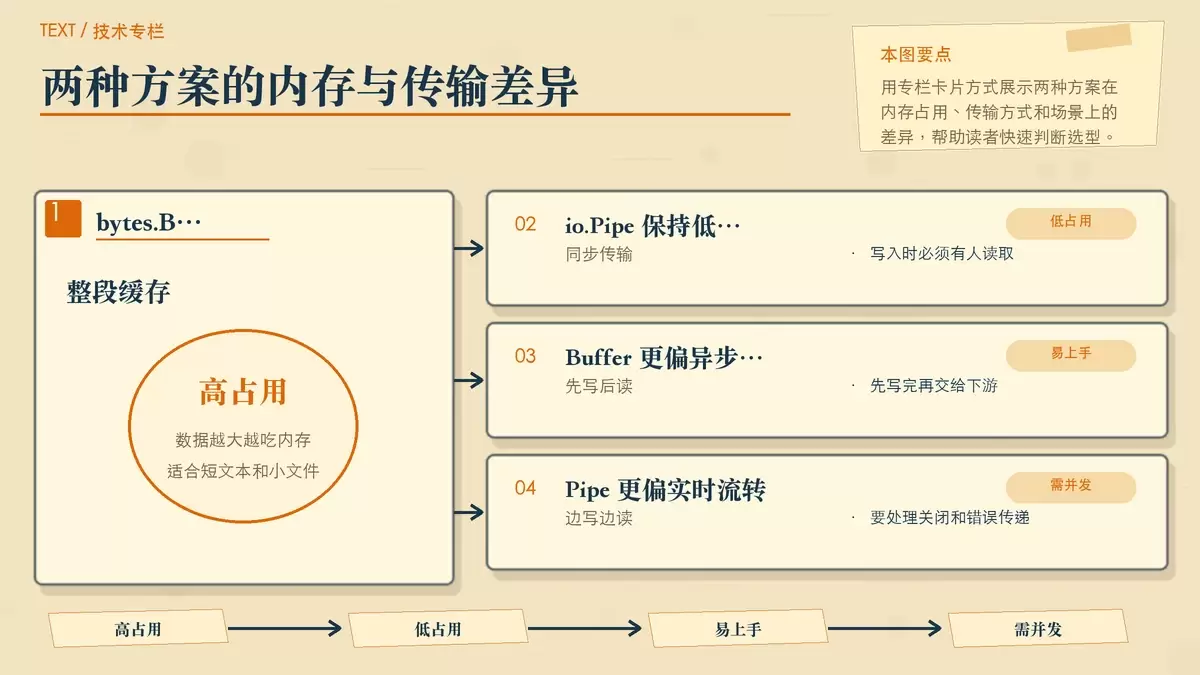
这个思路的问题不在“能不能跑”,而在“数据一大就撑不住”。如果数据量来到 10GB,程序往往在第一步就已经逼近 OOM。因为 bytes.Buffer 的本质是把数据完整留在内存里,数据越大,占用越高,内存曲线会随之线性增长。
也正因为如此,当链路目标从“拼字符串”变成“传输超大数据”时,继续依赖整块缓存往往不是一个稳妥选择。你真正需要的,是一边生产、一边消费的数据通道。
io.Pipe 到底解决了什么问题
io.Pipe 提供的正是这样一种能力:在内存里建立一个同步管道,把写端和读端直接连起来。
pr, pw := io.Pipe()它会返回两个对象:*io.PipeReader 和 *io.PipeWriter。
理解 io.Pipe,关键只要抓住一点:同步阻塞。
当数据写入 PipeWriter 时,如果另一端还没有读取,写操作就会阻塞;反过来,读端也依赖写端持续提供数据。这意味着它不是“先全部写完再交付”,而是“写多少,读多少”,数据会沿着管道即时流动,中间不需要一个把全部内容存住的内存中转区。
从结果上看,这种方式特别适合把一个只会往外写的组件,桥接到另一个只接受 io.Reader 的接口上。它处理的是“接口对接”的问题,同时也顺带解决了大对象缓存带来的内存负担。
实战写法:把生成中的 JSON 直接变成 io.Reader
一个典型用法,是在 JSON 仍在生成时,就把它交给下游消费者,而不是等整份内容都落在内存里。
func StreamData() io.Reader {
    pr, pw := io.Pipe()

    // 必须开启新的 Goroutine 写入,否则会死锁
    go func() {
        defer pw.Close()

        // 模拟大规模数据
        data := map[string]string{"status": "ok", "message": "processing large stream..."}

        // 直接将 Encoder 对接到 PipeWriter
        if err := json.NewEncoder(pw).Encode(user); err != nil {
            pw.CloseWithError(err) // 优雅地传递错误
        }
    }()

    return pr
}
这段代码的核心不是“把 JSON 编码出来”,而是把 json.NewEncoder(pw) 直接绑定到 PipeWriter。这样一来,编码器每产出一段数据,读端就能立刻读走;无论总数据量有多大,程序都不需要先攒出一整份结果。
这类写法特别适合以下场景:
- 边生成边压缩;
- 边导出边上传;
- 一个组件只能提供
io.Writer,另一个组件却只接受io.Reader。
需要注意的是,示例里虽然声明了 data,但真正编码时调用的是 json.NewEncoder(pw).Encode(user)。这里保留原始代码事实不变,但在实际项目中,你需要确保被编码的变量与前文准备的数据一致,否则代码本身会有未定义标识符的问题。
最容易踩的坑:死锁与错误传递
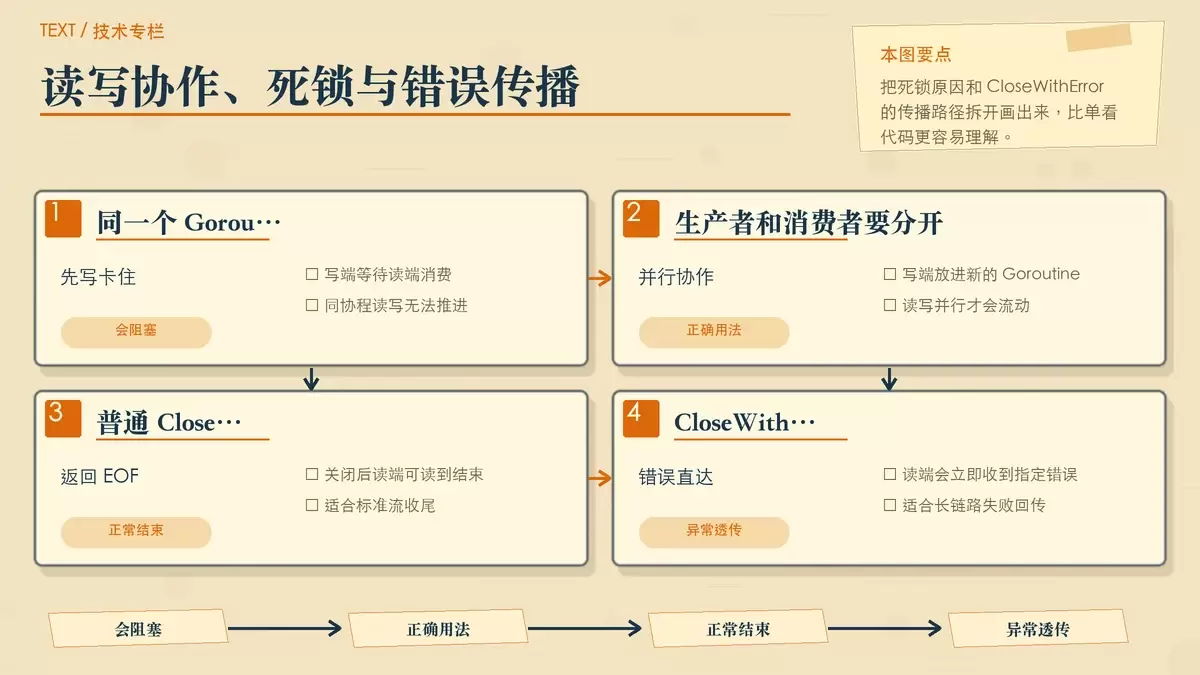
为什么同一个 Goroutine 里读写会卡死
io.Pipe 最常见的误用,是在同一个 Goroutine 里先写后读:
// 错误示范:这行代码会永远阻塞
pr, pw := io.Pipe()
pw.Write([]byte("hello")) // 阻塞,等待有人读
data, _ := io.ReadAll(pr) // 永远执行不到这里原因很直接:pw.Write 会等待读端消费数据,而代码里的读操作还没机会执行到,于是两边互相等待,程序就卡住了。
所以,io.Pipe 基本原则可以简单记成一句话:生产者和消费者必须位于不同的 Goroutine 中。只有读写并行发生,这条同步管道才真正流动起来。
CloseWithError 为什么重要
流式处理还有一个容易被忽略的问题:如果生产过程中途出错,消费者怎么知道?
普通的 io.EOF 只能表达“数据结束了”,却不能说明“结束是正常完成,还是半路失败”。这时就应该用 CloseWithError(err error)。
当写端调用这个方法后,读端的 Read 会立即收到对应错误。对于压缩、上传、远程调用这类长链路任务,这一点很关键,因为它能让下游及时终止,而不是继续把一次失败任务误判成正常结束。
怎么选:io.Pipe 和 bytes.Buffer 的适用边界
| 维度 | bytes.Buffer | io.Pipe |
|---|---|---|
| 内存占用 | 随数据量线性增长 (O(N)) | 恒定极低 (O(1)) |
| 数据传递 | 异步(先写后读) | 同步(写的时候必须读) |
| 适用场景 | 短文本拼接、小文件缓存 | 大文件流转、实时转换、跨接口对接 |
| 复杂度 | 极低 | 中等(需处理并发) |
如果任务只是做少量字符串拼接、暂存一个不大的文件,bytes.Buffer 依然是简单直接的方案,开发成本也更低。
但如果你面对的是持续生成的大体量数据,或者需要把多个基于 Reader/Writer 的组件串成一条处理链,那么 io.Pipe 的价值就会非常明显。它牺牲了一部分并发处理复杂度,换来的是稳定的内存表现和更自然的流式结构。
换句话说,判断标准并不复杂:数据是否必须整体落内存、上下游是否能同步协作、接口是否天然一写一读。只要这三个条件里有两个成立,就值得优先考虑 io.Pipe。
什么时候该优先考虑 io.Pipe
当一个函数要求传入 io.Reader,而你手上拿到的却是只能不断写数据的 io.Writer 输出钩子时,io.Pipe 往往就是最合适的桥接方式。
它尤其适合下面几类任务:
- 数据库导出后直接压缩、再直接上传;
- 实时生成的 JSON、CSV、日志流直接交给网络层;
- 需要把多个标准库组件串成一条“边产出边消费”的流水线。
它的代价也同样明确:你必须认真处理 Goroutine 协作、关闭时机和错误传播。一旦忽略这些细节,流式处理的优势就会变成阻塞和排障成本。
从设计理念上看,io.Pipe 很符合 Go 在并发上的一贯思路:不要把所有数据先堆在共享内存里,再让别人来取;而是让数据沿着通信通道直接流向需要它的地方。在需要控制内存、串联接口、处理大数据流的场合,这种方式通常比 bytes.Buffer 更稳,也更贴近 Go 的标准库哲学。















