



在 Go 后台服务里,有界 Channel 常被拿来做日志、埋点和异步分发缓冲,但它一旦在流量高峰时被塞满,问题往往不是“变慢”这么简单,而是写入方直接阻塞,连带把上游协程越堆越多。要避免这种情况,关键不是一味扩大缓冲,而是把“写不进去时怎么办”设计清楚:先用 select + default 把阻塞改成可判断的失败,再根据数据重要性决定丢弃、落盘还是告警,整条链路才算真正可用。
队列满载时,为什么微服务会被拖垮
在业务代码里,用有界通道做异步缓冲很常见,比如日志上报、埋点收集、消息整理后再投递给下游。正常流量下,这种模式吞吐高、写法也简单;但遇到外部 QPS 突增,而消费者处理速度又跟不上时,缓冲区会很快被塞满。
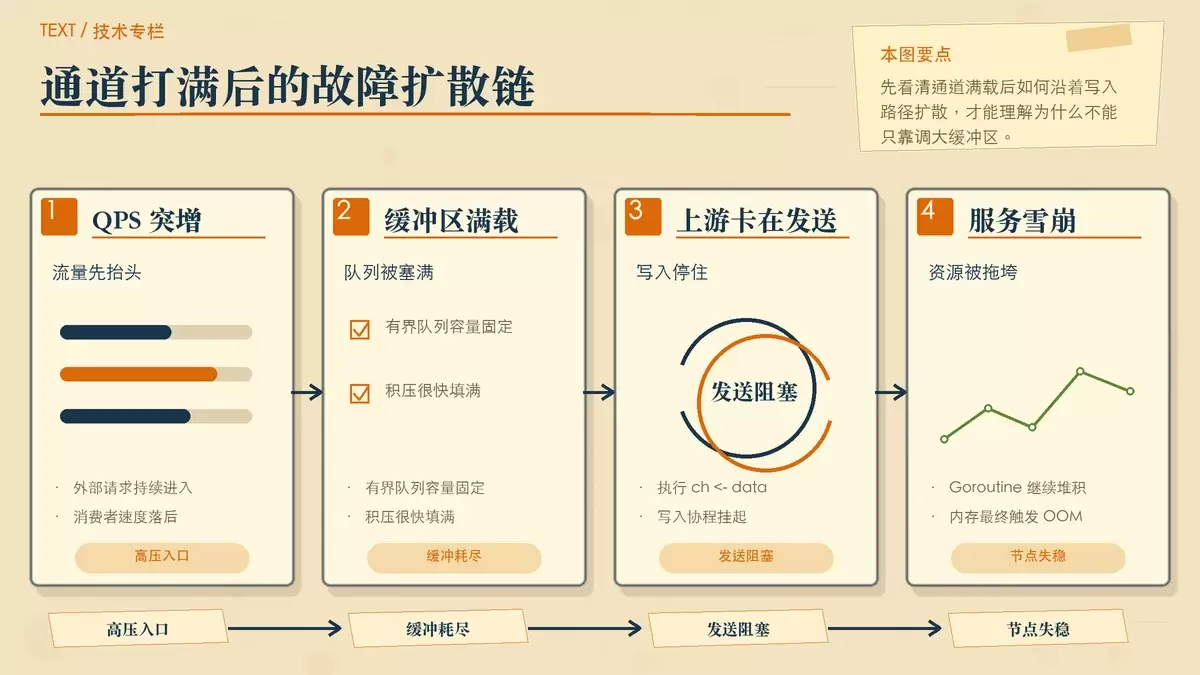
这时如果继续执行 ch <- data,默认行为就是阻塞。问题在于,请求不会因为通道满了就自动停下,上游还会继续创建新的 Goroutine 处理进入的流量,结果大量协程一起卡在写通道这一步。堆积一旦失控,内存会迅速上涨,最终把节点拖进 OOM,微服务实例也就随之失去响应。
这也是为什么线上排查高并发故障时,看到 Goroutine 大量堆在 Channel send 上,往往意味着问题已经不只是“队列长度不够”,而是系统缺少过载时的退路。
非阻塞发送为什么更适合高峰期
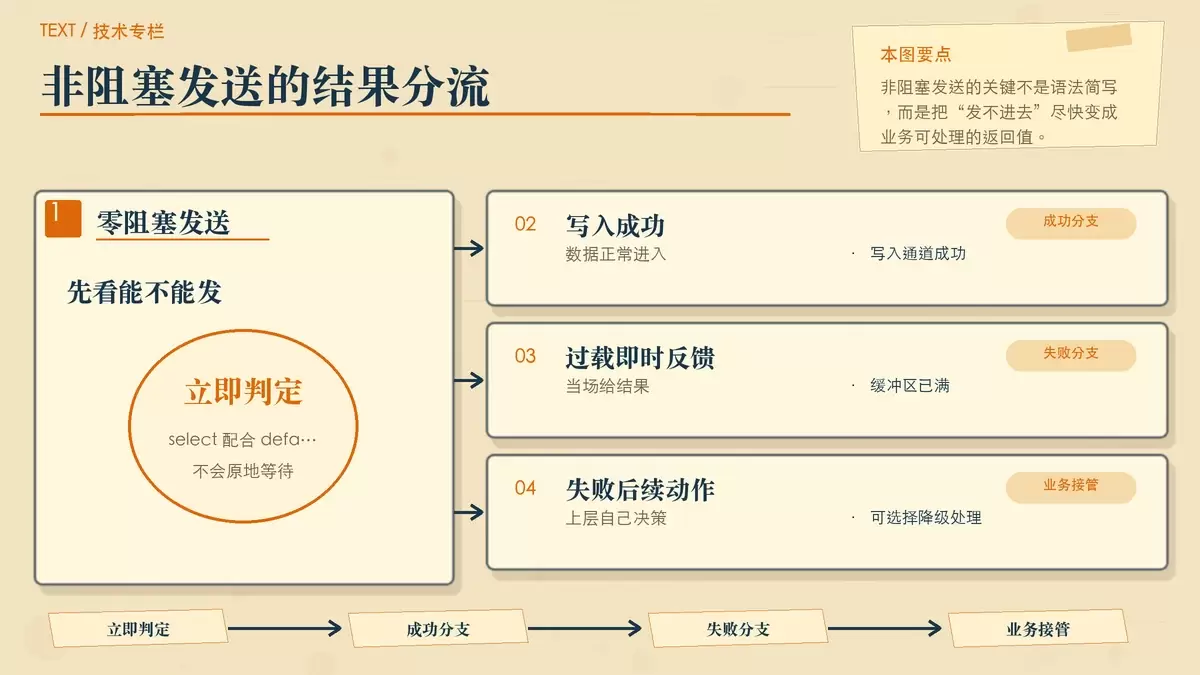
很多人的第一反应是调大通道容量,但这通常只能延后问题暴露的时间,并不能改变“写满后继续阻塞”的本质。更稳妥的方式,是把发送动作改成非阻塞:能写就写,写不进去立刻返回,让上层逻辑自己决定下一步。
Go 在这件事上并不只是语法层面提供了 select 和 default。对于非阻塞发送,编译器和运行时还做了快速路径优化,底层会走到 runtime.selectnbsend 相关逻辑。原文给出的关键判定如下:
// 编译期重写后的无锁快速路径判定(来自 runtime/select.go)
if !block && c.closed == 0 && ((c.dataqsiz == 0 && c.recvq.first == nil) ||
    (c.dataqsiz > 0 && c.qcount == c.dataqsiz)) {
    return false
}
这段逻辑的重点是:当发送本身就是非阻塞,并且运行时已经确认当前没有可接收方、或者缓冲区已经满了,就直接 return false。也就是说,这类“发不进去”的判断可以在非常靠前的位置完成,避免无谓地进入阻塞等待。
从业务角度看,这种设计的价值非常直接:系统在超载时得到的是一个立即可感知的失败信号,而不是一串被卡死的协程。对高并发服务来说,能尽早失败,往往比盲目硬顶更有价值。
实战写法:用 select 和 default 封装安全发送
把原理落到代码里,其实不复杂。常见做法是封装一个非阻塞发送函数,把“是否写入成功”明确返回给调用方:
// SafeSend 实现通道的非阻塞安全写入
func SafeSend(ch chan<- string, data string) bool {
    select {
    case ch <- data:
        return true
    default:
        return false // 队列满了直接走人,协程绝不卡死
    }
}这个写法的好处在于,业务层终于可以把“发成功”和“发失败”当成两条显式分支来处理,而不是默认所有请求都要在这里傻等。只要下游过载,SafeSend 就会马上落到 default 分支并返回 false,调用方随后可以马上降级、记日志或切换补偿路径。
这里真正改变的,不只是代码风格,而是系统面对高峰时的行为模式:阻塞模型会把压力沿调用链向上扩散,非阻塞模型则会把压力截断在入口附近,尽快转化成可观测、可处置的失败结果。
写不进去之后,怎么做降级和补偿
非阻塞发送解决的是“别把写入方卡死”,但它不会自动替你决定“失败后该怎么办”。这一步要结合数据的重要性来设计。
如果只是普通监控、埋点之类的弱一致性数据,直接丢弃通常可以接受,代价最小。但如果是关键业务事件、账务相关消息或必须追溯的数据,简单丢掉就会把问题从系统稳定性转移成业务正确性问题。
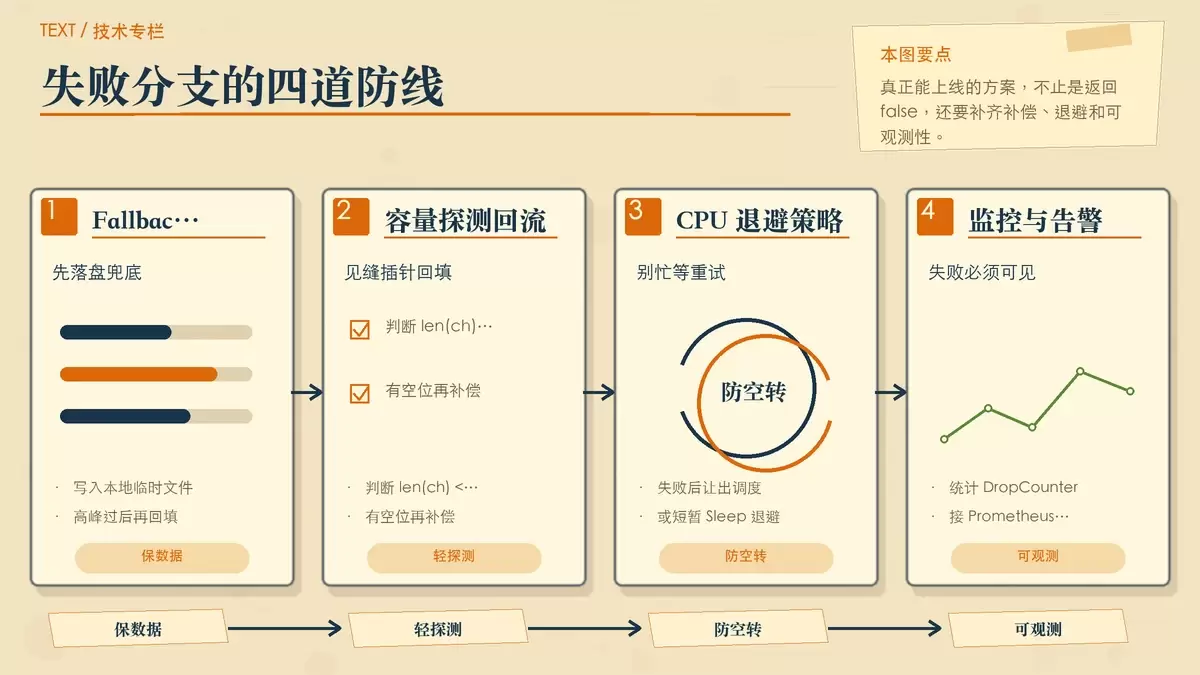
一种更实用的处理方式,是在发送失败时启用 Fallback to disk。也就是先把数据序列化后写入本地临时文件,等流量洪峰过去,再由后台协程择机回填到通道中。原文中的回填逻辑如下:
// 异步数据补偿回填逻辑
for len(ch) < cap(ch) {
    data, err := readNextLine(file)
    if err != nil {
        break
    }
    ch <- data // 趁着通道有空,赶紧回填
}
len(ch) < cap(ch) 在这里的作用,是做一个足够轻量的容量探测:只有通道还有可用空间时,才继续往里补。这样补偿过程就不会和正常写入互相踩踏,而是利用空隙平滑回流。
这类方案不一定适合所有业务,但它提供了一个很重要的思路:高峰期先保活,数据完整性再通过补偿链路追回。比起让所有协程一起卡死,这种处理方式更符合线上系统的优先级。
两类常见坑:CPU 空转与状态不可见
非阻塞发送不是万能钥匙,用得不当也会制造新的问题。最常见的有两类。
死循环重试会把 CPU 打满
如果把 SafeSend 套进一个没有退避的死循环里,发送失败后立刻再次尝试,单核 CPU 很容易被打到 100%。这类代码表面上没阻塞,实际上是在忙等。
因此,失败后至少要显式让出调度机会,比如配合 runtime.Gosched(),或者做一个很短的 Sleep 退避。核心原则很简单:失败分支必须有限速手段,不能把“阻塞问题”换成“空转问题”。
降级了多少数据,不能变成黑盒
另一个容易被忽略的问题,是数据状态不可见。无论你选择直接丢弃,还是写盘补偿,都必须把失败次数和处理结果记录下来,否则线上只会表现为“服务还活着”,但实际已经开始丢数据。
原文给出的一个简单写法,是在失败分支里同时做计数和落盘:
// 带有可观测性监控的非阻塞发送
func SendWithMetrics(ch chan<- string, data string) {
    if !SafeSend(ch, data) {
        metrics.DropCounter.Inc() // 丢弃计数加一
        writeToDisk(data)         // 触发存盘避险
    }
}
把 metrics.DropCounter.Inc() 这类指标接到 Prometheus,再配置报警阈值,才能在曲线抬头时第一时间知道下游已经出现积压。对生产环境来说,这一步不是附加项,而是非阻塞发送能否真正落地的必要条件。
高并发下的正确目标,不是硬扛到底
回到最初的问题:并发队列满了,写入方被卡住怎么破?核心答案并不是继续扩容 Channel,而是把发送从“默认阻塞”改成“可失败、可降级、可补偿、可观测”的完整链路。
select 配合 default 的价值,在于它充分利用了 Go 运行时对非阻塞发送的高效处理方式,让系统在过载时尽快给出反馈,不把问题扩散成 Goroutine 堆积和 OOM。再往上结合落盘补偿、失败计数、告警和必要的限流熔断,整套服务在面对流量尖峰时就会稳得多。
对于需要抗高并发的 Go 服务,这套思路的判断标准也很明确:当通道满了以后,系统是继续卡住上游,还是能立刻进入有计划的降级路径。前者只是把风险往后拖,后者才是真正面向生产环境的设计。















