



做离线优先应用时,真正决定体验的往往不是接口速度,而是前端有没有一个能独立工作的本地数据中枢。IndexedDB 的价值就在这里:它让读写先在本地完成,再把网络退回到后台同步的位置。下面从数据入口、查询方式、同步机制和兜底策略四个部分拆开讲清楚,方便你判断它是否适合作为应用的核心存储层,以及落地时该优先注意哪些设计点。
把 IndexedDB 当作唯一可信数据源
在离线优先设计中,IndexedDB 不该被当成“顺手缓存一下”的附属层,而应该被视为应用在浏览器里的主数据库。它承担的不是临时加速,而是业务数据的真实落点:页面读取从本地来,用户操作也先写进本地,网络只负责后续同步。
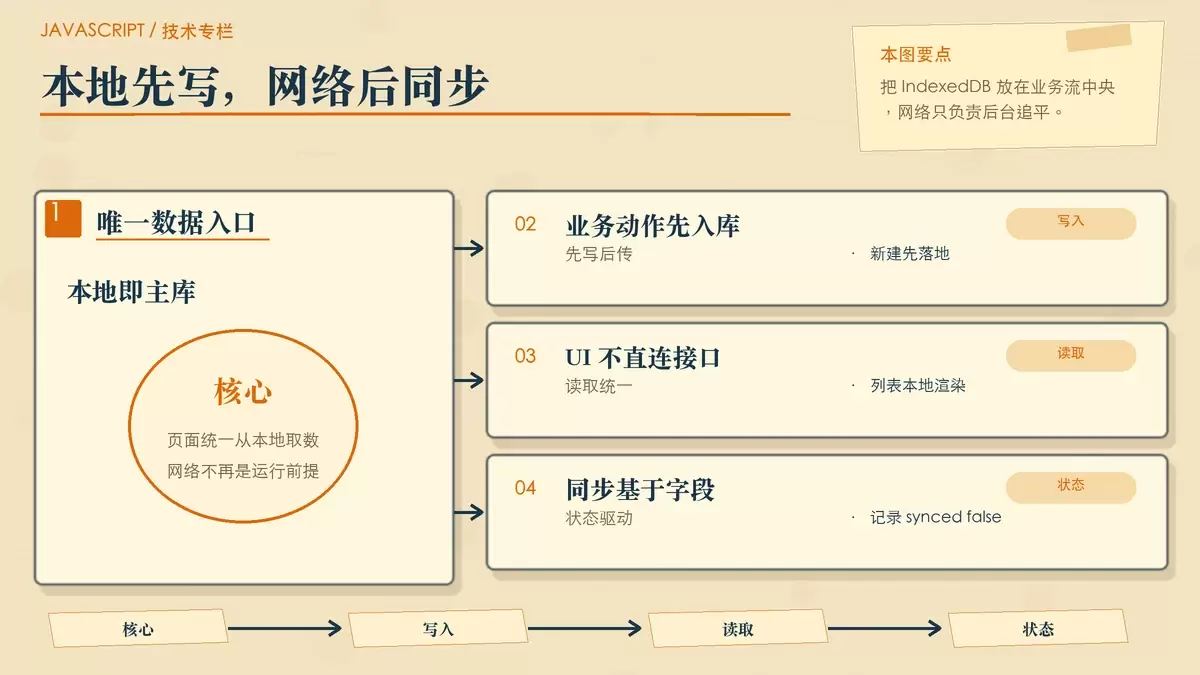
这意味着 UI 层和业务逻辑层不直接依赖 fetch 或远程 API。无论是新建一条笔记、编辑一个部门,还是发送一条消息,动作都应先进入 IndexedDB,并把状态标记为 synced: false。页面渲染也统一从本地读取,网络连接只是可用时参与同步,而不是应用能否运行的前提。
- 每个核心实体都应拆成独立的
object store,例如notes、departments、messages。 - 主键建议使用 UUID 或
autoIncrement,避免把服务端 ID 当成唯一依赖。 - 所有写操作都放进
readwrite事务里,配合onerror捕获失败,并准备降级方案,例如暂存到内存。 - 所有读操作统一走
readonly事务,根据场景选择get()、getAll()、游标遍历或索引查询。
这套设计的核心不是“本地也存一份”,而是“本地先成立,远端再追平”。一旦这个原则明确,断网可用、秒开和数据不易丢失才有基础。
用索引和扁平结构解决离线查询
离线状态下没有后端帮你聚合,也没有数据库 JOIN 可依赖,所以查询能力必须在本地数据模型里提前准备好。IndexedDB 能不能撑住业务,不只看能不能存数据,更看能不能把数据按场景快速取出来。
因此建模时要尽量放弃深层嵌套结构,转而使用适合建立索引的扁平字段。只有字段可被索引,列表筛选、分页加载、层级展开这些常见交互才能在本地保持顺畅。
- 树形组织架构可以让每个节点保存
id、name、parentId、type,再为parentId建索引。查询子节点时可直接使用store.index('byParent').getAll(parentId)。 - 文章缓存场景下,可以在
articlesstore 上分别为pubTime、category、isFavorite建索引,这样时间线、分类页和收藏夹都能直接本地筛选。 - 聊天记录通常至少需要三个索引:
byConversation用于按会话读取,byTime用于分页或滚动加载,bySender用于发送者维度筛选。
换句话说,IndexedDB 不是把服务端返回结果原样塞进去就完事。离线优先要求你在数据进入本地之前,就想清楚未来会怎么查、按什么维度查、哪些页面需要秒级响应。
围绕状态字段建立同步闭环
IndexedDB 本身不负责联网,但它决定了同步逻辑是否可控。网络恢复后,应用不应该“全量重发碰碰运气”,而应根据本地数据状态有选择地同步,这样才能减少重复提交、避免性能浪费,也更容易做失败重试。
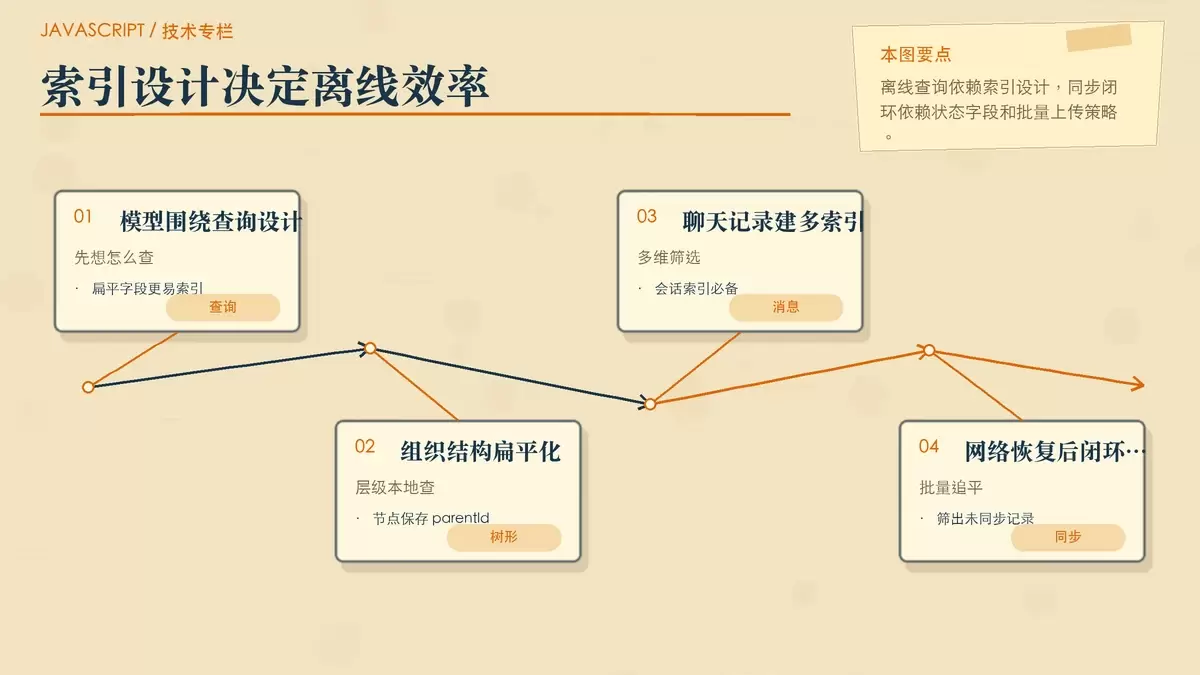
最常见的做法,是把同步状态直接放进记录里,例如 synced: false。当网络恢复时,再从 IndexedDB 中筛出这批待同步数据,按优先级和批次上传,成功后再更新状态。
- 可以监听
navigator.onLine,也可以通过更可靠的fetch探活来决定是否触发同步任务。 - 通过索引快速找出所有
synced: false的记录,再按业务优先级分批上传,例如草稿优先于日志。 - 每条记录单独重试,并带指数退避;成功后用
put()把其synced更新为true。 - 失败记录保持原状,等待下一轮同步,而不是直接删除或覆盖。
- 同步结束后,可以按策略清理过期数据,例如删除 30 天前的临时草稿,释放存储空间。
这种做法的优点在于,网络层不再主导业务数据是否成立,而只是负责把本地已成立的事实同步到远端。对离线优先应用来说,这种职责划分通常比“提交后等接口成功再落地”更稳。
兼顾边缘环境、文件存储与版本升级
IndexedDB 很强,但不能默认所有环境都稳定可用。比如部分浏览器的特殊模式,尤其 Safari 私密模式,就可能出现数据库无法正常打开的情况。离线优先如果没有降级路径,用户面对的就不是“体验变差”,而是“功能直接失效”。
因此,真正可上线的方案还需要把初始化检测、文件存储方式和数据库升级策略一起考虑进去。
- 初始化时应先检测 IndexedDB 是否可用;如果
indexedDB.open()失败,就降级到localStorage(仅适合简单 JSON)或纯内存存储。 - 对于图片、语音、视频这类 Blob 文件,优先直接存原生 Blob,而不是转成 base64。这样可以节省内存,也能避免额外编码开销;需要播放或预览时,再通过
URL.createObjectURL()生成临时地址。 - 版本升级要尽量平滑,
onupgradeneeded中优先采用“只增不删”的策略,让旧数据继续可读;新增索引或新的 store,不应影响已有数据的正常读写。
当这几部分补齐后,IndexedDB 才算真正具备了“核心存储层”的条件。它不仅能承接离线读写,还能把同步、查询和兼容性问题收束到一个清晰的数据中心里,让前端应用在网络不稳定时依然保持可用和可维护。















