



处理用户输入、日志字段或轻量文本解析时,字符串里常会混进连续空格、逗号、下划线等分隔符。问题看似只是“替换一下”,但真正要解决的是把一整段连续分隔符压成一个,或者直接删掉。下面按常见场景拆开说:什么时候用 std::regex_replace 最省事,什么时候该改成手动遍历,什么时候其实应该先拆分再重建。
用 std::regex_replace 压缩连续分隔符
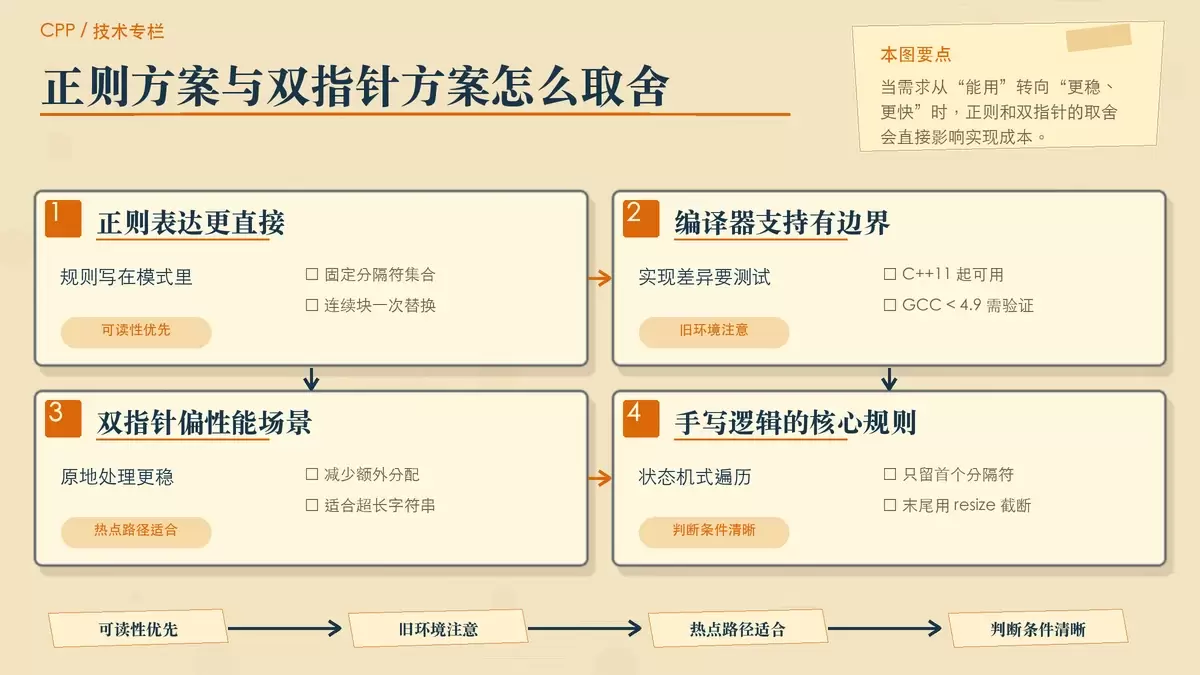
如果分隔符种类固定,比如空白、逗号、下划线,而且目标就是把它们连续出现的部分统一替换成一个分隔符,那么 std::regex_replace 是最直接的写法。这里的关键点是:正则必须匹配“一个及以上”的连续块,而不是单个字符。
正确写法如下:
std::regex_replace(s, std::regex("[\s,_]+"), " ")这个模式中的 [\s,_]+ 表示匹配一个或多个空白字符、逗号或下划线,然后整体替换成一个空格。这样无论原来是 ",,,"、"__",还是空格和逗号混在一起,都会被压成一个分隔符。
常见误区是只匹配单个字符,例如:
regex_replace(s, regex(","), " ")这种写法只会逐个替换逗号。遇到 ",,," 时,结果会变成三个空格,而不是一个空格,等于没有解决“多余分隔符”的核心问题。
如果你的需求不是保留一个分隔符,而是把连续分隔符整段去掉,也可以把替换内容从 " " 改成 ""。这一点在做字段归一化或键名清洗时很常见。
另外还要注意版本和实现差异:std::regex 从 C++11 开始可用,但某些旧编译器,尤其是 GCC < 4.9 的实现曾有已知问题。项目如果跑在老环境上,最好先做一次实际编译和结果验证,再决定是否采用正则方案。
性能敏感时,用双指针原地去重更稳
正则适合表达规则,但它不是所有场景下都划算。字符串很长、处理频率很高,或者你对额外分配和匹配开销比较敏感时,手动遍历通常更可控。思路并不复杂:维护一个写入位置,只保留每一段连续分隔符中的第一个,其余全部跳过。
这类方案的判断核心是:
只在“当前字符是分隔符,且前一个有效字符不是分隔符”时保留它也就是说,遇到普通字符就正常复制;遇到分隔符时,先看前面是否已经写入过一个分隔符,如果写过,就继续跳过。
原文给出的要点包括:
- 先定义分隔符集合,例如
const std::string delims = " tn,_"; - 用
std::find_first_of判断当前字符是否属于分隔符集合 - 保留首个分隔符,后续连续分隔符全部略过
- 遍历结束后调用
s.resize(write_idx)截断尾部冗余内容
这种做法的价值在于,逻辑可预测、内存行为也比较明确。对于“只想原地压缩,不想引入正则”的工程代码,它通常是更稳妥的实现方式。尤其在处理超长字符串、批量文本清洗或热点路径时,双指针方案往往更容易做性能评估。
当然,这个方法也有边界:规则一旦变复杂,比如要识别更丰富的字符类别、上下文条件或多阶段替换,正则的表达力会重新占上风。两者的差别,不只是语法风格,而是规则复杂度和运行成本的取舍。
需要“切分后重建”时,用 std::stringstream
有些场景表面上像“删除多余分隔符”,实际目标却是取出有效字段,再按统一格式重新拼接。比如处理简单 CSV、逗号列表或某些路径片段时,真正关心的是空字段不要保留,而不是原始分隔符长什么样。这时用 std::stringstream 配合 std::getline 会更自然。
它的本质流程是:
- 按指定分隔符切割字符串
- 忽略空结果
- 再用单一分隔符重新拼接
示例代码如下:
std::stringstream ss(s); std::string part; while (getline(ss, part, ',')) { if (!part.empty()) parts.push_back(part); }这种写法适合“字段导向”的处理方式。你不是在逐字符清洗,而是在说:先把内容拆开,只保留有意义的部分,最后再决定输出格式。
但它也有明显限制。首先,它更适合单一、明确的分隔符;如果字符串里既有空格、又有逗号、还混着下划线,通常要先做预处理,或者改用别的库,比如原文提到的 boost::split。其次,一旦进入“拆了再拼”的路径,原始分隔符类型就会丢失,例如空格和逗号混用的输入,最后可能都被你统一拼成空格或逗号。
还有一个容易混淆的点:operator>> 默认会跳过空白,但它读取的是“非空白字段”,并不是在做“连续分隔符压缩”。这两个问题看起来接近,处理目标其实不同,不能直接混用判断。
为什么 replace_all 一类接口不适合这个需求
不少人会先想到第三方库里的简单替换函数,例如 absl::StrReplaceAll 或 boost::algorithm::replace_all。但这类接口解决的是“精确替换某段已知文本”,并不擅长“识别一段连续模式后再压缩”。
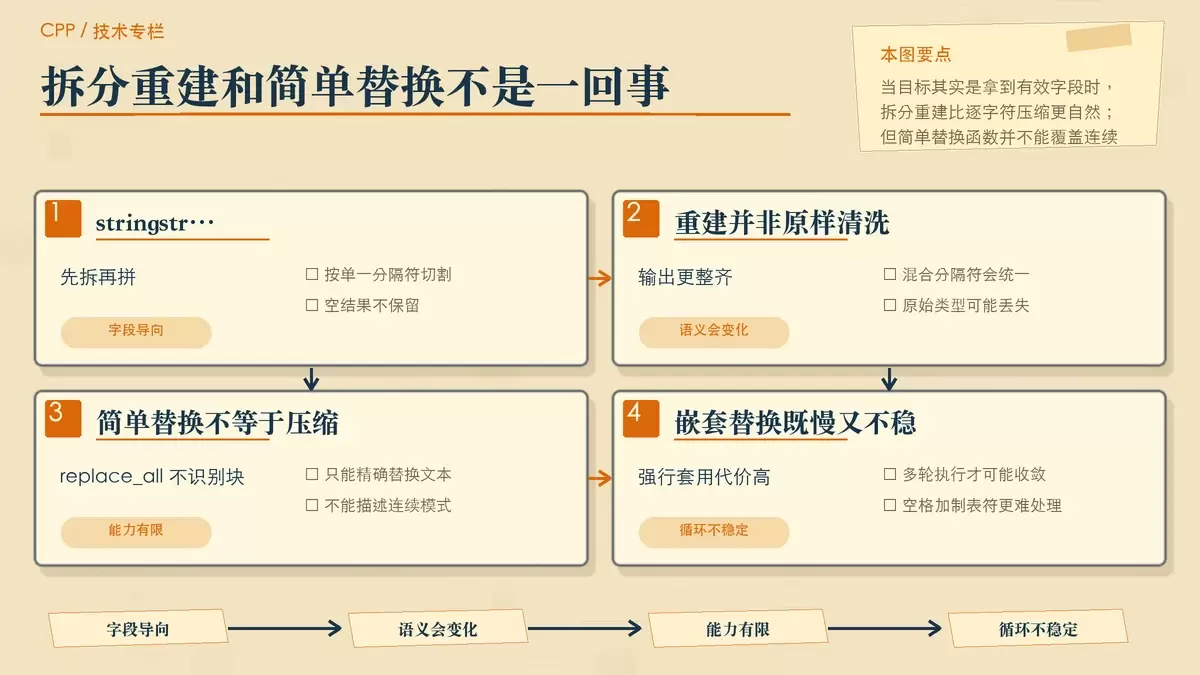
例如,把 "abc" 换成 "xyz",它们很好用;但想表达“一个或多个空格、逗号、下划线都算一组,并把整组变成一个空格”,这种模式它们并不能直接描述。
如果强行用循环替换去凑,问题会变得很快:
- 你需要多轮执行,才能逐步把多个连续分隔符合并掉
- 不同分隔符混合时,例如空格加制表符,简单替换几乎无从覆盖
- 是否收敛、要跑几轮,并没有稳定保证
原文里提到,有人尝试通过反复调用 replace_all 来处理连续空格,但像 5 个空格这样的输入,可能需要 3 轮才能收敛;一旦混入不同类型的分隔符,这种方法就更不可靠了。
因此,真正需要“模式压缩”时,通常还是回到两条路:要么用 std::regex_replace 直接描述规则,要么手写一个状态机式的遍历逻辑。简单替换 API 名字看起来顺手,但它解决的其实不是同一个问题。
怎么选方案更合适
把几种思路放在一起看,选择标准其实很明确:
- 分隔符固定,规则简单,代码可读性优先:选
std::regex_replace(s, std::regex("[\s,_]+"), " ") - 性能敏感、字符串很长、希望减少额外开销:选手动遍历加双指针
- 目标是拿到非空字段,再重新组织输出:选
std::stringstream加std::getline - 如果你想到的是
replace_all一类函数,先确认需求是不是“精确替换文本”,而不是“压缩连续模式”
换句话说,先判断你面对的是“字符压缩问题”还是“字段重建问题”,再决定工具。这个判断做对了,后面的实现通常不会绕弯路。















