



多线程 C++ 程序一到 Release 就崩,而 Debug 版本又跑得好好的,这类问题最难的地方不在“怎么下断点”,而在于很多常规调试手段会直接改变线程时序,反而把问题藏起来。更稳妥的做法,是先判断崩溃是否由优化放大,再结合调试符号、反汇编和 Sanitizer 缩小范围,最后回到共享变量、对象生命周期和初始化顺序这些真正会出错的地方做修正。
先判断:是不是优化把未定义行为放大了
Release 崩溃但 Debug 正常,首先应该怀疑未定义行为被优化触发。Debug 版本通常会关闭优化,并开启一部分运行时检查;而 Release 打开 -O2 或 /O2 后,编译器会做冗余代码删除、指令重排、函数内联,这些变化足以让“平时没炸”的问题直接暴露出来。
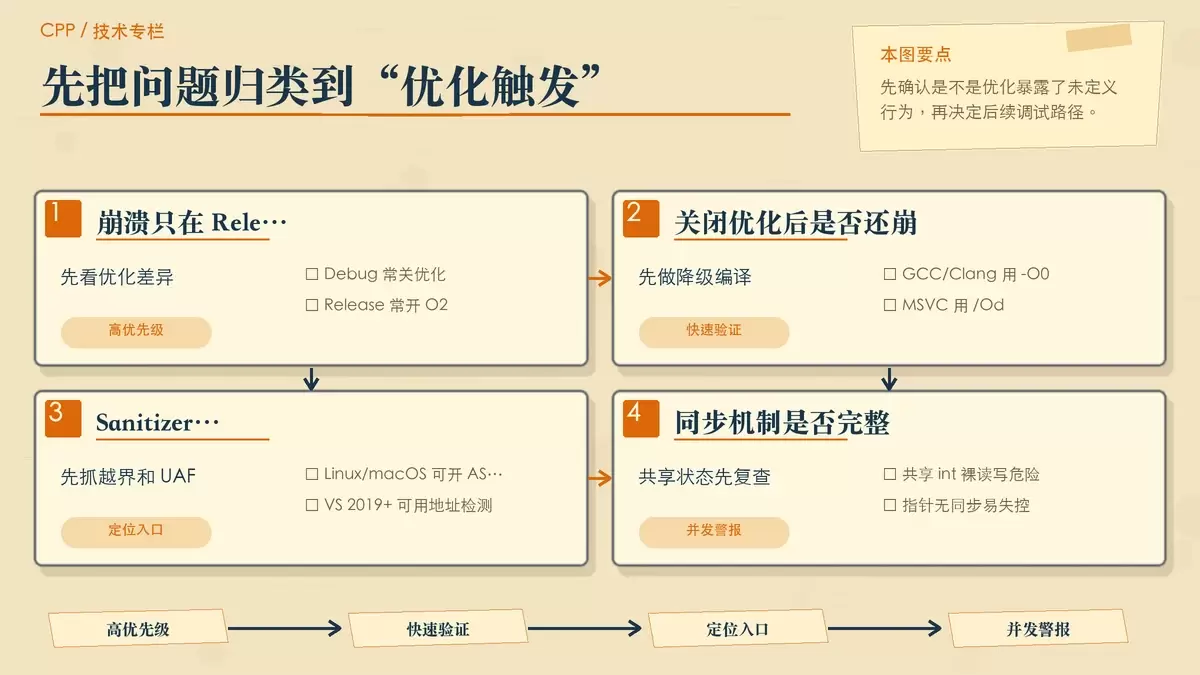
在多线程程序里,最常见的诱因通常有三类:读写已经释放的内存、多个线程对同一地址的无同步访问、未初始化变量参与计算。它们在 Debug 下未必立刻崩,但到了 Release,寄存器缓存、时序变化和优化后的执行路径都可能让程序更快撞墙。
与其一上来加日志,不如先做几项排除:
- 临时用
-O0(GCC/Clang)或/Od(MSVC)编译 Release 版本,看问题是否消失;如果不崩了,基本可以判断是优化暴露了 UB - 开启地址和未定义行为检测:Linux/macOS 可用
-fsanitize=address,undefined,MSVC 在 VS 2019+ 可用/fsanitize=address - 把所有线程共享变量重新过一遍,确认是否真的用了
std::atomic、std::mutex或其他同步机制;裸读写int、指针或容器状态,在 Release 下尤其危险
这一步的目标不是立刻找到 bug,而是先确认方向。如果关闭优化就不崩,后面的排查重点就不该放在“随机环境问题”上,而该集中到内存访问和并发语义本身。
保留调试符号,用堆栈和反汇编定位崩溃点
很多人会把 Release 和“完全不可调试”画等号,其实并不准确。Release 版本可以保留调试信息,同时继续开启优化。局部变量可能被优化掉,但崩溃地址、调用栈、寄存器状态、出错指令位置仍然很有价值。
Linux 下的常用做法
编译时建议带上:
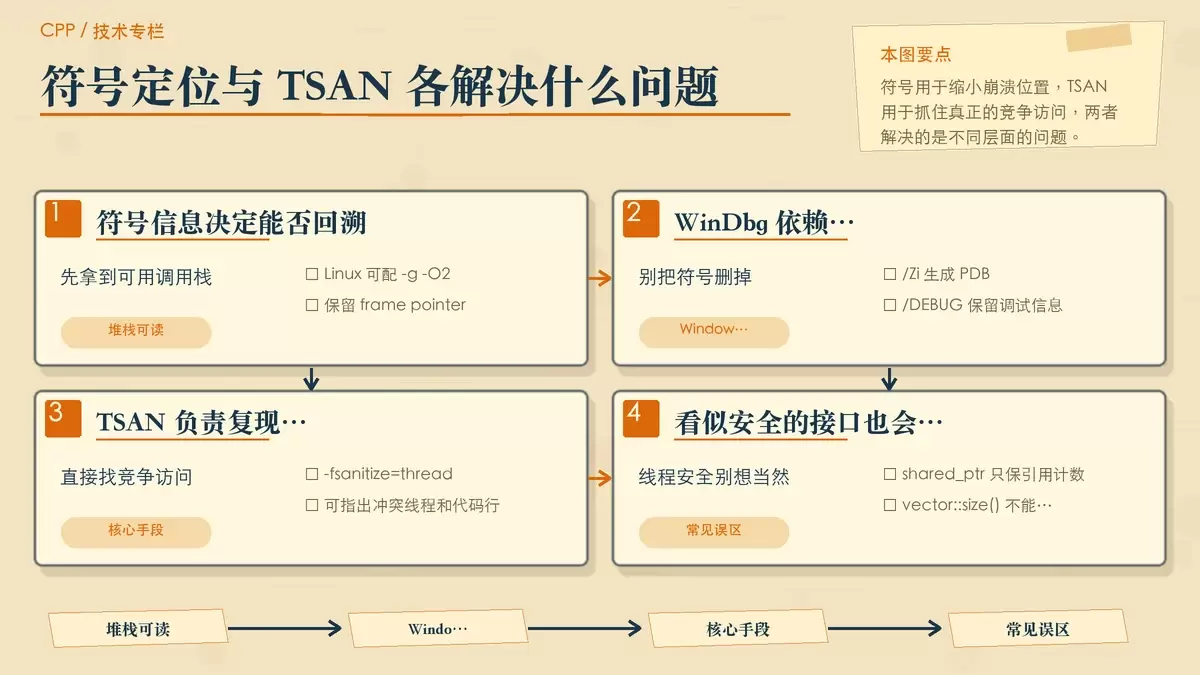
-g -O2 -fno-omit-frame-pointer其中 -fno-omit-frame-pointer 的作用很直接:尽量保证栈回溯可读。拿到 core dump 后,可以用:
gdb ./a.out core进入后执行:
bt full即便某些局部变量已经被优化器折叠掉,指针地址、崩溃指令位置和调用路径通常仍然足够判断是空悬指针、越界访问,还是某个线程在错误时间进入了关键路径。
Windows 下的常用做法
在 Visual Studio 中,项目属性可按下面方式设置:
- C/C++ → General → “Debug Information Format” 设为
Program Database (/Zi) - Linker → Debugging → “Generate Debug Info” 设为
Yes (/DEBUG)
这样生成的 Release 程序仍然会保留可用于分析的 .pdb。崩溃后可用 WinDbg 打开 dump,并执行:
!analyze -v如果分析结果里的堆栈大量显示为 ???,优先怀疑的不是“问题太诡异”,而是符号没带上。此时应该立刻回头检查构建流程,看是不是误删了 .pdb,或者对二进制做了 strip 处理。
这类信息的价值在于,它能帮助你把“Release 崩了”收缩成更具体的问题,例如“某个内联后的写操作落在非法地址上”,或者“线程 A 在对象析构后仍然调用成员函数”。一旦定位到具体指令,后续再回源代码就会快很多。
多线程崩溃优先排查数据竞争,TSAN 比日志更可靠
如果程序是多线程的,那么 Release 独有崩溃最常见的根因之一就是数据竞争。Debug 下线程调度较慢、执行路径更保守,有些竞争条件可能长期潜伏;到了 Release,优化、缓存一致性延迟和指令重排会让问题更高频地出现。
这类问题不适合依赖普通日志或断点。原因很简单:你一旦打印日志,线程时序就变了;你一旦打断点,竞争窗口也变了。很多“加了日志就不崩”的现象,本质上不是问题解决了,而是问题被时序变化掩盖了。
更可靠的办法是直接上动态检测工具:
- Linux/macOS:编译加
-fsanitize=thread -fPIE -pie - Windows:VS 2019 起支持
/fsanitize=thread,通常要求启用 C++17 及以上
TSAN 或 ThreadSanitizer 的价值在于,它不是靠猜,而是通过插桩监控内存访问,直接指出是哪两个线程、哪两行代码在无同步的情况下访问了同一块内存。
需要接受的代价也很明确:它会显著拖慢程序,通常可能达到 10–20 倍。但对排查 Release 多线程崩溃来说,这个代价通常值得,因为它换来的是可复现、可归因的证据链。
几个容易误判的点
std::shared_ptr的引用计数操作看起来是线程安全的,但它指向的对象并不会因此自动获得线程安全保障std::vector::size()不是原子操作,不能把它当成跨线程判断容器状态的同步手段- 裸读写普通
int或指针,即便在某些平台上“看起来只是简单赋值”,也不等于具备正确的并发语义
如果 TSAN 已经明确指出访问冲突位置,接下来就不该再围绕“是不是偶发现象”打转,而应该直接检查这段共享状态是否缺锁、原子变量内存序是否合理,以及对象所有权是否跨线程失控。
别只盯着锁,Release 还会暴露生命周期陷阱
有些崩溃看起来像并发问题,实际根源却是对象生命周期。Release 下临时对象寿命、析构时机和内联展开与 Debug 不完全一致,那些“刚好还活着”的对象,到了优化版本里可能就提前没了。
异步执行里的 lambda 捕获
典型问题是:lambda 捕获了局部变量,然后在线程中异步执行。Debug 下临时对象有时会因为编译器处理方式而显得“还能用”,但 Release 更接近标准语义,局部对象离开作用域后就该销毁。
这类场景应改成显式所有权转移,例如:
[val = std::move(val)]这样至少能保证线程真正拿到的是它自己的对象,而不是对一段即将失效内存的悬空引用。
全局和静态对象的初始化顺序
另一个容易被忽略的点,是全局或静态对象的构造顺序不确定。如果某个线程在 main() 之前启动,并访问了尚未初始化完成的静态 std::mutex,结果往往就是直接崩溃,而且非常难从表面现象反推。
更稳妥的方式是改用局部静态,按首次调用时初始化:
static auto& mtx = []{ static std::mutex m; return m; }();这样可以把初始化时机收敛到真正使用它的时候,减少跨编译单元初始化顺序带来的不确定性。
日志缺失会让崩溃更难追
还有一种情况不直接制造 bug,却会显著增加定位难度:某些日志库在 Release 下会被宏裁掉,例如 spdlog 的部分日志级别可能默认关闭。结果是关键路径的上下文信息在 Debug 有、Release 没有,排查时只能看到“已经崩了”,却不知道崩前程序在做什么。
因此,即使不保留完整调试日志,也至少应该保留必要的断言,或者对逻辑上不可能到达的分支使用 __builtin_unreachable()。这样做的意义不是美化代码,而是让真正的崩溃点尽量靠近问题源头,避免错误被拖延到更晚的位置才爆炸。
归根到底,Release 下的多线程崩溃很少是“某一行代码看着不顺眼,改掉就完了”。更常见的情况是,优化把程序原本就不稳的同步边界、内存模型理解和生命周期管理问题放大了。排查顺序一旦理清,先判断是否由优化触发,再借助符号和 Sanitizer 定位,最后回到共享状态与对象寿命做系统修正,效率会比盲目加日志高得多。















