



在 C++ 多线程程序里,崩溃栈落在 std::mutex::lock() 或 pthread_mutex_lock,很容易让人误判成“锁本身出了问题”。但更常见的情况是:你对一个无效对象调用了成员函数,锁只是最先暴露错误的位置。下面从崩溃成因、常见触发场景、定位办法和规避约束四个角度拆开说,帮助你判断这是不是一次典型的空指针或悬空对象访问。
为什么看起来像是 lock() 导致了崩溃
先说结论:std::mutex* 为 nullptr 时执行 mutex_ptr->lock(),这是未定义行为。崩溃的本质通常不是“锁函数有问题”,而是对空指针调用成员函数后,标准库实现会立刻访问对象内部状态,例如 this->__data,于是触发段错误。
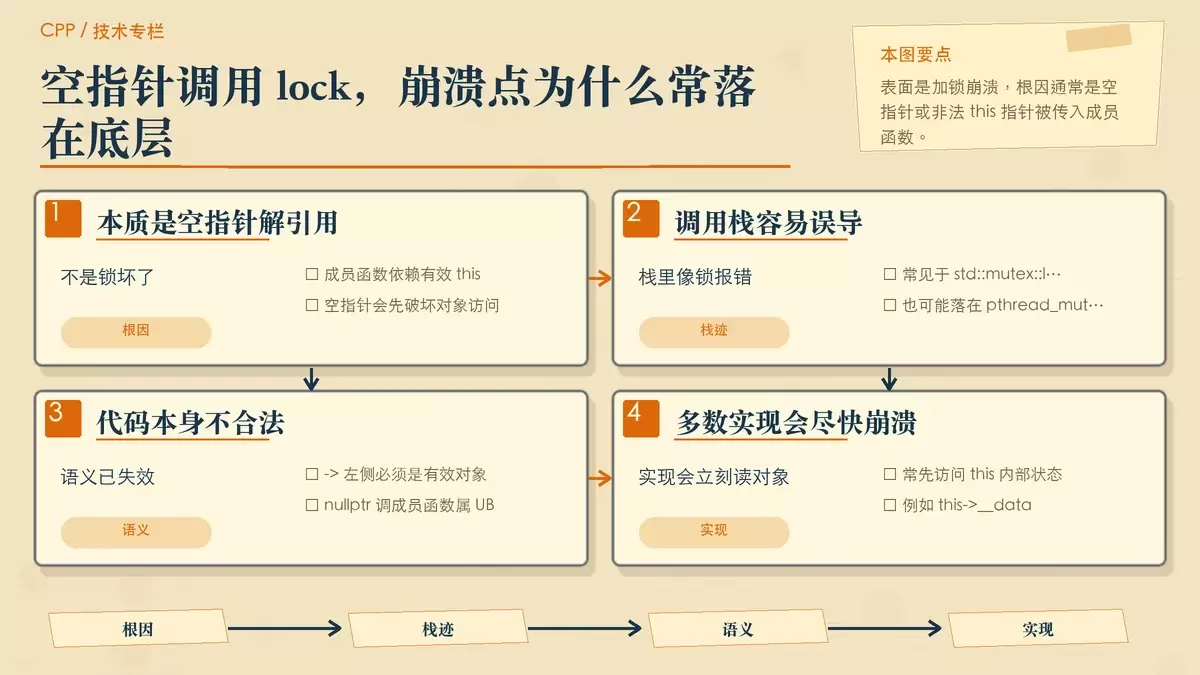
std::mutex 是对象,lock() 是成员函数,不是一个可以脱离对象独立调用的普通函数。因此,下面这种写法从语义上就已经不成立:
std::mutex* mutex_ptr = nullptr;
mutex_ptr->lock();
在多数实现里,调用栈最后可能显示在 std::mutex::lock、__pthread_mutex_lock 或类似底层入口,看起来像“加锁时崩了”。但真正的问题是传入了非法的 this 指针。
这类问题有几个典型特征:
- 编译阶段通常不会报错,问题会在运行时直接暴露。
- 调用栈容易把注意力引到
pthread_mutex_lock之类的底层函数上。 - C++ 标准语义要求
->左侧必须是有效对象指针,空指针调用成员函数本身就不合法。
真实项目里,哪些情况会制造“对 NULL mutex 加锁”的假象
实际开发中,很少有人会故意写出 nullptr->lock()。更常见的是对象关系、初始化顺序或生命周期管理出了问题,最后在加锁这一步集中爆发。
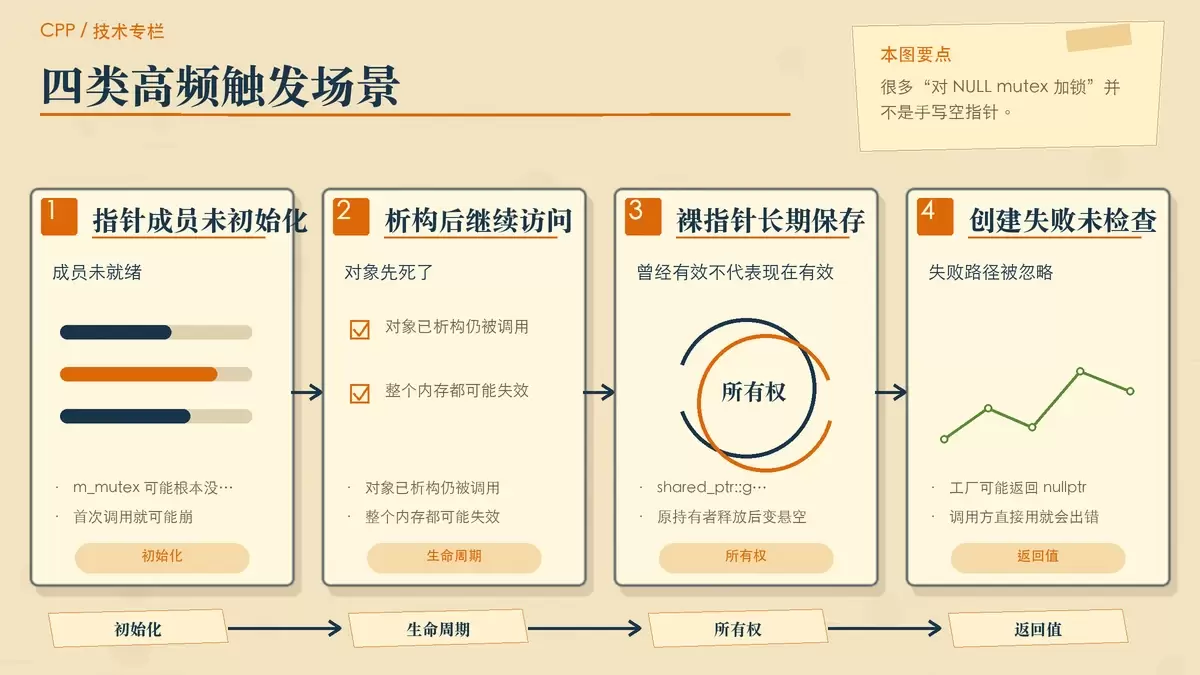
1. 成员指针没有初始化
如果类里写的是 std::mutex* m_mutex,而构造函数没有正确初始化,后续又直接调用:
m_mutex->lock();
那么崩溃几乎就是迟早的事。这里的问题不是多线程竞争,而是对象一开始就没处在有效状态。
2. 对象已经析构,别的线程还在继续调用
这是更危险的一类。某个线程释放了对象,另一个线程却还保留着旧指针,并继续调用其中的方法。此时不仅 m_mutex 可能无效,连整个对象内存都可能已经被回收。
这种情况下,调用成员函数时出现的任何崩溃都可能被误判成“锁有问题”,实际上是典型的悬空对象访问。
3. 从 shared_ptr 拿出裸指针后长期保存
比如对象由 std::shared_ptr 管理,但某段代码通过 get() 取出裸指针并长期持有。只要原来的 shared_ptr 生命周期结束,这个裸指针就会变成悬空指针,之后无论访问数据成员还是调用 m_mutex->lock(),都可能直接崩溃。
这类问题尤其隐蔽,因为代码表面上“曾经是合法对象”。
4. 工厂函数返回 nullptr,调用方没有检查
如果工厂函数在初始化失败时返回 nullptr,调用方又默认它一定成功,直接继续调用成员方法,那么最终也可能在锁操作附近暴露。
因此,看到崩溃栈在加锁位置时,不能只盯着锁本身,还要回头看对象是怎么创建、传递和销毁的。
如何快速判断是不是空指针或悬空对象问题
这类问题定位时,优先看调用栈和运行时工具,不要先依赖日志。段错误发生得很快,日志常常来不及刷盘。
看 GDB 调用栈和寄存器
如果 GDB 显示崩溃点在 std::mutex::lock() 或 pthread_mutex_lock,同时 x86-64 下的 $rdi 为 0x0,那么基本可以确认:传入成员函数的 this 指针就是空值。
这时应优先回溯调用该成员函数的对象来源,而不是继续怀疑互斥锁实现本身。
用 AddressSanitizer 直接抓空指针解引用
如果条件允许,可以使用 AddressSanitizer 编译程序:
-fsanitize=address
它通常会在空指针解引用时给出更直接的错误信息,例如:
SEGV on unknown address 0x000000000000
相比只看系统崩溃栈,这种信息更接近根因。
在关键路径提前断言
如果你已经怀疑某个互斥锁成员可能为空,可以先在加锁前加一层断言:
assert(m_mutex != nullptr);
这不是最终修复方案,但能更早暴露错误路径,避免问题总是拖到更深的底层调用里才炸出来。
怎么避免:三条必须落实的约束
这类问题一旦出现在多线程代码里,排查成本通常很高,所以预防比事后定位更重要。下面三条不是风格建议,而是更接近工程约束。
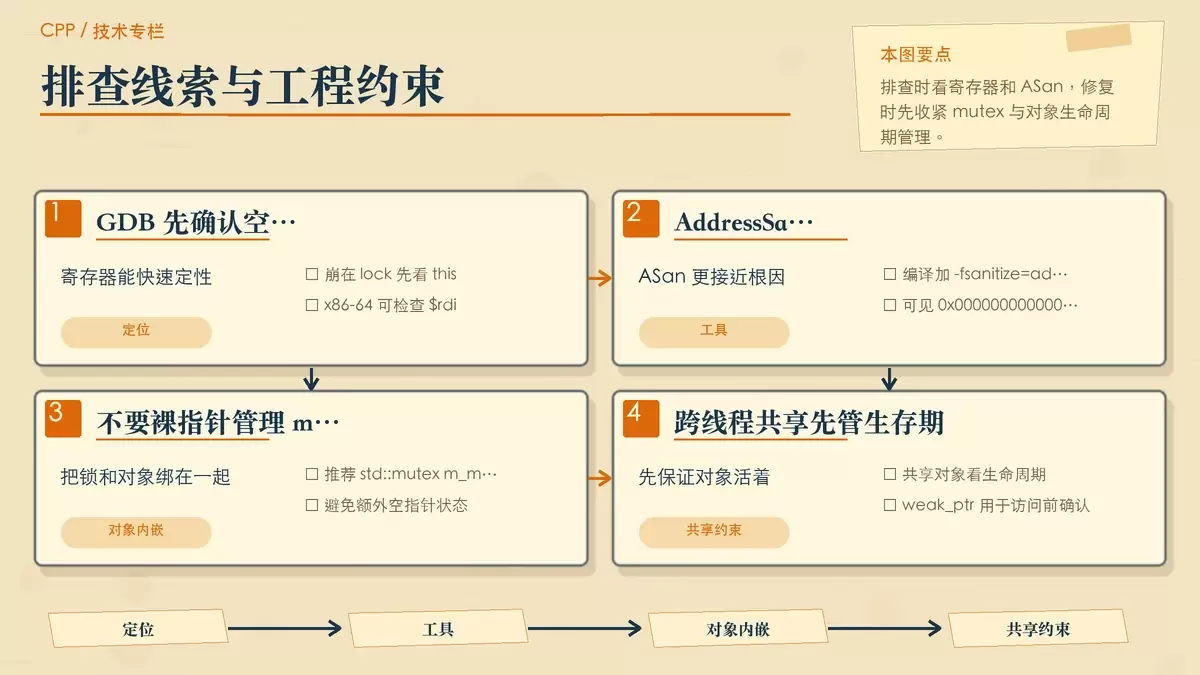
不要用裸指针管理 std::mutex
优先把互斥锁直接声明为对象成员:
std::mutex m_mutex;
而不是写成:
std::mutex* m_mutex;
前者的生命周期和宿主对象绑定,不需要额外判断是否为空;后者则平白引入初始化、释放和悬空访问问题。
确实要动态创建时,用 unique_ptr 明确所有权
动态创建 std::mutex 的场景其实很少见,但如果确实有必要,应使用 std::unique_ptr<std::mutex> 管理,并在调用 lock() 前确保对象存在。
这里的重点不是“用了智能指针就安全”,而是所有权必须单一、状态必须可验证。
跨线程共享对象时,先保证对象活着
对于跨线程共享的业务对象,应使用 std::shared_ptr 和 std::weak_ptr 协同处理生命周期,避免对象析构后仍被其他线程继续访问。
这条约束要比“加锁是否正确”更基础。因为如果对象本身都已经失效,那么其中的锁、成员数据和成员函数调用全部不再可靠。
可以把它理解为一句更实用的判断标准:先确认锁对象活着,再谈加锁是否安全。否则你以为是在保护共享数据,实际上连用来保护数据的锁都已经不存在了。















