


pandas DataFrame 删除重复行的方法详解

发布时间:2026-10-13 |
5人浏览过
本文介绍在 pandas 中处理重复数据的方法。通过示例展示如何创建 DataFrame,使用 duplicated() 检测重复项,并利用 drop_duplicates() 移除重复行。重点解析 subset 参数指定特定列,以及 keep 参数('first', 'last', False)控制保留策略,帮助开发者高效清理数据。
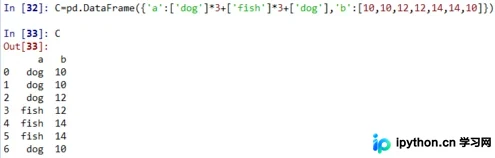
首先,构建一个包含重复数据的 DataFrame 对象。
C=pd.DataFrame({'a':['dog']*3+['fish']*3+['dog'],'b':[10,10,12,12,14,14,10]})
接下来,需要识别数据中是否存在重复记录。
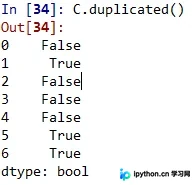
利用 duplicated() 函数可以执行重复项的检测。
C.duplicated()
若发现存在重复数据,可调用 drop_duplicates() 方法将其移除。
C.drop_duplicates()
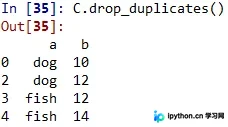
duplicated() 与 drop_duplicates() 默认会对所有列进行联合判断(如示例中同时检查变量 a 和 b 是否完全一致)。
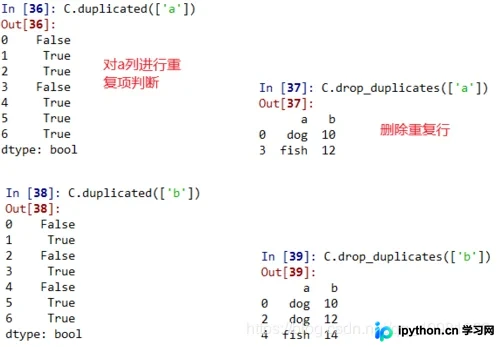
此外,支持针对特定列进行重复性判断。
 C.duplicated(['a'])   C.drop_duplicates(['a'])

 C.duplicated(['b'])   C.drop_duplicates(['b'])
执行代码:norepeat_df = df.drop_duplicates(subset=['A_ID', 'B_ID'], keep='first')
上述命令旨在去除 UNIT_ID 和 KPI_ID 列中的重复行,并保留这些重复行中首次出现的那一行。
补充说明:
- 当设置 keep=False 时,所有包含重复值的行都将被删除。
- 当设置 keep='first' 时,仅保留每组重复数据中第一次出现的那一行。
- 当设置 keep='last' 时,仅保留每组重复数据中最后一次出现的那一行。
注意,上述 keep 参数的值必须为字符串类型,使用时需添加引号。
以上内容涵盖了 pandas 中删除重复行的主要操作,希望对各位的学习有所帮助,欢迎继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















