



在处理无限序列、大文件或分页接口时,问题往往不在“能不能算出来”,而在“是否必须一次算完”。Generator 的价值正体现在这里:它把计算拆成一小步一小步,只在真正消费数据时才继续执行。下面按“原理、迭代接入、链式处理、真实数据流”四个层次展开,帮助你判断它适合放在什么场景,以及哪些写法会破坏惰性。
用 yield 实现按需计算
Generator 天然支持惰性求值。核心原因是:函数执行到 yield 时会暂停,把当前值交给外部;只有下一次调用 next(),函数才会从上一次暂停的位置继续往下走。
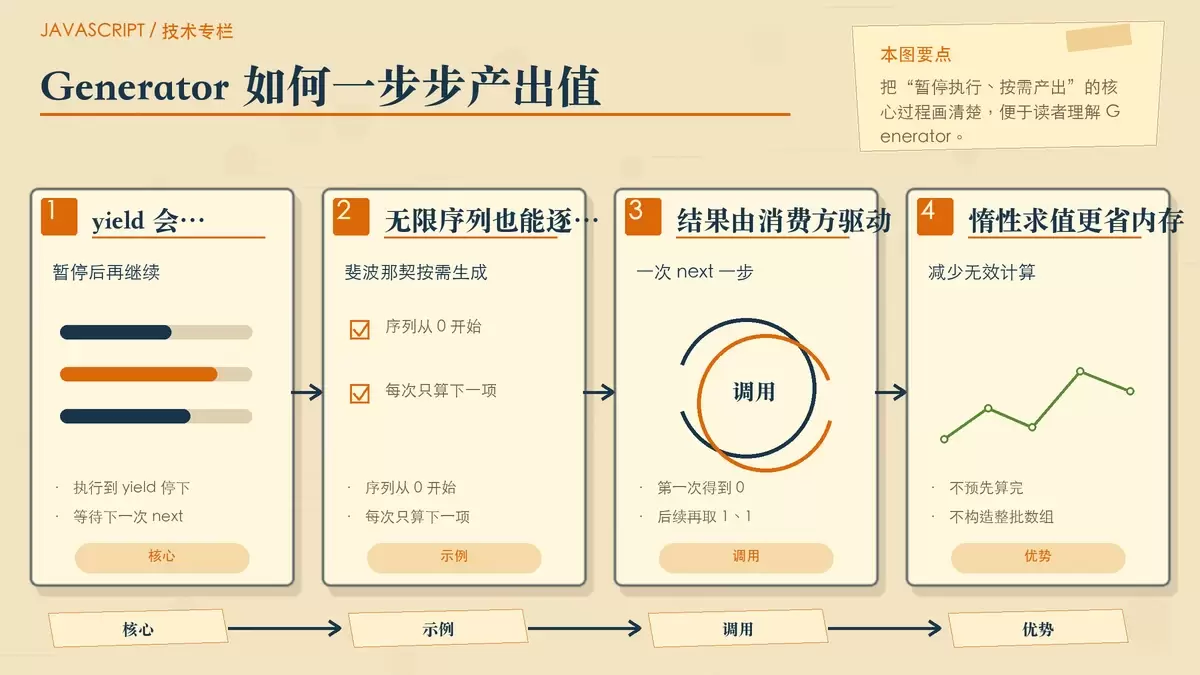
这意味着它不会像普通数组处理那样,一开始就把全部结果准备好。对于无限序列,或者只关心前几个结果的场景,这种机制尤其合适。
最典型的例子就是斐波那契数列。你并不需要提前算出第 1000 项,只有当调用方继续取值时,下一项才会被计算出来:
function* fib() {
  let a = 0, b = 1;
  while (true) {
    yield a;
    [a, b] = [b, a + b];
  }
}
调用方式也能直接体现“按需”这件事:
const gen = fib();
gen.next().value; // 0
gen.next().value; // 1
gen.next().value; // 1
每次 next() 只推进一步,没有预计算,也不需要先构造一个完整数组。这就是 Generator 在惰性求值里的基础能力。
接入可迭代协议后,如何保持惰性
Generator 对象默认实现了 [Symbol.iterator],所以它能直接用于 for...of、解构、Array.from() 等可迭代场景。重点在于:接入这些语法后,它仍然是惰性的,是否继续生成值,取决于外部是否继续消费。
例如下面这段循环,并不会无穷无尽地跑下去,而是在遇到第一个大于 100 的值时立刻停止:
for (const n of fib()) {
  if (n > 100) break;
  console.log(n);
}
因为循环中断后,后续的 next() 不再发生,Generator 也就不会继续计算。
这也是很多人容易忽略的一点:Generator 的惰性不只体现在手动调用 next(),也体现在这些语言内建的消费入口上。只要消费动作停止,计算就会停止。
不过,不同消费方式的边界要看清楚。比如:
[...fib()].slice(0, 10)这类写法表面上像“先展开再截取”,原文强调的是扩展运算符内部会逐次调用 next()。但在实际使用中,扩展无限 Generator 会有风险,因为展开动作本身需要先把可迭代对象消费完。判断是否安全,关键看消费方有没有明确的停止条件。
另一个更需要注意的是:
Array.from(fib())这会持续尝试读取 Generator 的内容。面对无限序列时,如果没有长度限制或额外的截断逻辑,就会无限执行。因此,Generator 虽然提供了惰性能力,但一旦接上“会尽可能吃完整个迭代器”的 API,这种优势就可能被直接抵消。
用 map、filter、take 组织惰性数据管道
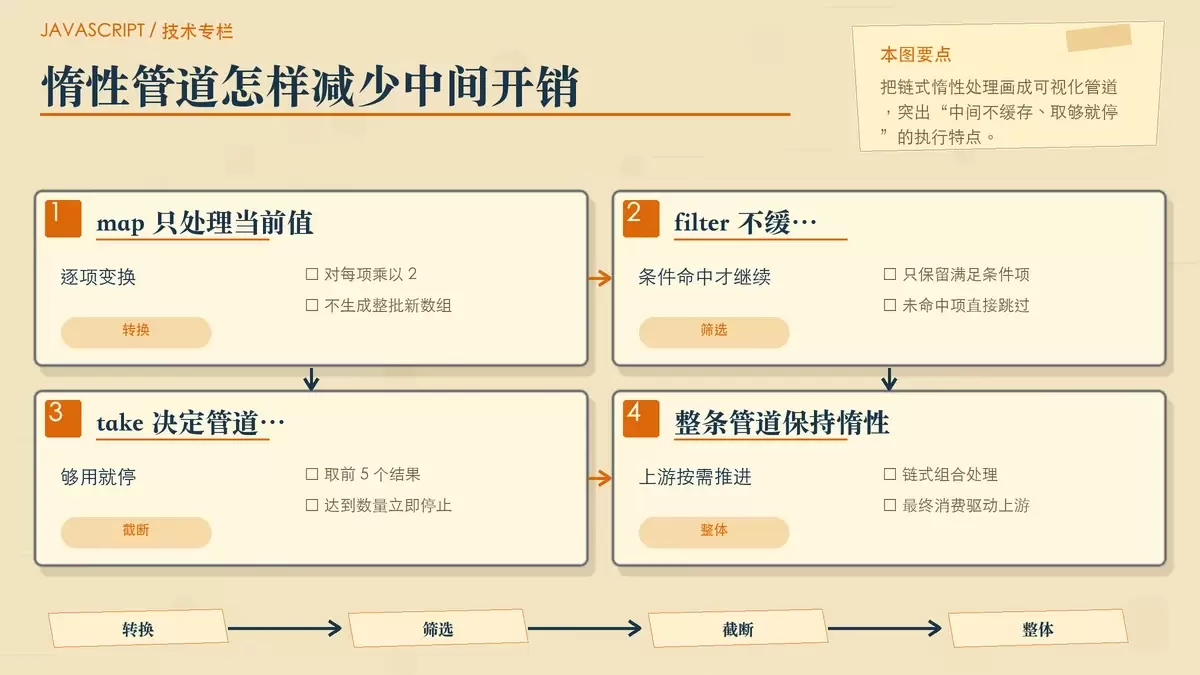
Generator 真正适合数据流处理,不只是因为它能一个个吐值,更因为它可以被封装成一组返回 Generator 的高阶函数。这样一来,map、filter、take 这类常见操作就能以“管道”的方式串起来,而且每一步都不急着执行。
下面是三个基础操作符:
function* map(iter, fn) {
  for (const x of iter) yield fn(x);
}
function* filter(iter, pred) {
for (const x of iter) if (pred(x)) yield x;
}function* take(iter, n) {
let i = 0;
for (const x of iter) {
if (i++ >= n) break;
yield x;
}
}它们看起来很简单,但关键点在于:这些函数本身不会立刻遍历完整个输入数据,而是只定义“当下一个值被请求时,应该怎么处理”。这和先 map 成一个新数组、再 filter、再 slice 的做法有本质区别。
组合起来后,效果会更直观:
take(filter(map(fib(), x => x * 2), x => x % 3 === 0), 5)这段逻辑的含义是:先把斐波那契数列中的每个值乘以 2,再筛出能被 3 整除的项,最后只取前 5 个结果。整个过程中,只会生成满足最终需求所必需的那些值;中间结果不需要整体缓存,也不需要构造多个临时数组。
如果你的处理流程本身就是“读一项、变换一项、判断一项、够了就停”,那么 Generator 比数组批处理更贴近真实的数据流模型。
落到真实场景:大文件、事件与分页 API
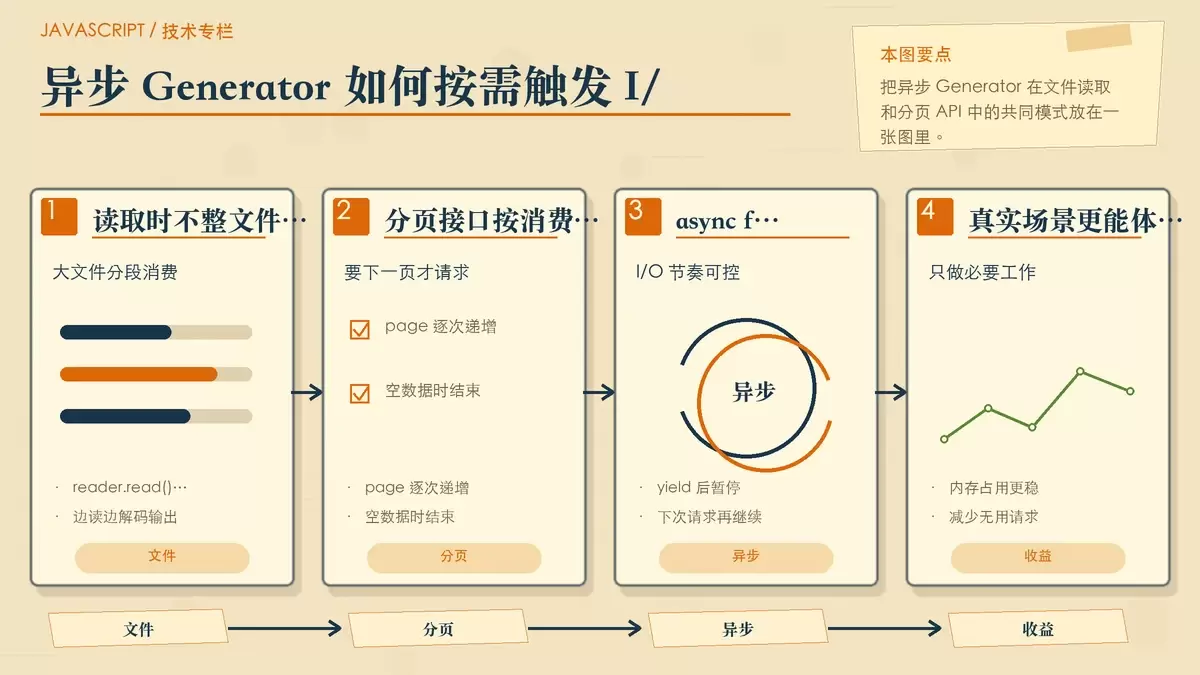
在真实项目里,惰性求值最有价值的地方,通常不是数学序列,而是 I/O。只要把 Generator 扩展到异步形式,也就是 async function*,它就可以对接那些“下一批数据什么时候到,要等外部资源”的场景。
比如读取大文件时,可以按块或按行逐步消费,而不是一次把整个文件读进内存:
async function* readLines(file) {
  const reader = file.stream().getReader();
  while (true) {
    const { value, done } = await reader.read();
    if (done) break;
    yield new TextDecoder().decode(value).split('n').filter(Boolean);
  }
}
这个写法的重点不在“把文件读出来”,而在“只在需要下一段内容时才继续读取”。每次执行到 yield,当前流程就会暂停,等消费方再次请求,才会继续下一次 I/O。
分页 API 也是同样的思路。相比一次性把所有页面请求完,再统一拼接结果,异步 Generator 可以把“翻页”动作延后到真正消费数据的时候:
async function* fetchPages(url) {
  let page = 1;
  while (true) {
    const res = await fetch(`${url}?page=${page++}`);
    const data = await res.json();
    if (!data.length) break;
    yield* data;
  }
}
这样做有两个直接收益。第一,内存占用更稳定,不需要把所有页结果一次性放在内存里;第二,请求节奏跟随消费节奏,调用方如果只取前几十条,后面的分页请求根本不会发生。
同样的模式也可以用于事件流、消息流和持续到来的日志数据。只要数据不是一次性静态给出的,而是“可能很多、可能无穷、也可能根本用不完”,Generator 的暂停与恢复机制就能把处理链条压缩到更接近真实需求的粒度。
什么时候值得用 Generator 做惰性处理
可以把判断标准归纳成一句话:当你关心的是“逐步消费”而不是“先拿全量结果”,Generator 就值得考虑。
它尤其适合以下几类情况:
- 数据规模大,提前全部加载会造成明显内存压力;
- 数据可能是无限的,例如数列、日志流、事件流;
- 处理链条较长,但最终只会消费前一部分结果;
- I/O 成本高,希望请求、读取、解析都随着消费动作按需发生。
反过来说,如果你的场景本来就需要一次性拿到完整结果,或者后续必须随机访问全部数据,那么 Generator 未必比数组更合适。它的优势不在于替代所有集合处理,而在于把“什么时候算、算到哪里停”这件事控制得更细。
从这个角度看,Generator 在 JavaScript 数据流处理中最重要的能力,并不是语法层面的 function* 和 yield,而是它提供了一种更节制的执行模型:只在需要时推进,只为最终消费生成必要的数据。















