



接口签名看起来像是哈希或 HMAC 的问题,实际排查时,很多验签失败都出在“同一份 JSON 在前后端序列化结果不一样”。尤其当前端是 JavaScript、后端又可能是 Java、Go、Python 时,只靠各自默认的对象遍历顺序,往往不足以保证签名原文一致。
这篇文章把问题拆成四步:先说明为什么不能依赖 JSON 默认键序,再给出前端统一排序的写法,接着处理最容易出错的嵌套对象,最后补上后端对齐与安全细节。看完后,你可以直接判断自己现有的签名方案,究竟是“暂时能用”,还是“跨语言场景里迟早出问题”。
为什么接口签名不能依赖 JSON 默认键序
JSON 本身并不保证对象键的顺序。虽然 ECMAScript 规范里,ES2015+ 之后对象属性在 for...in、Object.keys()、JSON.stringify() 这些场景下,通常会对字符串键按插入顺序保持一致,但这里有几个前提:
- 键名是普通字符串键;
- 对象没有经历会改变属性顺序的处理;
- 前后端都使用了行为一致的序列化实现。
问题在于,接口签名验签是跨端协作场景,不能只看 JavaScript 自己的表现。数字字符串键可能按数值大小排序,不同语言的 Map 或 JSON 库也可能各有自己的输出规则。一旦前端签名原文和后端验签原文哪怕只差一个键位次序,最后哈希值就完全不同,结果就是验签失败。
所以在签名场景里,可靠做法不是“相信默认顺序”,而是在签名前主动把键序统一下来。
签名前先统一键序:按字典序序列化
更稳妥的方案是:在计算签名之前,把待签名对象的键按统一规则排序,再进行序列化。文中的建议是按 UTF-8 字典序处理,而不是按插入顺序直接 JSON.stringify。
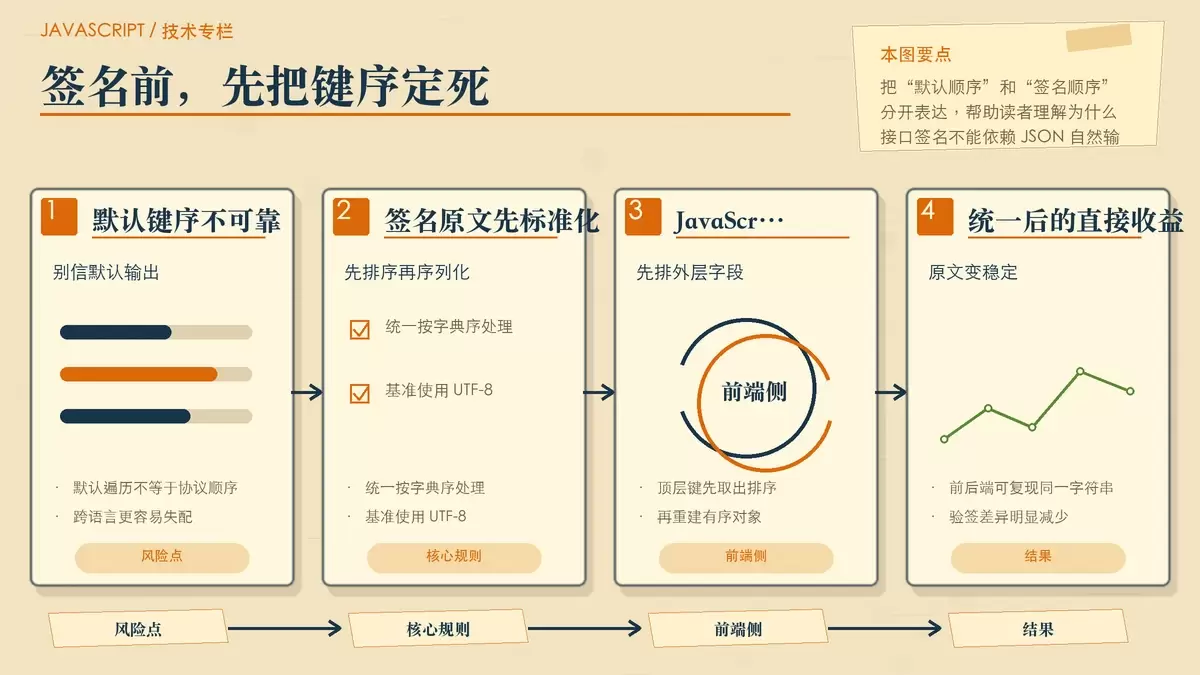
这样做的意义很直接:无论前端用什么运行环境、后端用什么 JSON 库,只要双方遵守同一排序规则,最终拿到的签名原文就能保持一致。
JavaScript 顶层字段排序示例
前端可以先取出顶层键,排序后重建对象,再序列化:
const payload = {
  timestamp: 1717023456,
  nonce: "abc123",
  method: "user.get",
  params: { id: 1001, status: "active" }
};

const sortedKeys = Object.keys(payload).sort();

const orderedPayload = {};
for (const key of sortedKeys) {
  orderedPayload[key] = payload[key];
}

const signString = JSON.stringify(orderedPayload);
// → {"method":"user.get","nonce":"abc123","params":{"id":1001,"status":"active"},"timestamp":1717023456}
// ✅ 所有键严格字典序
这段写法能保证顶层字段顺序统一,例如 method、nonce、params、timestamp 会稳定输出。但也要注意,它只是把顶层键排好序,像 params 这样的嵌套对象,内部键顺序仍然要额外处理。
嵌套对象怎么处理,才不会把签名搞乱
真正容易埋坑的地方,往往不是顶层字段,而是 params、data 这类嵌套对象。因为即使外层对象顺序固定了,内层对象依然可能在不同端被重新解析、重新序列化,最终影响签名结果。
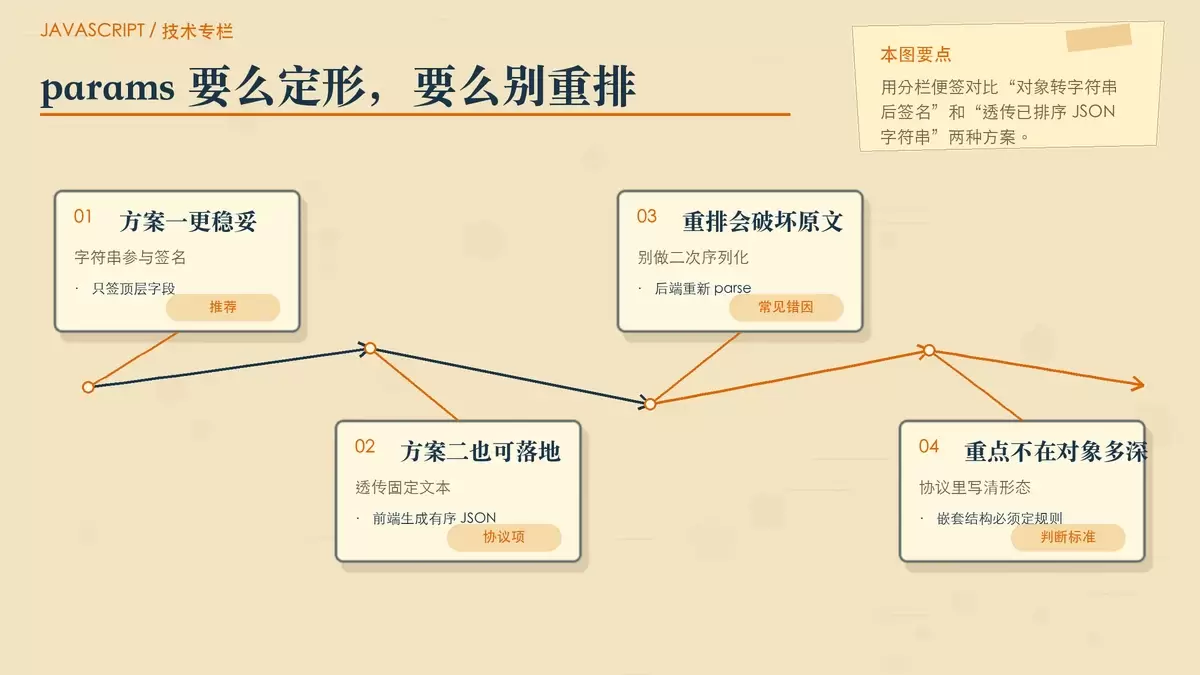
这类场景通常有两种更实用的处理方式。
方案一:只签顶层字段,把 params 作为字符串参与签名
这是更推荐的方案。思路是:签名只覆盖顶层字段,而 params 先被序列化成 JSON 字符串,再作为一个普通字符串字段参与签名。
这样一来,params 内部顺序只需要在生成字符串时控制一次。后端收到后,直接把这段字符串原样用于验签,不再重新解析再序列化,就能避免不同语言二次处理带来的偏差。
方案二:约定 params 必须是已排序的 JSON 字符串
如果接口设计里本来就允许前端透传 JSON 字符串,也可以直接约定:params 必须是“按字典序排好键”的 JSON 字符串。
这个方案的重点不是让后端“理解 params 结构”,而是让后端把它当作签名原文的一部分原样使用。只要协议约定清楚,后端就不应该在验签前再把它 parse 后重新生成一遍,否则前面的排序工作等于白做。
不管用哪种方式,核心原则都一样:嵌套对象不能交给前后端各自自由发挥,必须在协议层约定清楚它参与签名时的最终形态。
后端也必须实现完全一致的排序规则
前端排序只是第一步,后端如果没有同步实现同样的规则,验签仍然会失败。这里的“一致”不是大概相同,而是要在键排序、编码和序列化输出上尽量做到完全一致。
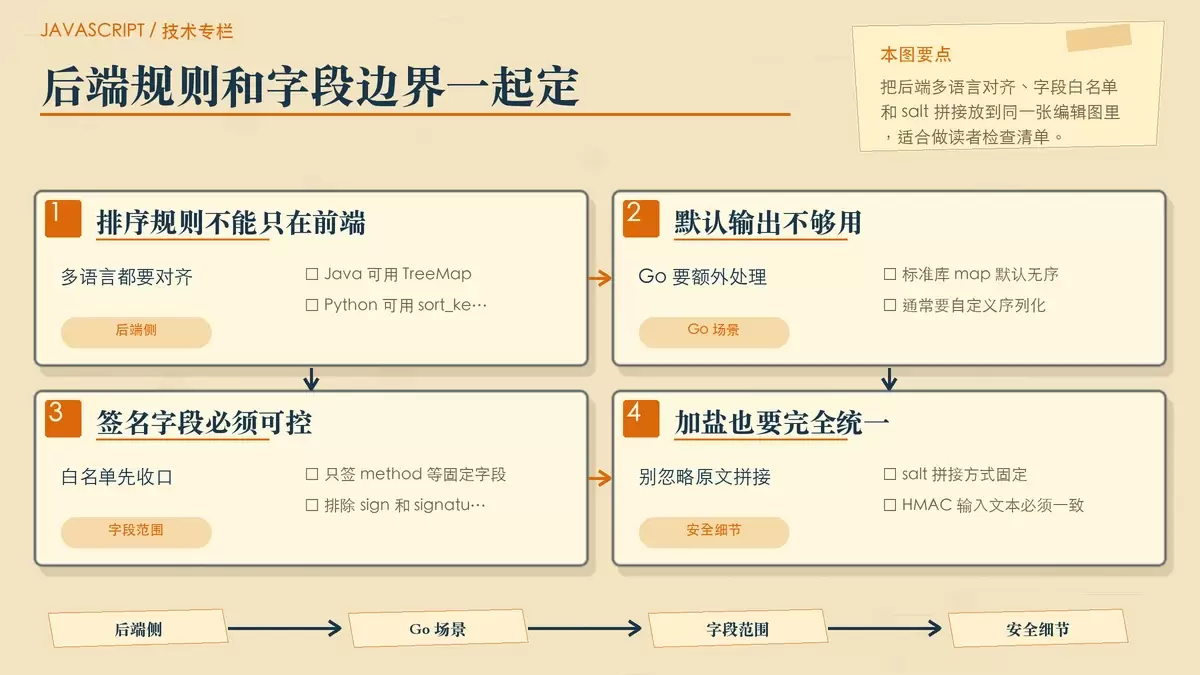
- Java(Jackson):如果默认按声明顺序输出,验签场景下就不够稳妥。可以使用
@JsonPropertyOrder(alphabetic = true),或者手动构建TreeMap; - Go(encoding/json):标准库默认不能直接保证 map 有序输出,通常要基于
map[string]interface{}配合sort.Strings做自定义序列化; - Python(json.dumps):直接传入
sort_keys=True即可。
除了排序本身,还要统一“字典序”的依据。实践里通常以 UTF-8 字节序作为基准,这样更适合跨语言实现。否则即使字段名看起来一样,不同端如果在 Unicode 归一化或编码处理上有差异,也可能造成最终签名不一致。
比排序更关键的是规则写进协议
很多团队的问题不是“不会排序”,而是规则只写在某一端代码里,没有写进接口约定。结果就是前端以为按 Object.keys().sort() 就够了,后端却按库默认输出,或者把嵌套对象重新整理后再签名。
更可靠的做法是把下面几项明确写进接口规范:
- 参与签名的字段名单;
- 字段排序规则;
- 嵌套对象是否允许出现;
params这类字段是对象还是字符串;- 统一使用什么编码进行签名原文计算。
这样前后端实现才有稳定依据,排查问题时也能快速定位是字段不一致、顺序不一致,还是编码不一致。
签名字段要收口,sign 自身不要参与计算
处理完顺序问题后,还有两个细节经常被忽略。
先做字段白名单,排除 sign、signature
签名计算前,应该明确只取固定字段,比如 method、timestamp、nonce、params。像 sign、signature 这类签名字段本身,必须排除在外,否则会形成循环依赖,前后端都没法得到一致结果。
这一步最好不要依赖“收到什么就签什么”,而应该基于白名单明确构造待签名对象。这样既能减少歧义,也能避免无关字段被偷偷混入签名原文。
加入固定 salt,再配合 HMAC 计算
在有共享密钥的接口里,还可以把固定 salt 拼进签名原文,再结合 HMAC 算法提升防篡改能力。原文示例如下:
const signContent = JSON.stringify(orderedPayload) + "&salt=your_api_secret";
const signature = CryptoJS.HmacSHA256(signContent, apiKey).toString();
这里要注意的是,salt 的拼接方式、字段顺序、分隔符写法都必须固定,前后端完全一致。否则即使排序没有问题,也会因为签名原文字符串不同而导致结果不一致。
落地时优先检查这 4 个点
如果你的接口已经出现“本地能过、联调验签失败”的情况,优先检查下面四件事:
- 签名前是否显式按统一规则排序,而不是依赖默认对象顺序;
- 嵌套对象是否被约定为固定字符串形式,还是被两端各自序列化;
- 后端是否真正按同样规则处理,而不是继续使用默认 JSON 输出;
- 签名字段范围、编码方式、salt 拼接方式是否完全一致。
总结下来,JSON 在签名验签里最重要的不是“长什么样”,而是“序列化后是否唯一且稳定”。只要把键排序、嵌套对象形态和前后端规则对齐这三件事定死,JavaScript 前后端分离接口里的大多数签名不一致问题,基本都能提前规避。















