



做 RAG、语义检索或推荐系统时,向量存储和相似度查询往往很快变成基础设施问题。对 Go 团队来说,真正难的通常不是“能不能连上”,而是该把向量放进现有 Postgres,还是直接上独立向量库。下面按 Pgvector、Milvus、Qdrant 三条路线拆开讲清楚各自的 Go 客户端、接入流程和适用边界,方便你结合数据规模、过滤需求和运维成本做判断。
先判断:Go 项目里该选哪类向量库
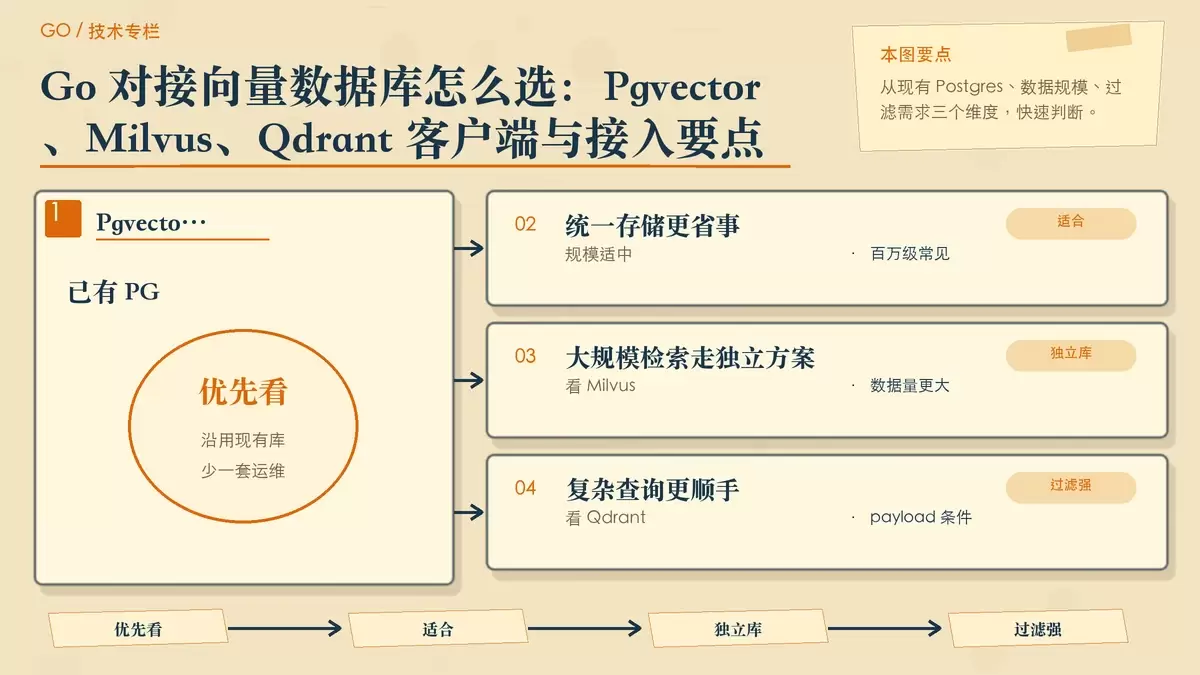
Go 里常见的选择大致分成三类:Pgvector、Milvus、Qdrant。三者都能完成向量写入和相似度检索,但落地方式并不一样,最核心的差别在于你是否已经依赖 Postgres、向量数据规模有多大,以及是否需要把向量检索单独扩缩容。
- Pgvector:PostgreSQL 扩展,把向量作为一列直接存进数据库。适合本来就已经在用 Postgres 的团队,不想额外维护新组件,且数据量在百万级以内、QPS 不是特别高的场景。Go 侧通常使用
pgx+pgvector-go。 - Milvus:独立向量数据库,偏向大规模和分布式场景。适合向量数据量很大,或者希望把检索系统独立部署、独立扩容的项目。Go 侧使用官方
milvus-sdk-go。 - Qdrant:同样是独立向量库,但在 API 设计上对过滤条件和多向量支持更友好。适合检索逻辑里需要 payload filter、字段过滤,或者希望接口使用更直接的团队。Go 侧使用
github.com/qdrant/go-client。
如果你想先快速定方向,可以直接按这条思路判断:已有 Postgres 且不想加运维负担,优先看 Pgvector;数据规模大、需要独立扩展,优先看 Milvus;过滤条件多、接口体验和多向量支持更重要,则优先看 Qdrant。
Pgvector:沿用 Postgres 的最省事方案
Pgvector 的优势很直接:不需要再引入一套新的数据库体系,而是在 PostgreSQL 里增加向量能力。对于已经有成熟 Postgres 运维体系的团队,这通常是最容易落地的一条路。
前提是 Postgres 已安装并启用 pgvector 扩展:
CREATE EXTENSION vector启用后,可以在表里直接使用向量列,例如 vector(1536)。Go 侧则用 pgx 负责连接数据库,用 pgvector-go 负责注册向量类型、完成读写。
接入流程怎么走
Pgvector 的核心流程比较贴近传统 SQL 项目:
- 启用扩展
- 建表,增加
vector(1536)列 - 在 Go 中注册向量类型
- 通过 SQL 插入向量数据
- 查询时使用
<->或<=>做相似度检索
这里的好处是,团队不需要额外学习太多新概念,表结构、事务、权限、备份策略都还能沿用原来的 PostgreSQL 体系。对于业务数据和向量数据需要一起管理的项目,这种统一存储方式会省掉不少工程成本。
它适合哪些 Go 团队
如果你的项目已经建立在 Postgres 上,而且向量检索更多是给 RAG、语义检索、推荐做辅助能力,而不是单独支撑超大规模检索服务,那么 Pgvector 往往是优先级最高的选择。
它尤其适合下面这类情况:
- 已有 Postgres,不希望新增数据库组件
- 数据量不算特别大,百万级以内更容易管理
- QPS 不是特别夸张,更看重系统整体简单
- 希望继续用 SQL 方式完成插入、查询和运维
相关项目地址:
- 官方扩展:
github.com/pgvector/pgvector - Go 客户端:
github.com/pgvector/pgvector-go
Milvus:面向大规模向量检索的独立方案
Milvus 和 Pgvector 最大的不同,是它本身就是独立向量数据库,而不是关系型数据库扩展。对 Go 开发者来说,这意味着接入前要先准备服务实例,无论是本地 Docker、单机服务还是集群部署,都会比 Pgvector 多一层基础设施。
Go 侧通常使用官方 milvus-sdk-go。它的建模方式也和 SQL 习惯不太一样,重点概念包括:
- Collection:类似表
- Field:字段定义,通常包括主键、向量列等
- 列式插入:插入数据时按列组织,而不是按单条记录拼对象
核心流程比 Pgvector 多几步
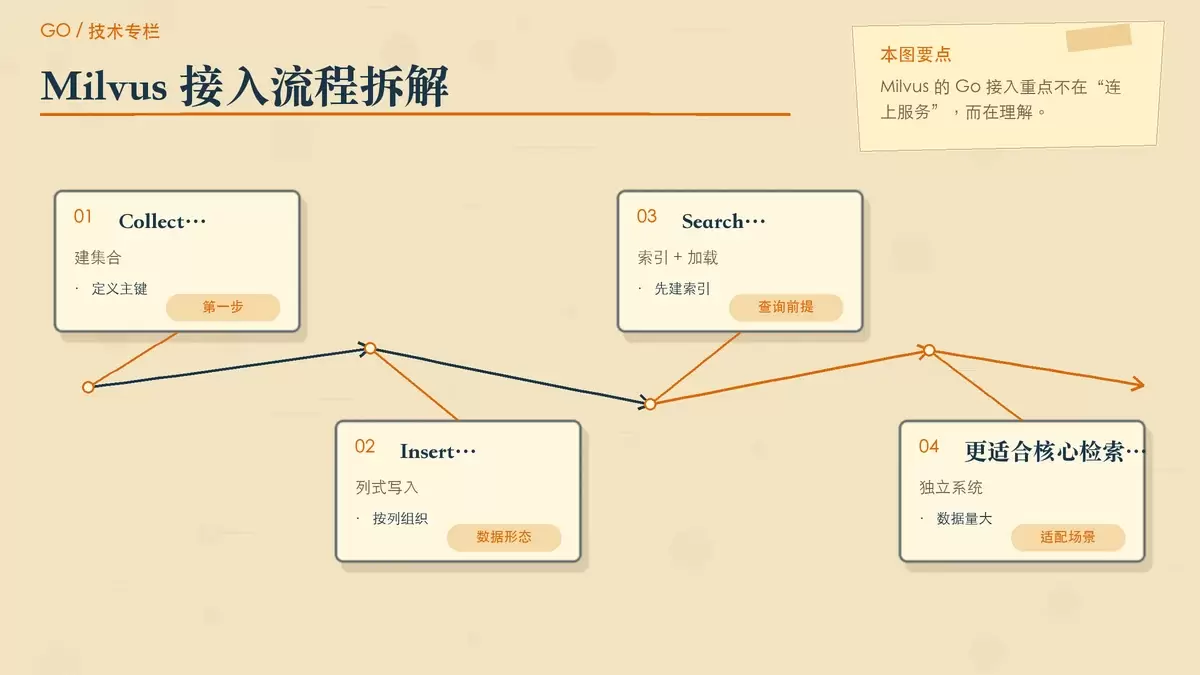
Milvus 的常见接入流程是:
- 建
Collection - 按列执行 Insert
- 创建索引
- 执行
LoadCollection - 再进行 Search
这条流程里有两个点尤其值得注意。第一,Milvus 的插入更偏列式思路,初次接触时需要调整一下数据组织方式。第二,查询前通常要先建索引并 LoadCollection,它不像传统数据库那样“写进去就马上按同一种方式查”。
也正因为它是围绕向量检索场景单独设计的,Milvus 更适合把检索能力作为独立系统来建设,而不是数据库中的附属功能。
什么时候该优先考虑 Milvus
如果你的场景里,向量已经不是“顺手加上的一个字段”,而是业务核心数据之一,Milvus 的价值就会更明显。尤其是在数据量继续增长、检索服务需要单独扩容时,它的架构会比把所有东西都压在 Postgres 里更从容。
比较典型的适用场景包括:
- 向量数据规模很大
- 需要独立部署、独立扩缩容
- 检索服务本身就是系统中的核心能力
- 团队能接受额外的服务运维复杂度
相关项目地址:
- 官方仓库:
github.com/milvus-io/milvus - Go SDK:
github.com/milvus-io/milvus-sdk-go
Qdrant:过滤和多向量支持更顺手
Qdrant 同样是独立向量数据库,但它在使用体验上和 Milvus 有一点明显区别:API 设计更贴近直接可用的检索服务,尤其是在过滤条件和多向量能力上,经常会让业务开发更省心。
Go 里常用的是 github.com/qdrant/go-client,支持 gRPC。Qdrant 的基础概念相对直观:
- Collection:存储集合
- Point:一条向量记录,通常包含
id + vector + payload - payload:和向量一起保存的附加字段,可用于过滤查询
Go 侧接入流程比较直接
Qdrant 的核心流程通常是:
- 创建
Collection - 通过 Upsert 写入 points
- 执行 Search
- 按需附带 payload 过滤条件
和 Milvus 相比,Qdrant 在很多项目里给人的感受是“上手阻力更小”。如果你的检索请求不只是找最近邻,还需要结合业务字段过滤,例如按分类、租户、时间范围或状态筛选,再做向量相似度匹配,那么 Qdrant 往往会更合适。
哪些场景更值得看 Qdrant
Qdrant 适合那些检索条件不只围绕向量距离本身的业务。比如一个知识库搜索系统,除了相似度,还要限制文档类型、标签、来源或权限范围;又或者推荐系统里需要同时处理多种向量表达。此时它的 payload filter 和多向量支持会更有吸引力。
可以重点考虑它的情况包括:
- 查询经常需要带过滤条件
- 业务里存在多向量建模需求
- 希望 API 和客户端体验更直接
- 愿意为独立向量库承担一定运维成本
相关项目地址:
- 官方仓库:
github.com/qdrant/qdrant - Go 客户端:
github.com/qdrant/go-client
怎么做最终选择
如果只看一句话结论,这三种方案可以这样理解:
- Pgvector:Postgres 扩展,Go 用
pgx+pgvector-go,建表时加入vector(N)列,查询依赖 SQL 和<->/<=>,适合已有 PostgreSQL、数据量不大的场景。 - Milvus:独立向量库,Go 用
milvus-sdk-go,流程是建 Collection → 列式 Insert → 建索引 →LoadCollection→ Search,适合大规模和需要独立扩展的系统。 - Qdrant:独立向量库,Go 用
go-client,流程是 CreateCollection → Upsert points → Search,且可叠加 payload 过滤,适合检索条件复杂、过滤需求多的项目。
真正做选型时,不必先追求“功能最全”,而是先看现有架构和团队成本。如果你的目标是尽快把 Go 项目的向量检索跑起来,Pgvector 往往是最省事的一步;如果检索系统本身已经独立成型,再去看 Milvus 或 Qdrant 会更合适。















