



想让大模型回答企业知识库、产品文档或内部流程里的问题,直接把整份文档塞进提示词通常并不现实:一方面 Token 开销高,另一方面上下文一长,模型也更容易漏掉关键信息。RAG(检索增强生成)的价值,就在于先把文档拆开并建立可检索的表示,再在提问时只取最相关的片段送给模型。
如果你准备用 Go 落一套最小可用的 RAG 服务,真正需要先想清楚的不是“框架选哪家”,而是三件事怎么串起来:文档如何切、文本如何向量化、问题来了以后如何把相关片段找回来。下面按这条主线展开,并补上实现时最容易踩坑的参数和优化点。
RAG 为什么适合知识问答场景
大模型在知识问答里常见的两个限制比较明确:上下文长度有限,没法无成本装下大量原始文档;知识有时效性,模型训练数据未必覆盖你当前的内部资料或最新版本文档。
RAG 的思路,是把“知识存储”和“答案生成”拆开:
- 预处理阶段:先把文档切成多个小块,每块都转成向量(embedding),再存进向量数据库或向量索引。
- 查询阶段:用户提问时,把问题也转成向量,在向量库里找最相似的文档块。
- 生成阶段:把检索结果作为上下文,与用户问题一起发给模型,让模型基于这些内容作答。
这样做的直接好处有两个:第一,不需要把整库文档都塞进提示词;第二,文档更新后只要更新索引,就能让系统拿到最新知识,不必重新训练模型。对大多数企业内部问答、帮助中心问答、文档助手来说,这已经是最实用的一条路线。
文档切块怎么做,才能兼顾长度和语义
RAG 的效果,往往先输在切块上。块切得太大,检索结果不够精确,还会浪费上下文;块切得太碎,语义不完整,模型拿到的上下文也可能答不出完整意思。
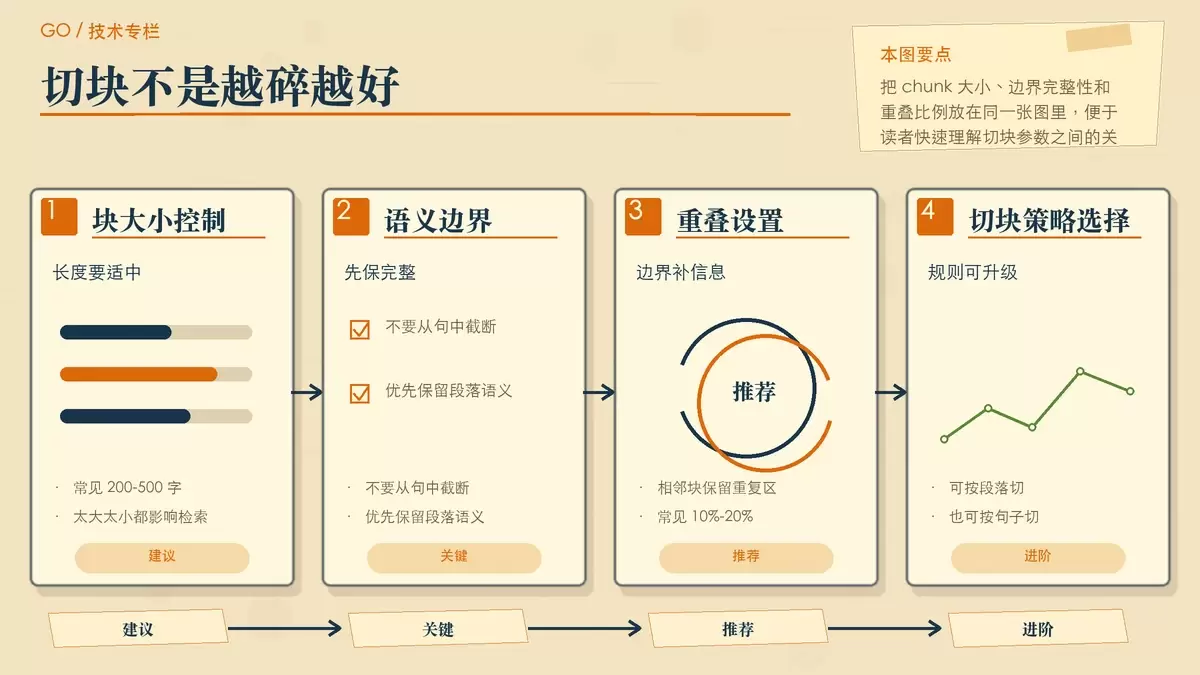
一个常见经验是:每块控制在 200-500 字,并尽量保证内容完整,不要从一句话中间硬切开。相邻块之间还可以加入少量重叠,避免关键信息刚好落在边界位置时被截断。实践里常见的重叠比例是 10%-20%。
最简单的实现方式,是按字符数切块:
type Chunk struct {
    ID       string
    Content  string
    Metadata map[string]string
}

func SplitText(text string, chunkSize, overlap int) []Chunk {
    var chunks []Chunk
    start := 0
    for start < len(text) {
        end := start + chunkSize
        if end > len(text) {
            end = len(text)
        }
        chunks = append(chunks, Chunk{Content: text[start:end]})
        if end >= len(text) {
            break
        }
        start = end - overlap // 重叠处理
    }
    return chunks
}
这段代码适合先把流程跑通:给定 chunkSize 和 overlap,从头到尾滑动切片,生成一组连续 chunk。它的优点是简单直接,缺点也明显,就是可能把句子、段落甚至代码片段从中间切断。
所以在更接近生产环境的实现里,切块策略通常会往语义完整性继续优化:
- 按段落切:遇到空行就分段,阅读体验更自然,但每块大小可能不均匀。
- 按句子切:通过标点或分句规则拆分,语义最完整,但需要额外文本处理能力。
- 混合策略:先按段落或句子切,再做长度控制,超长部分再二次拆分。
如果文档里还带有文件名、章节标题、时间、业务标签等信息,建议在 Metadata 里一起存下来。后面做过滤检索或结果追溯时,这些元数据会比你想象中更有用。
向量化怎么接入 Embedding API
切完块之后,下一步是把文本转成向量。向量化的本质,就是调用 Embedding API,把一段文本变成固定长度的浮点数组。比如 text-embedding-3-small,常见返回就是一组 1536 维 向量。语义越接近的文本,它们在向量空间里通常也越接近。
在 Go 里,可以先封装一个最小客户端:
type EmbeddingClient struct {
    APIKey  string
    BaseURL string
}

func (c *EmbeddingClient) Embed(ctx context.Context, text string) ([]float32, error) {
    // POST {BaseURL}/embeddings
    // Body: {"model": "text-embedding-3-small", "input": text}
    // 返回: {"data": [{"embedding": [...]}]}
    // 实际用 http.Client 或第三方 SDK 实现
    return callEmbeddingAPI(text), nil
}
这里保留了最关键的接口形态:输入是一段文本,输出是一组 []float32。无论你后面换成官方 SDK、第三方封装,还是自建兼容接口,这一层抽象基本都可以保留。
接入时有几个判断标准比较实用:
模型怎么选
text-embedding-3-small 通常是一个性价比更高的起点,适合先验证检索效果;如果你更关注召回质量,也可以考虑 text-embedding-3-large,但成本会更高。
为什么尽量做批量调用
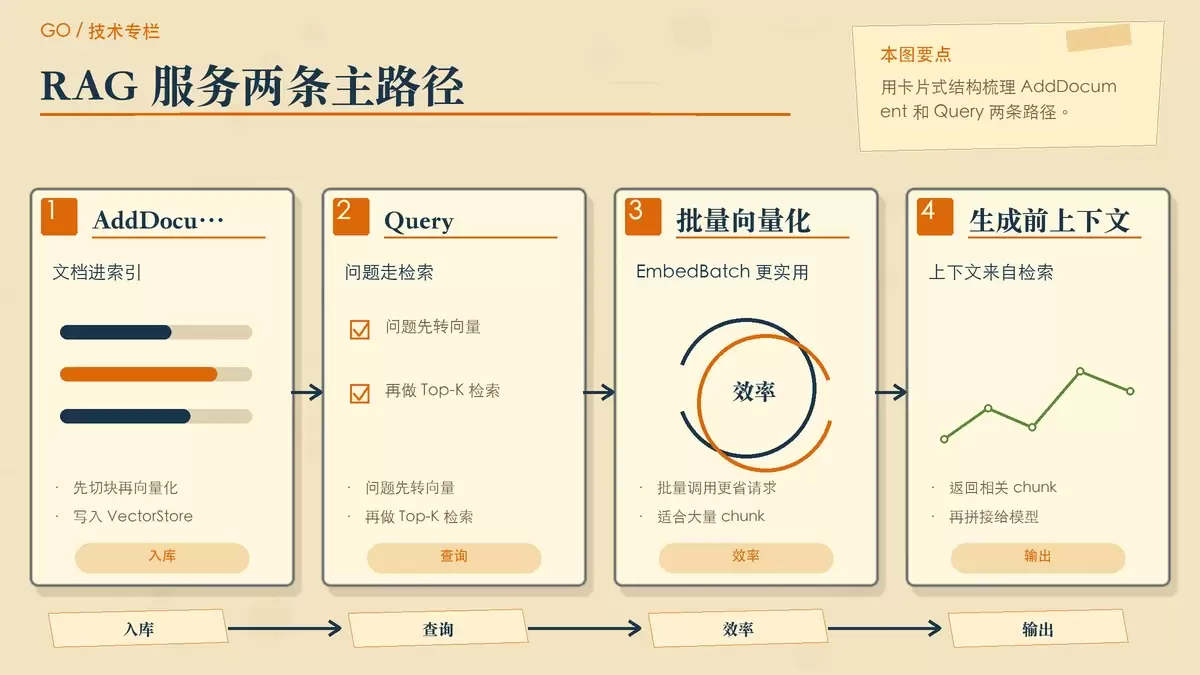
文档入库时,往往不是只处理一段文本,而是一次处理很多 chunk。逐条请求虽然容易写,但吞吐和成本控制都不理想。更实际的方式,是提供 EmbedBatch,一次传多个文本,减少请求次数并提升整体效率。
哪些内容适合缓存
如果同一段文本会重复入库,或者文档更新并不频繁,那么相同文本生成的向量可以缓存,避免重复计算。尤其在知识库反复重建索引、增量同步的场景里,缓存通常能明显降低调用成本。
总的来说,这一步的目标不是“把 API 调通”这么简单,而是建立一条后续可扩展的向量生成通道:既支持单条查询,也支持批量入库,还能在需要时补上重试、限流和缓存。
检索阶段:如何用相似度找回最相关的文档块
RAG 真正决定答案上下文质量的,是检索阶段。逻辑上它并不复杂:先把用户问题转成向量,再拿这个向量和所有文档块的向量做相似度计算,最后选出最相关的前几个结果。
常见做法是使用余弦相似度。可以先用一个内存版向量库把原理跑明白:
type VectorStore struct {
    chunks  []Chunk
    vectors [][]float32
}

func (vs *VectorStore) Add(chunk Chunk, vector []float32) {
    vs.chunks = append(vs.chunks, chunk)
    vs.vectors = append(vs.vectors, vector)
}

func (vs *VectorStore) Search(queryVector []float32, k int) []Chunk {
    // 遍历算 cosineSimilarity(queryVector, vec),按 score 降序排序后取前 k 个 chunk
    // cosineSimilarity(a,b) = 点积(a,b) / (|a|*|b|)
    return nil
}
这个版本的重点不在性能,而在于把数据结构和调用链路说明白:
Add负责把文档块及其向量一起存入索引。Search负责遍历向量、计算相似度、排序并返回 Top-K 结果。
当数据量较小时,内存检索已经足够帮助你验证 chunk 策略、Embedding 模型和召回效果。等到文档规模变大,再切换到专业向量数据库通常更合适,比如 Pgvector、Milvus、Qdrant 等,它们能提供索引、批量写入和更高效的相似度搜索能力。
这里还有两个参数特别值得单独调:
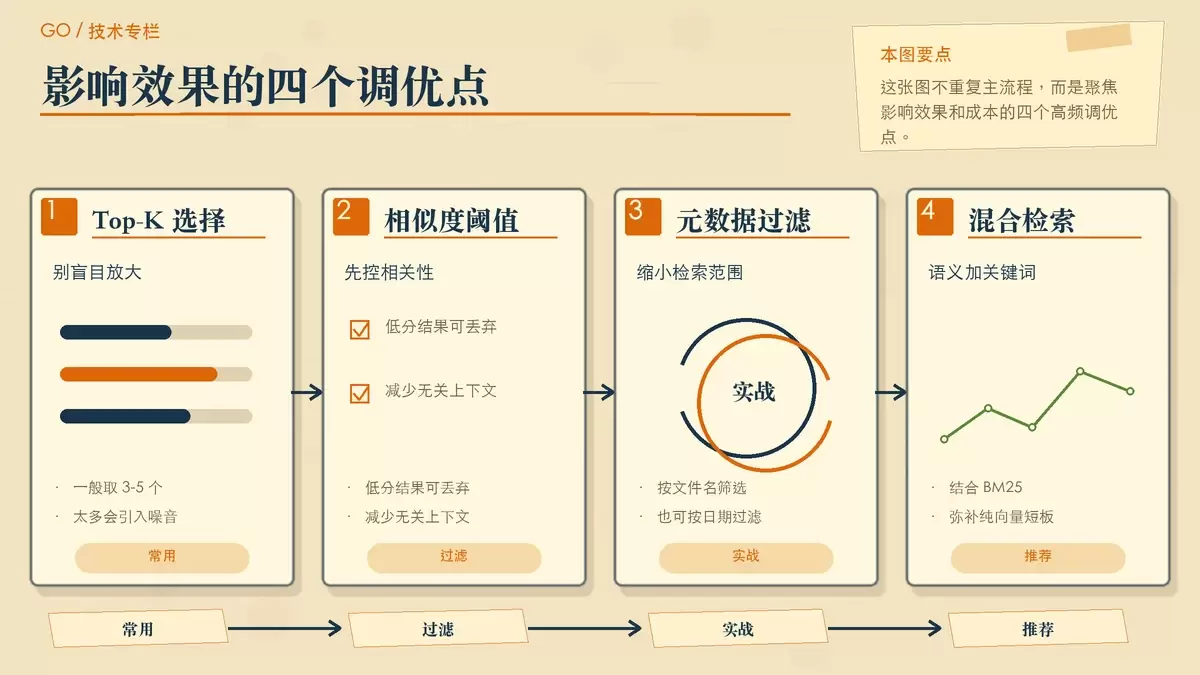
Top-K 取多少合适
常见经验是取 3-5 个 最相似的块。太少,可能漏掉关键背景;太多,则容易把噪音一并带进提示词,反而影响生成质量。
是否需要设置相似度阈值
建议加。即使系统能返回前 K 个结果,也不代表这些结果都相关。如果相似度太低,宁可少给上下文,也不要把明显无关的片段拼进 prompt。
把三步串起来:一个最小可用的 Go RAG 服务
前面的切块、向量化、检索,其实已经构成了完整 RAG 的主干。把它们收拢到一个服务里,大致可以写成下面这样:
type RAGService struct {
    embeddingClient *EmbeddingClient
    vectorStore     *VectorStore
}

func (r *RAGService) AddDocument(ctx context.Context, text string) error {
    chunks := SplitText(text, 500, 50)
    vectors, err := r.embeddingClient.EmbedBatch(ctx, extractTexts(chunks))
    if err != nil {
        return err
    }
    for i := range chunks {
        r.vectorStore.Add(chunks[i], vectors[i])
    }
    return nil
}

func (r *RAGService) Query(ctx context.Context, question string, topK int) ([]Chunk, error) {
    queryVector, err := r.embeddingClient.Embed(ctx, question)
    if err != nil {
        return nil, err
    }
    return r.vectorStore.Search(queryVector, topK), nil
}
这段代码已经把职责分得比较清楚:
AddDocument负责文档入库,内部依次完成切块、批量向量化、写入向量存储。Query负责查询,把问题向量化之后直接走检索。
调用方式也很直观:
rag := NewRAGService("api-key", "https://api.openai.com/v1")
rag.AddDocument(ctx, "这是一段很长的文档内容...")
chunks, _ := rag.Query(ctx, "文档里说了什么?", 3)
prompt := fmt.Sprintf("基于以下上下文回答问题:n%snn问题:%s",
    chunks[0].Content, question)
真正接到生成模型时,通常不会只拼接 chunks[0],而是把多个检索结果按顺序组织成上下文,再与用户问题一起发送。这里的关键不是 prompt 写法本身,而是要保证送入模型的内容来自检索结果,而不是把原始大文档重新整份塞回去。
如果继续往工程化推进,这个服务一般还会补上几类能力:文档去重、增量更新、失败重试、元数据过滤,以及生成答案时返回命中的来源片段。这样做既方便排障,也更利于业务侧判断回答是否可信。
落地时最值得优先优化的几个点
把最小流程跑通后,影响效果和成本的,通常就是切块、向量化和检索这三处细节。
1. 先调切块,再调模型
很多场景里,检索效果差并不一定是 Embedding 模型不够强,而是 chunk 粒度不对。按字符数切最容易启动,但也最容易把完整语义拆碎。优先把“块大小”“边界规则”“重叠比例”调顺,通常比盲目换模型更有效。
2. 批量向量化和缓存能直接压成本
入库场景优先考虑 EmbedBatch,避免逐条请求。对重复文档或稳定文本做缓存,也能减少重复向量化。尤其在重建索引或周期性同步文档时,这两项优化非常划算。
3. 数据量上来后尽快换专业向量库
内存版实现适合理解原理和做小规模验证,但数据一大,遍历所有向量的方式很快会遇到性能瓶颈。这时可以转向 Pgvector、Milvus、Qdrant 等方案,用索引和批量写入能力支撑真实业务负载。
4. 检索不要只靠向量
如果文档里包含很多专有名词、版本号、函数名、文件名,单纯依赖语义检索未必稳定。更实用的做法,是把关键词检索(如 BM25)和向量检索结合起来做混合检索,通常比单一路径更稳。
5. 给检索加上元数据过滤
当知识库覆盖多个产品线、多个版本或不同时间范围时,只靠相似度排序可能还不够。把文件名、日期、分类等信息写入元数据后,查询时就可以先过滤再检索,减少不相关结果混入。
6. 文档更新尽量做增量处理
实际项目里,文档不会一直静止不变。相比每次全量重建索引,更推荐只重新切块并向量化发生变化的部分,这样更新速度和成本都会更可控。
从工程优先级看,最小建议可以概括成一句话:先用内存版和简单切块验证链路,再逐步补上批量化、缓存、元数据过滤和专业向量库,而不是一开始就把系统做得过重。
结语
用 Go 实现 RAG,核心并不神秘,主线就是三步:文档切块、向量化、相似度检索。其中,切块决定语义边界,Embedding 决定文本表示方式,检索策略决定最终送给模型的上下文质量。
如果你要从零搭一个原型,完全可以先从最小版本开始:把长文档按 200-500 字 切块,设置 10%-20% 的重叠,用 text-embedding-3-small 做向量化,再取 3-5 个最相似结果拼给模型。等链路验证通过,再逐步替换为批量调用、缓存、元数据过滤和更正式的向量数据库,这就是一条足够稳妥的落地路径。















