



用 Go 做语义检索、推荐或 RAG 时,向量相似度几乎是绕不开的一步,但真正该怎么做,往往取决于数据规模、性能要求,以及你是否需要索引检索能力。本文把 Go 里最常见的三种实现路径拆开讲:什么时候手写最省事,什么时候该用数值库提速,什么时候应该把计算和检索交给向量数据库,并给出一套足够实用的选型判断方式。
为什么向量相似度要分成几种做法
向量相似度常见于语义检索、推荐、去重、聚类等场景,但不同项目的量级差别很大。有的场景只是把几百到几千个向量放在内存里逐个比较,有的则要面对十万、百万级数据,还要做近似最近邻(ANN)检索。
这也是为什么不存在一种写法可以通吃所有情况。小数据量时,自己写几段函数已经够用;数据再往上走,单靠手写循环就会开始碰到性能和维护问题;如果还要索引、召回、Top-K 检索,那就已经进入向量数据库更擅长的范围。
因此,选方案时最核心的判断不是“哪种更高级”,而是三件事:数据量多大、是否仍在进程内计算、是否需要 ANN 检索。
方案一:手写实现,适合小规模和零依赖场景
如果你的向量数量不多,比如几百、几千条,或者你希望完全掌控打分逻辑,又不想额外引入依赖,那么直接在 Go 里手写相似度函数,是最轻量也最直接的办法。
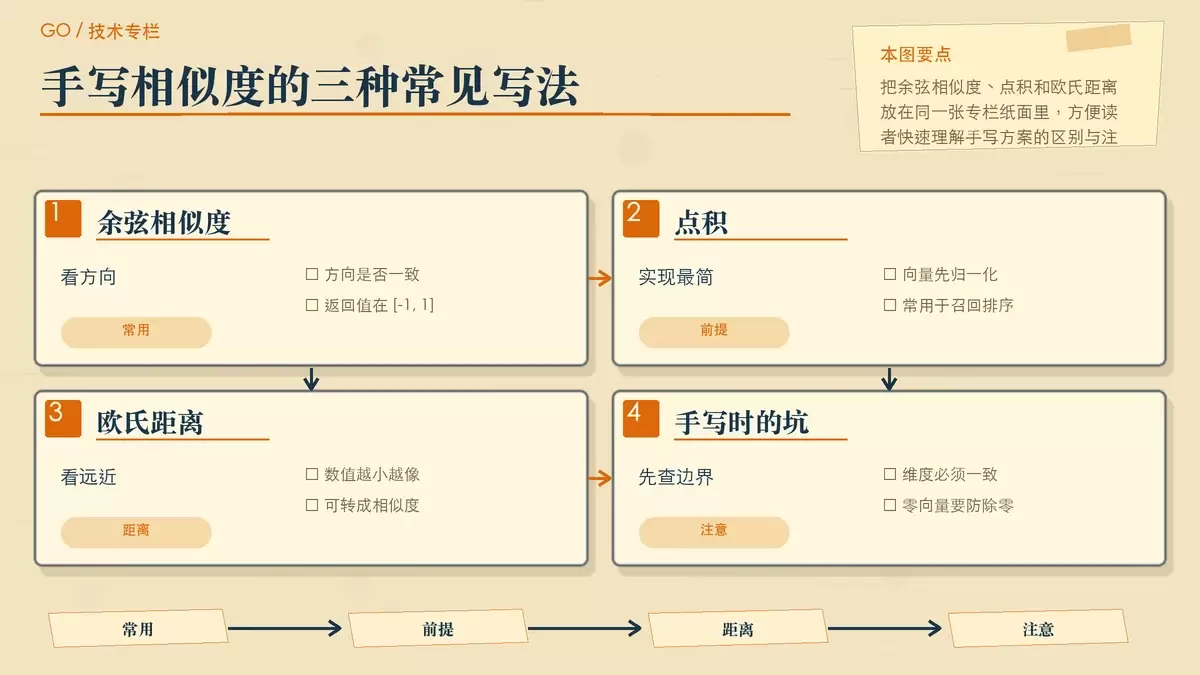
通常用 []float64 就能完成常见的三种度量:余弦相似度、点积和欧氏距离。
余弦相似度:适合高维 embedding
余弦相似度关注的是两个向量的方向是否接近,而不是长度是否一致,因此在高维 embedding 场景里非常常见。它的返回值范围是 [-1, 1]。
// CosineSimilarity 计算两向量的余弦相似度,返回值在 [-1, 1]
func CosineSimilarity(a, b []float64) float64 {
    if len(a) != len(b) || len(a) == 0 {
        return 0
    }
    var sumAB, sumA2, sumB2 float64
    for i := range a {
        sumAB += a[i] * b[i]
        sumA2 += a[i] * a[i]
        sumB2 += b[i] * b[i]
    }
    if sumA2 == 0 || sumB2 == 0 {
        return 0
    }
    return sumAB / (math.Sqrt(sumA2) * math.Sqrt(sumB2))
}
这类写法的优点很明显:逻辑直观、依赖为零、调试也方便。对于本地排序、简单召回或实验性质的功能,已经足够实用。
点积:归一化后可以直接替代余弦
如果你的向量在进入计算前已经做过归一化,那么点积和余弦相似度在效果上通常可以视为同一回事,但实现更简单。很多召回、排序流程会直接使用点积。
// DotProduct 计算两向量的点积
func DotProduct(a, b []float64) float64 {
    if len(a) != len(b) {
        return 0
    }
    var sum float64
    for i := range a {
        sum += a[i] * b[i]
    }
    return sum
}
这里的关键不在于公式本身,而在于你是否确认了向量已经归一化。这个前提如果不成立,点积和余弦的语义就不再相同,结果也可能偏离预期。
欧氏距离:适合直接衡量“距离有多远”
欧氏距离描述的是两个点之间的直线距离,数值越小,通常说明越接近。它本身是“距离”,如果业务上更想要“相似度”,可以再做一层转换,例如使用 1/(1+distance) 这样的形式。
// EuclideanDistance 计算欧氏距离
func EuclideanDistance(a, b []float64) float64 {
    if len(a) != len(b) {
        return math.MaxFloat64
    }
    var sum float64
    for i := range a {
        diff := a[i] - b[i]
        sum += diff * diff
    }
    return math.Sqrt(sum)
}
欧氏距离更像是在回答“差多少”,而余弦更像是在回答“方向像不像”。两者适用场景并不完全相同,不能简单互换。
手写实现时要先避开这几个坑
手写方案虽然简单,但有几个边界条件必须先处理好:
- 两个向量的维度必须一致,否则结果本身就没有可比性。
- 要处理空向量、全零向量,尤其是余弦相似度里要避免除零。
- 外部输入的向量要先确认是否已经归一化,再决定用点积还是余弦。
总结来说,手写方案适合“小而确定”的计算任务:依赖少、改动快、可定制性高,但不太适合直接扛大规模检索。
方案二:数值库,适合进程内批量计算和性能提升
当你的场景变成“一个查询向量要对很多候选向量反复计算相似度”,或者你已经开始关注矩阵运算带来的性能收益,单纯手写循环通常就不再是最佳选择。
这时更合适的路径是使用 Go 里的数值库,例如 gonum(gonum.org/v1/gonum)。它提供了向量、矩阵相关能力,点积、范数等基础运算都能直接使用,拿来组织余弦相似度或欧氏距离计算会更稳妥,也更容易扩展到批量处理。
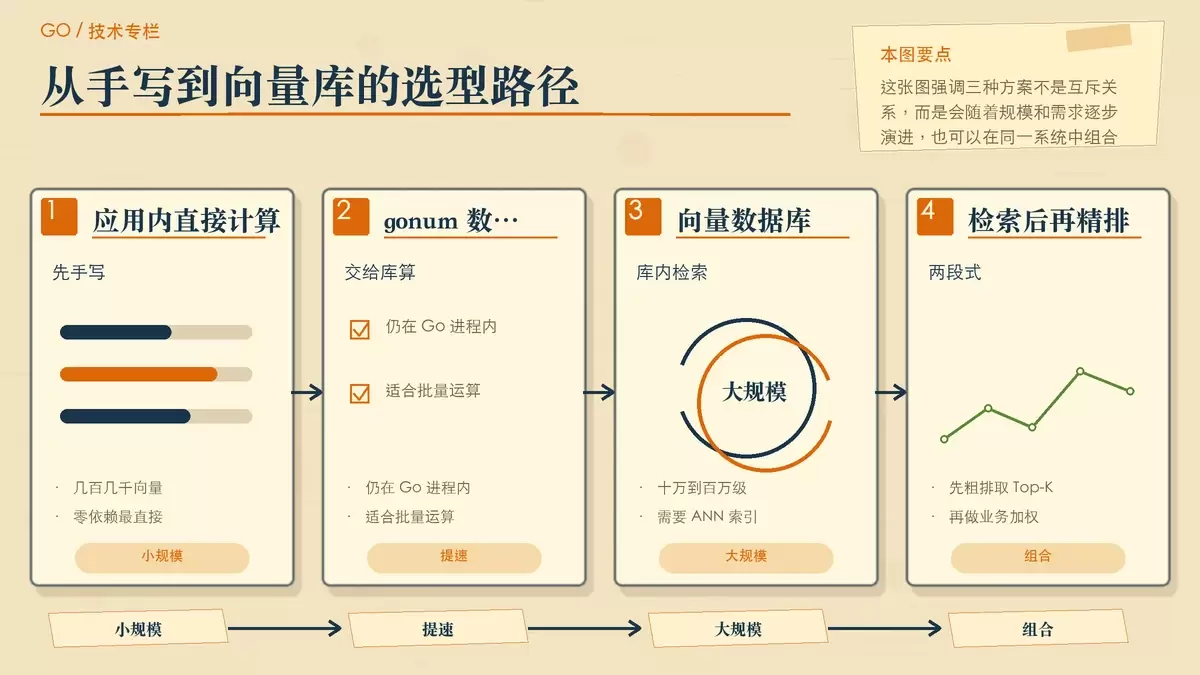
这一类方案的特点可以概括为一句话:仍然在自己的 Go 进程里算,但把底层运算交给专业库。它处在“自己手写”和“直接上向量数据库”之间,适合那些数据量已经上来、又还没到必须引入向量库的阶段。
如果你已经遇到以下情况,通常就可以优先考虑这一层方案:
- 同一个查询要频繁对很多候选向量做比较。
- 你希望减少重复手写循环和基础数学处理。
- 系统暂时还不需要 ANN 索引,但已经需要更高吞吐。
它的价值并不只是“少写几行代码”,更重要的是在不改变系统架构的前提下,把性能和可维护性往前推一步。
方案三:向量数据库,适合大规模检索和 ANN
如果你的向量规模已经来到十万、百万级,或者你明确需要建立索引来做近似最近邻检索,那么继续在应用进程里硬算,收益通常已经不高。这时应该考虑把相似度计算和检索任务交给专门的向量数据库。
常见方案包括 Milvus、Pinecone、Qdrant、Weaviate 等,它们都提供 Go SDK。接入后,你通常不再需要在 Go 里自己实现大规模相似度遍历,而是把向量写入库中,查询时传入目标向量,由数据库负责完成相似度计算、索引检索和 Top-K 返回。
这类方案通常支持余弦、点积、欧氏等常见度量方式,因此 Go 代码的职责会明显收缩:一部分是调用 SDK,另一部分是承接业务逻辑,而不是自己维护底层检索实现。
不过这并不意味着应用侧彻底不再计算相似度。一个常见做法是:先由向量数据库完成粗排和召回,再在 Go 里对返回的少量结果做二次排序、过滤,或叠加自定义打分。这种组合方式在实际项目里很常见,因为它兼顾了检索规模和业务灵活性。
怎么选:按数据规模、性能目标和检索方式判断
如果只看落地决策,可以直接按下面这组规则判断:
- 数据量小,不想加依赖,或者打分逻辑需要自己精细控制:选手写实现。
- 数据量开始上来,仍想在进程内完成计算,同时希望提升性能:选数值库,例如 gonum(
gonum.org/v1/gonum)。 - 向量规模很大,需要索引和 ANN 检索能力:选向量数据库 + Go SDK。
这三种方式并不是互斥关系,完全可以组合使用。一个典型模式就是:向量数据库先做粗排,取回 Top-K,再由 Go 代码补一层业务相关的相似度或加权逻辑。
真正值得关注的,不是哪种方案“更标准”,而是它是否符合你当前的数据规模和系统阶段。很多项目一开始用手写就够了,后续随着数据和吞吐增长,再逐步演进到数值库或向量数据库,这样通常比一开始就把架构做重更实际。
结语
在 Go 里计算向量相似度,主流做法基本就是三条路:小规模场景用手写函数解决;需要批量计算和更好性能时,引入数值库;当数据规模进入大规模检索阶段,再把 ANN 和相似度计算交给向量数据库。只要先把数据量、归一化状态、是否需要索引这几个判断点看清,选型通常并不复杂。















