



反射在 Go 里并不罕见,JSON 序列化、ORM、依赖注入乃至一些通用框架,底层都离不开它。但问题也很直接:一旦把反射放进循环、请求主路径或高频数据处理中,性能损耗往往会被迅速放大。本文不只讲“反射慢”,而是把常见瓶颈拆开来看,再对应给出几种实际可落地的优化办法,帮助你判断什么时候该缓存、什么时候该换索引、什么时候该直接放弃运行时反射。
为什么 Go 反射会拖慢程序
反射的价值在于运行时动态处理类型和值,但这份灵活性不是免费的。它的性能损耗,通常集中在下面几类成本上。
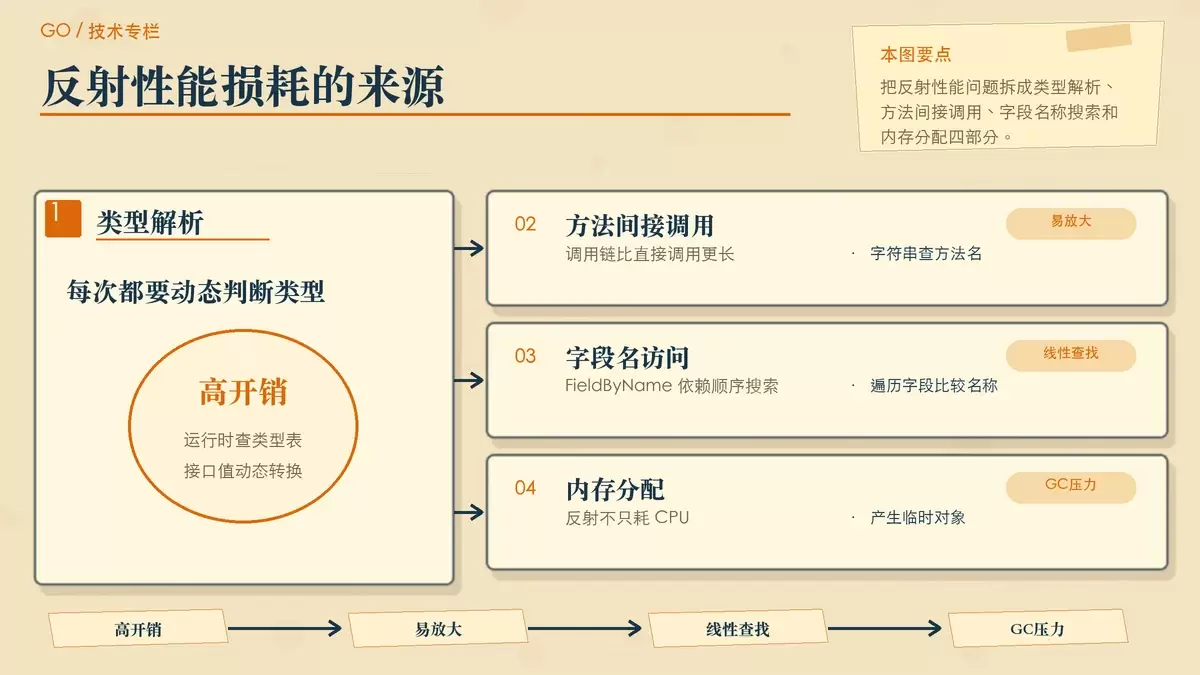
运行时类型解析本身就有代价
每次进入反射逻辑,程序都要动态检查类型信息,这里面涉及类型信息表查找、接口值拆解以及动态转换。直接调用由编译器在编译期就确定下来,而反射需要把这些判断留到运行时完成。
方法调用存在额外间接层
如果通过反射调用方法,通常要先按字符串查找方法名,再做参数类型校验,最后构造调用过程。相比之下,普通方法调用就是明确的直接跳转,两者路径长度完全不同。
按名称取字段通常是线性搜索
FieldByName() 是很多人最容易顺手写出来的 API,但它也是最容易在热路径里拖后腿的操作之一。原因很简单:它通常要遍历字段并逐个比较名字,结构体字段越多,这个成本越明显。
临时对象会推高内存分配和 GC 压力
反射不只是“慢在 CPU”,也常常“慢在内存”。频繁创建 reflect.Value 等临时对象,会让分配次数和垃圾回收负担一起上升。原文给出的量级是,每个 reflect.Value 约占 96 字节;一旦进入高频调用场景,这部分额外开销就很难忽略。
一个很有代表性的测试结论是:反射按名称赋值的性能仅为直接赋值的 0.26%。这意味着如果你的代码本来就在高并发、低延迟或大批量处理中运行,反射很可能就是那个最值得先查的瓶颈点。
五种更实用的反射优化策略
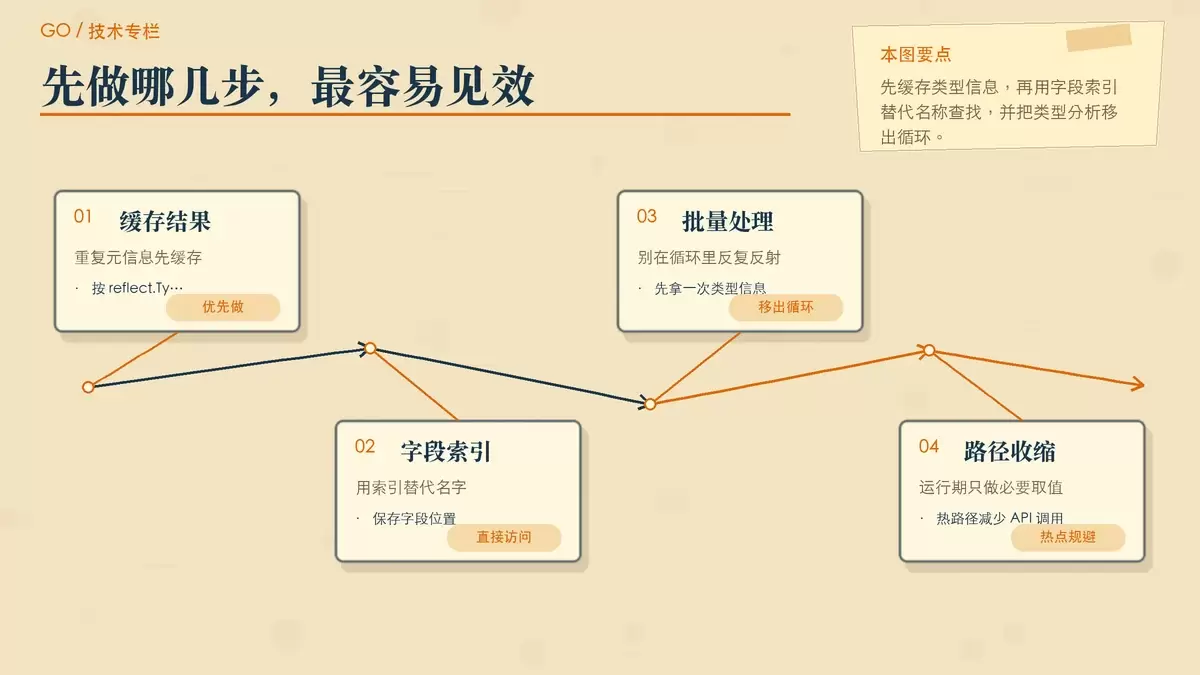
优化反射,核心不是“把所有反射删掉”,而是尽量把它从高频路径挪开、把重复工作变成一次性工作,或者在合适的地方直接换一种实现方式。
缓存反射结果,避免每次重复解析
这是最常见、也是收益最稳定的一类优化。对于同一种结构体,如果你会反复读取字段、方法或标签信息,就不应该每次都重新走一遍反射分析流程。
常见做法是按 reflect.Type 缓存字段索引、方法映射或标签元数据,把原本重复发生的类型解析变成首次构建、后续复用。
// 使用全局缓存存储类型信息
var typeCache sync.Map // map[reflect.Type]map[string]int

func GetFieldIndex(t reflect.Type, fieldName string) int {
    // 尝试从缓存读取
    if cache, ok := typeCache.Load(t); ok {
        return cache.(map[string]int)[fieldName]
    }

    // 缓存未命中,构建字段索引映射
    indexes := make(map[string]int)
    for i := 0; i < t.NumField(); i++ {
        indexes[t.Field(i).Name] = i
    }

    typeCache.Store(t, indexes)
    return indexes[fieldName]
}
这类缓存能把原本接近 O(n) 的重复查找压缩成 O(1) 查表。按原文描述,方法查找性能可提升 5-10 倍。在序列化库、标签解析器、ORM 元数据处理这类场景里,这通常是第一步就该做的优化。
用字段索引替代字段名查找
如果某个字段会被频繁访问,尤其是在循环里反复取值,那么把 FieldByName 换成索引访问,往往能立刻看到差异。
type FieldCache struct {
    indexes map[string]int
    typ     reflect.Type
}

func (c *FieldCache) GetField(value reflect.Value, fieldName string) reflect.Value {
    if index, ok := c.indexes[fieldName]; ok {
        // 使用索引直接访问字段,避免名称查找
        return value.Field(index)
    }
    return reflect.Value{}
}
这背后的逻辑并不复杂:按名字找字段,需要做字符串比较;按索引取字段,则是直接定位。原文举的例子是,假设结构体有 20 个字段,那么按名称查找平均可能需要 10 次比较,而按索引访问则没有这层额外成本。
这类方式特别适合“字段固定、访问频繁”的代码,例如批量导出、序列化、表单绑定、数据库记录映射等。
批量处理同类型数据,别在循环里重复做同一件事
很多反射性能问题不是因为“必须用反射”,而是因为“同一个反射动作做了太多次”。如果你要处理一批相同类型的数据,应该先做一次类型分析,再把结果复用于整批对象。
// 不推荐:在循环内每次反射
for _, obj := range objects {
    val := reflect.ValueOf(obj)
    name := val.FieldByName("Name").String() // 每次都要查找
}

// 推荐:预先解析类型信息
firstVal := reflect.ValueOf(objects[0])
typ := firstVal.Type()
nameIndex := getFieldIndex(typ, "Name") // 一次性获取字段索引

for _, obj := range objects {
    val := reflect.ValueOf(obj)
    name := val.Field(nameIndex).String() // 使用索引直接访问
}
这种写法的关键点在于:把“类型分析”从循环体里挪出去。这样做对 JSON 数组处理、批量记录转换、日志结构化输出都很有效,因为它减少的不只是函数调用次数,还包括大量重复的字符串匹配和元信息查找。
性能极敏感时,用代码生成替代运行时反射
如果某段逻辑已经明确处于热点路径,而且类型结构相对稳定,那么继续在运行时依赖反射,通常就不是最优解了。这个时候可以考虑把动态解析搬到编译阶段,通过 go generate 生成针对具体类型的代码。
// 使用go generate生成类型特定代码
//go:generate go run generate.go

// 生成的代码完全避免反射
func (u *User) ToMap() map[string]interface{} {
    return map[string]interface{}{
        "Name": u.Name,
        "Age":  u.Age,
    }
}
原文给出的结论是,代码生成方案的性能可以达到反射的 40 倍。更重要的是,生成后的代码仍然是普通 Go 代码,编译器可以继续内联、消除边界检查或做其他优化。像 gRPC、Protocol Buffers 这类成熟项目,本质上就是通过生成代码来绕开运行时反射成本。
当然,这种方案也有明显代价:开发链路更复杂、代码维护成本更高、调试路径更长。所以它更适合用在稳定模型、高吞吐、对延迟敏感的场景,而不是每一个通用组件都盲目引入。
已知类型集合优先用接口和类型断言
有些场景其实并不需要真正的“动态类型系统”,只是代码一开始为了省事,用了 interface{} 加反射兜底。只要参与处理的类型集合是可预期的,更合理的办法往往是定义接口,再用类型断言走主流程。
type Serializable interface {
    Serialize() []byte
}

func Process(obj interface{}) {
    // 优先使用类型断言,而不是反射
    if s, ok := obj.(Serializable); ok {
        data := s.Serialize() // 直接接口调用,无反射开销
        // 处理数据...
    } else {
        // 降级方案:使用反射
        // ...
    }
}
这种写法的价值在于,把反射从默认路径降级成补充路径。也就是说,绝大多数正常请求或数据处理都走接口分发,只有少数未覆盖类型才进入反射逻辑。这样既保留了弹性,也能让主干性能稳定下来。
实战示例:把序列化器做成缓存驱动
上面的几种策略,并不是彼此独立的。真正进入工程实现时,常见做法往往是把它们组合起来:类型信息缓存一次、字段访问走索引、同类对象复用元数据,必要时再进一步切到代码生成。
下面这个序列化器示例,就体现了“首次解析,后续复用”的基本思路:
type Serializer struct {
    cache sync.Map // 类型缓存
}

func (s *Serializer) Serialize(obj interface{}) ([]byte, error) {
    typ := reflect.TypeOf(obj)

    // 尝试从缓存获取类型信息
    if info, found := s.cache.Load(typ); found {
        return s.serializeWithInfo(obj, info.(*typeInfo))
    }

    // 首次访问,构建类型信息缓存
    info := s.buildTypeInfo(typ)
    s.cache.Store(typ, info)

    return s.serializeWithInfo(obj, info)
}
这个实现的重点不在于代码本身有多复杂,而在于职责拆分足够明确:
- 首次访问 时做完整类型分析。
- 后续访问 时直接复用
typeInfo。 - 序列化阶段 尽量少碰高成本的反射 API。
如果继续往下优化,这个 typeInfo 里通常还会存字段索引、标签配置、可导出字段列表,甚至预先整理好的转换函数。这样序列化流程就从“边跑边猜”变成“提前建表,运行期查表”。
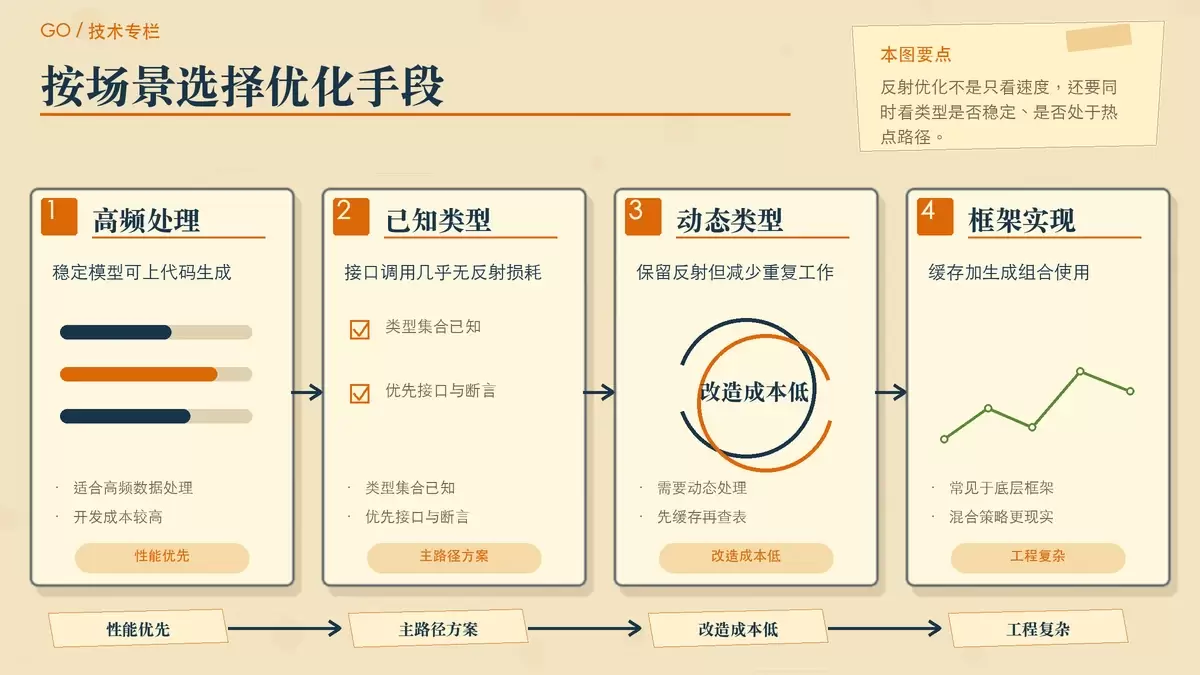
不同场景下,应该怎么选优化方案
反射优化没有一招通吃,关键是把性能目标和开发成本一起考虑。原文给出的场景建议可以整理成下面这张判断表:
| 场景 | 推荐方案 | 性能损耗 | 开发成本 |
|---|---|---|---|
| 高频数据处理 | 代码生成 | <1% | 高 |
| 已知类型集合操作 | 接口抽象 | 0% | 中 |
| 动态类型处理 | 缓存反射结果 | 10-20% | 低 |
| 框架底层实现 | 反射+缓存+代码生成混合 | 可接受 | 非常高 |
如果把这张表翻译成更直接的工程判断,大致可以归纳成三条:
- 类型稳定、调用频繁:优先考虑代码生成。
- 类型范围已知、希望保留扩展性:优先接口和类型断言。
- 必须做动态处理、又不想大改架构:先上缓存,再消除名称查找。
换句话说,真正需要反射的场景并没有那么多。很多时候,性能问题并不是“反射不可避免”,而是“本来能提前决定的事,被留到了运行时”。
落地时记住这几条判断原则
把整篇文章的经验收束起来,Go 反射优化可以归结为几条很实用的原则。
能缓存的,就不要重复计算
类型信息、字段索引、方法映射、标签解析结果,只要会重复使用,就值得缓存。对大多数反射型工具库来说,这通常是成本最低、收益最高的第一步。
能在编译期完成的,不要拖到运行时
如果模型结构明确、调用量又足够大,代码生成几乎总比运行时解析更划算。它牺牲的是开发便利,换来的是稳定吞吐和更低延迟。
能断言的,就别用反射兜一圈
接口和类型断言不仅性能更好,代码可读性通常也更高。反射更适合处理真正开放、不可预知的动态输入,而不是替代正常的接口设计。
别把反射放进热路径
循环体、请求主流程、批处理核心阶段,都是最应该警惕反射出现的位置。即便反射无法完全去掉,也应该尽量把它前移到初始化、注册或元数据构建阶段。
反射在 Go 里依然是很强的工具,但它更适合作为“必要时使用”的能力,而不是默认实现方式。优先考虑接口设计、泛型和代码生成,只有在确实需要动态行为时再引入反射,通常才是兼顾灵活性和性能的做法。















