



在 Go 项目里,反射常常同时扮演两种角色:一边支撑 JSON 序列化、ORM、依赖注入这类通用能力,一边又因为性能损耗让人警惕。真正需要解决的问题,不是“反射能不能用”,而是它究竟慢在哪、慢到什么程度,以及在不同压力下该用哪种优化手段。下面就从运行时开销、基准测试到缓存、减少分配、unsafe 和代码生成几条路径,拆开来看清这件事。
为什么 Go 反射会慢
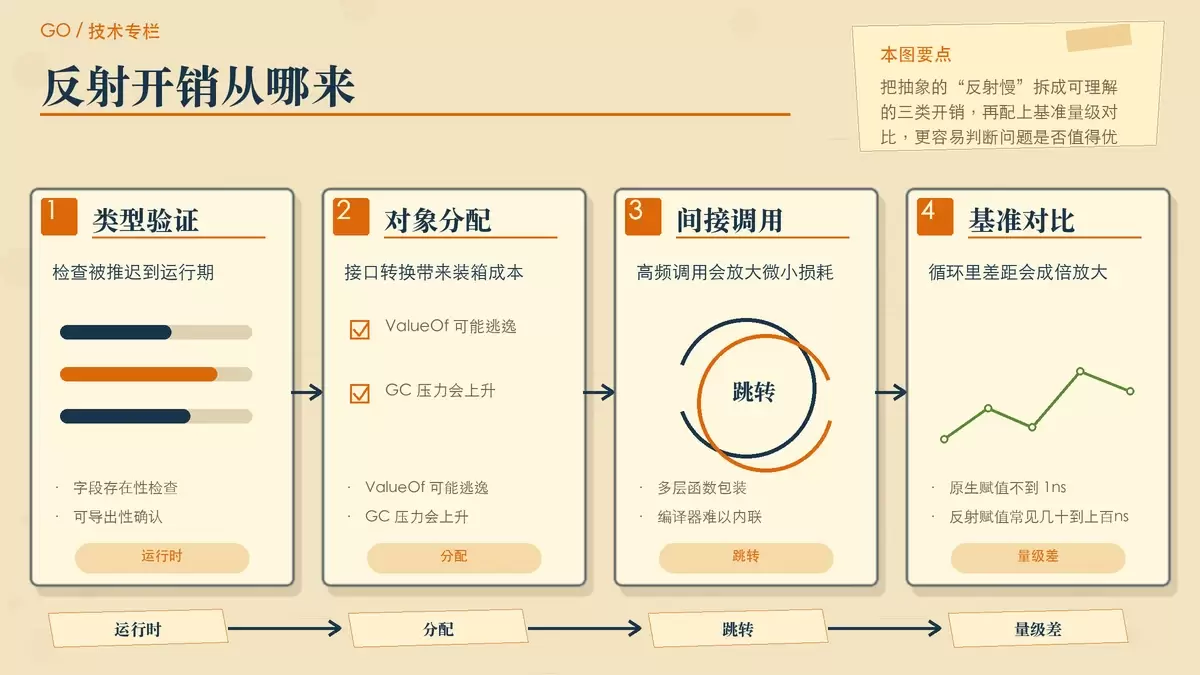
要谈优化,先得明确反射的成本到底来自哪里。使用 reflect 包时,很多本来能在编译期完成的工作,都会被推迟到运行期处理。
运行时类型检查更多
当你通过反射给字段赋值时,运行时需要额外确认几件事:目标变量的类型是否匹配、字段是否存在、字段是否可导出。这些检查在普通代码路径里大多由编译器提前完成,而反射必须在执行时动态判断,因此天然更慢。
接口转换和对象分配会增加负担
反射经常伴随 interface{} 转换。每次调用 reflect.ValueOf(x),如果 x 因此逃逸到堆上,就可能带来额外分配和 GC 压力。再加上 reflect.Value 相关的中间操作对象,频繁使用时开销会不断累积。
反射路径很难吃到编译器优化
通过反射读写字段或调用函数,通常要经过多层包装和跳转,编译器也无法像处理直接调用那样进行内联优化。单次差距看起来不大,但一旦放进高频循环,吞吐量损失会很明显。
基准测试里差距有多明显
看一个最直观的例子。假设有一个结构体,需要动态写入字段值:
type User struct {
    Name string
    Age  int
}

// 原生赋值
user.Name = "Alex"

// 反射赋值
v := reflect.ValueOf(&user).Elem()
v.FieldByName("Name").SetString("Alex")
在 Benchmark 里,原生赋值通常不到 1 纳秒,而类似这样的简单反射赋值,往往需要几十甚至上百纳秒。单次看似仍然很快,但如果这段逻辑出现在百万级数据处理循环里,差距就会被成倍放大,系统吞吐量也会明显下降。
这也是为什么很多框架会把反射限制在初始化阶段,或者只在低频路径里使用:不是因为反射完全不能接受,而是因为高频热路径对这种额外成本非常敏感。
先做缓存:最有效也最稳妥的优化
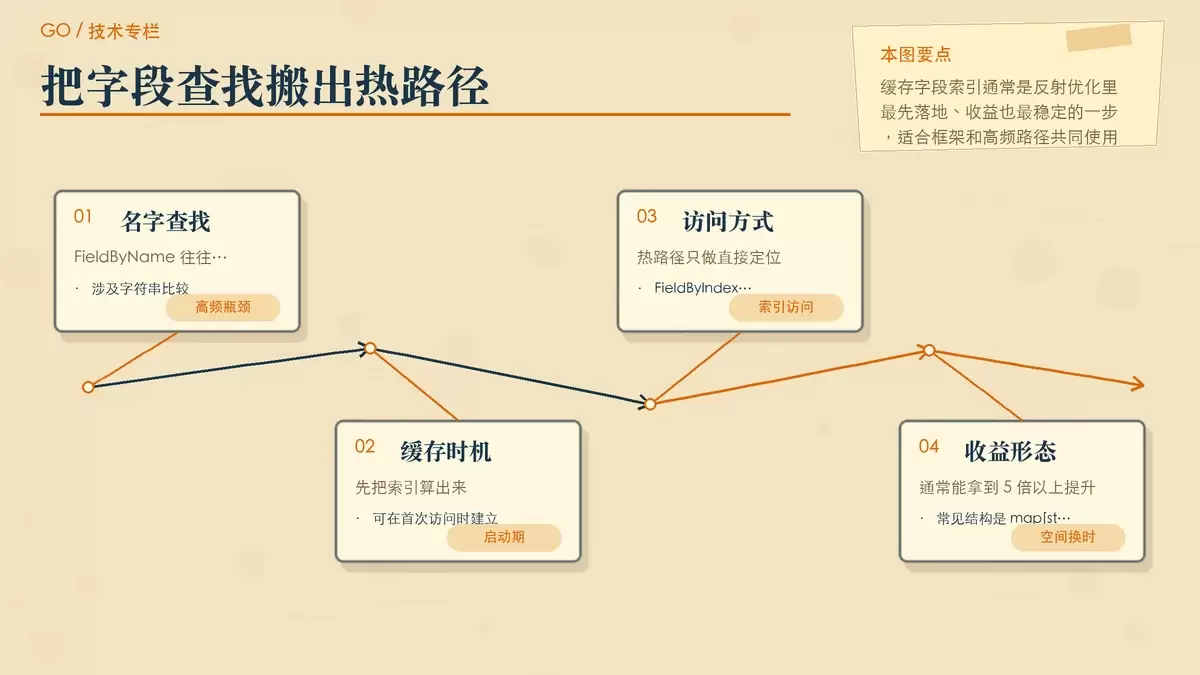
如果反射的主要损耗来自运行时查找,那么第一件该做的事通常就是缓存结果。尤其是 FieldByName,它往往是最值得优先处理的热点。
FieldByName 为什么贵
FieldByName 需要按照 Go 的可见性规则遍历结构体字段,必要时还要处理嵌套字段,并做字符串比较。结构体字段越多,查找越慢;如果这一步放在高频逻辑里重复执行,损耗会非常可观。
把字段索引提前算好
一种常见做法是在程序启动时,或者第一次访问时,把字段索引缓存下来,后续直接走索引访问:
// 提前提取并缓存字段索引(StructField.Index 是一个切片,代表嵌套深度)
var nameFieldIndex []int
if f, ok := reflect.TypeOf(User{}).FieldByName("Name"); ok {
    nameFieldIndex = f.Index
}

// 在高频逻辑中使用索引访问
if nameFieldIndex != nil {
    v := reflect.ValueOf(&user).Elem()
    // FieldByIndex 支持深层嵌套,Field 则用于单层索引
    v.FieldByIndex(nameFieldIndex).SetString("Alex")
}
这样做的意义在于,把昂贵的字符串匹配和字段遍历,转成了简单的索引定位。实际项目里,这类优化常常能带来 5 倍以上的性能提升。
适合框架和通用组件长期维护
在 ORM 或序列化框架中,维护一个 map[string][]int 来保存字段名到索引的映射,是很典型的“空间换时间”。它不会破坏代码可维护性,也比直接引入更激进的技巧更容易控制风险,因此通常是反射优化的第一选择。
减少分配:别把反射放进最热的循环里
除了查找字段,另一个经常被忽视的成本是对象分配和装箱。很多代码习惯在循环内部反复调用 reflect.ValueOf(),这往往会把本可避免的成本持续放大。
for i := 0; i < b.N; i++ {
    v := reflect.ValueOf(&user).Elem()
    // ... 操作 ...
}
把 reflect.ValueOf 挪到循环外
如果目标对象在循环中不会变化,优先把 reflect.ValueOf 提前提取到外层。这样至少可以避免每次迭代都重复做一次装箱和包装。
少用 Interface(),多走具体类型方法
v.Interface() 会再次触发接口装箱。在已知字段类型的情况下,尽量直接使用 SetInt、SetString、Int()、String() 这类具体方法,减少中间转换。
已知类型时,类型断言可能更划算
如果你已经知道目标的具体类型,那么适当配合类型断言,例如 v.Interface().(MyType),通常会比一直停留在纯反射路径里更高效。核心思路很简单:只在必须动态处理的那一小段代码里使用反射,剩下的部分尽量回到静态类型世界。
极限性能场景:unsafe 与代码生成怎么选
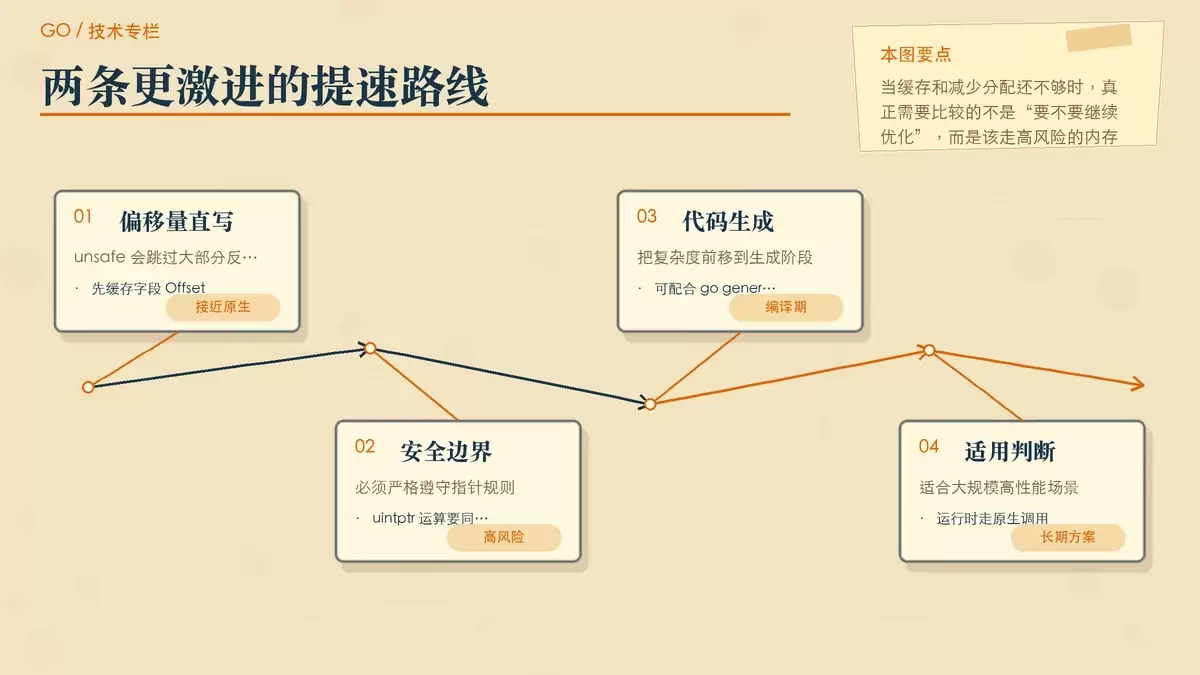
当缓存和减少分配仍然不够时,才需要考虑更激进的手段。这里通常有两条路:一条是 unsafe,另一条是直接放弃运行时反射,转向代码生成。
用 unsafe 预取偏移量,绕过反射调用
反射在底层其实也是先算出字段相对结构体起始地址的偏移量,再完成读写。既然如此,就可以在启动阶段先把偏移量算好并缓存,运行时直接通过指针运算访问内存:
// 1. 启动时缓存偏移量
var ageOffset uintptr = reflect.TypeOf(User{}).Field(1).Offset

// 2. 运行时使用指针直接读写
// 注意:必须在单行表达式中完成转换和运算,以防 GC 移动对象
ptr := unsafe.Pointer(uintptr(unsafe.Pointer(&user)) + ageOffset)
*(*int)(ptr) = 30

// 在现代 Go (1.17+) 中,推荐使用更语义化的方式:
// ptr := unsafe.Add(unsafe.Pointer(&user), ageOffset)
这种方式几乎跳过了反射带来的类型检查和函数调用,性能能接近原生赋值。但代价也很明确:你需要自己承担指针安全和可维护性的风险。
特别注意 Go 指针安全规则
这里最关键的一点,是遵守 Go 的指针安全约束。像文中的 uintptr 运算,必须在同一行表达式里完成,不能把中间的 uintptr 长时间保存到变量中再使用,否则垃圾回收器可能在期间移动对象,导致指针失效。能否严格保证这类细节,决定了 unsafe 是否适合进入生产代码。
更长期的方案:代码生成
如果你面对的是大规模、高性能、长期维护的业务,很多时候最值得投入的方案反而是“不用反射”。例如 Protobuf 序列化、复杂依赖注入或者批量字段映射场景,可以通过 go generate 配合 text/template 生成赋值、校验、转换代码。
这样做相当于把复杂度转移到编译阶段,运行时执行的是普通的原生调用,既保留类型安全,也能拿到接近手写代码的性能。对于需要长期稳定演进的系统,这通常比在核心链路里叠加越来越多的反射优化更可控。
实际项目里怎么选,才算用对反射
反射不是性能问题的原罪,真正的问题通常是把它放错了位置。更实用的判断方式可以分成几层:
- 简单逻辑,优先直接写原生代码。
- 需要灵活性、通用性时,可以先用反射快速实现。
- 一旦压测或 Benchmark 证明反射成了瓶颈,先从字段索引缓存和减少分配入手。
- 只有在极端性能要求下,并且团队能稳妥驾驭风险时,再考虑
unsafe。 - 如果这是一个长期演进、对性能持续敏感的基础能力,代码生成通常比硬扛反射更合适。
归根到底,Go 的思路一直很明确:简单优先,按需加速。反射值得用,但更值得被放在合适的位置。能用常规手段解决的问题,就别急着引入高风险技巧;真正要做性能优化时,也最好始终用 Benchmark 和实际吞吐数据来验证,而不是只凭经验判断。















