


Python 3 编码机制详解:从默认编码到 UTF-8 转换

本文详细解析 Python 3 中的编码机制,通过 IDLE 环境下的代码实例,演示如何查看系统默认编码、使用 encode 方法将字符串转换为字节,以及通过 decode 方法还原字符串。重点阐述 UTF-8 编码对中英文混合内容的处理优势,并说明在包含中文注释的 Python 文件中添加编码声明的必要性,帮助开发者理解并解决常见的编码错误。
Python 3 编码机制概述
Python 3 中的编码处理是开发过程中常见的问题,理解其机制对于避免乱码和编码错误至关重要。
查看系统默认编码
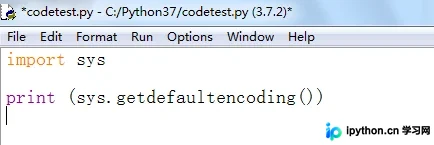
首先,打开 Python 开发工具 IDLE,新建一个名为 'codetest.py' 的文件,并在其中编写以下代码以进行后续测试:
import sys

print (sys.getdefaultencoding())
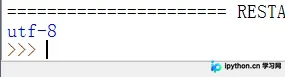
按下 F5 键运行程序,系统将打印出当前环境的默认编码方式,这有助于我们了解基础设置。
字符串编码为字节
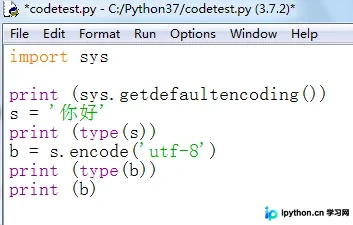
接下来,我们需要演示如何将字符串(str)格式编码为字节(bytes)格式,修改代码以包含字符串编码逻辑:
import sys

print (sys.getdefaultencoding())

s = '你好'

print (type(s))

b = s.encode('utf-8')

print (type(b))

print (b)
在代码中,语句 b = s.encode('utf-8') 与 b = s.encode() 效果等同,这是因为系统默认的编码方式即为 utf-8。
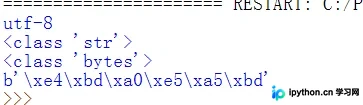
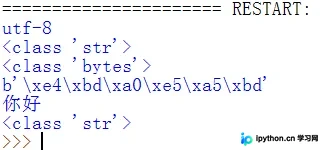
再次按下 F5 运行程序,打印结果如下所示。由于 ASCII 码无法表示所有汉字,中文必须使用 utf-8 编码。此处暂不介绍使用较少的 gbk 编码,主要说明 utf-8 使用 3 个字节表示一个汉字,而 ASCII 仅使用 1 个字节表示英文字母或字符。
字节解码为字符串
解码则是将字节(bytes)重新转换回字符串(str)的过程,我们需要修改代码以包含解码操作:
import sys


print (sys.getdefaultencoding())

s = '你好'

print (type(s))

b = s.encode('utf-8')

print (type(b))

print (b)

se = b.decode('utf-8')

print (se)

print (type(se))
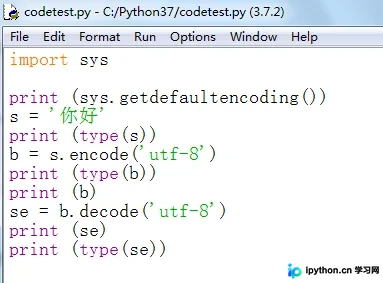
按下 F5 运行程序,打印内容如下图所示,展示了 bytes 类型成功转回 str 类型的结果。
UTF-8 兼容性与文件声明
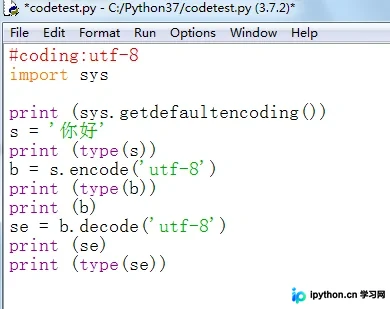
utf-8 编码兼容 ascii,因此在既有中文又有英文的情况下使用 encode('utf-8'),英文字符仍占 1 个字节,而中文字符占 3 个字节。此外,当 Python 文件头部注释包含中文时,必须在文件顶部添加编码声明以确保正确解析。
#coding:utf-8
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















