


详解程序意外中断自动重启shell脚本(以Python为例)

发布时间:2026-10-13 |
5人浏览过
本文介绍如何利用Shell脚本监控Python程序,当程序意外中断时实现自动重启。通过while循环持续执行Python脚本,并结合nohup命令实现后台运行。此外,针对爬虫场景,提供了基于文件管理的断点续爬代码示例,确保中断后能从上次位置继续抓取数据。
Shell脚本监控Python自动重启原理
在服务器运维或后台任务处理中,我们常需让Python脚本持续运行以监控系统或执行特定逻辑。然而,除代码本身Bug外,脚本常因内存溢出、外部依赖异常等原因意外挂起。为避免人工频繁介入重启,可通过编写Shell监控脚本,实现程序中断后的自动恢复机制。
以下以控制Python脚本自动重启的Shell脚本为例进行说明。
创建与配置Shell脚本
cd Desktop
vim run.sh #新建名为run的shell脚本
首先创建名为run的Python脚本,并编写对应的Shell监控脚本。
核心重启逻辑代码
#!/bin/bash
while [ 1 ];do
 python run.py
done
权限设置与脚本执行
chmod 777 run.sh #设置shell脚本权限
./run.sh   #运行shell脚本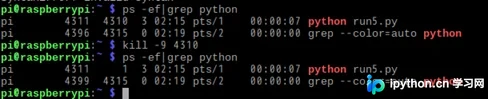
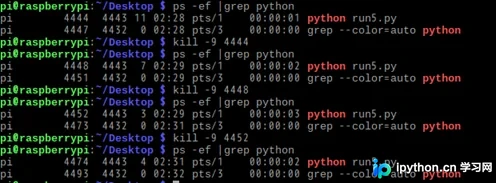
当Python脚本因被kill或异常退出时,Shell脚本中的循环语句会立即检测到进程结束,并再次启动Python进程,从而实现自动重启。
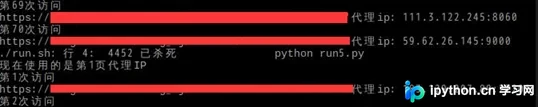
测试确认功能正常后,可将脚本置于后台运行。关于后台运行的具体原理,可参考相关技术文档。
后台运行配置
nohup ./run5.py &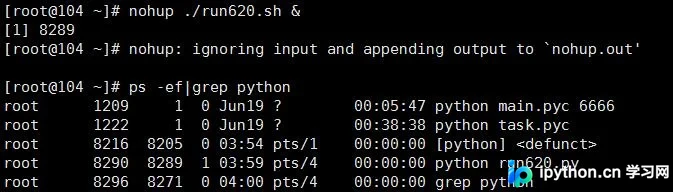
爬虫项目断点续爬实现
在爬虫项目中,程序常因网站验证、IP封禁等复杂网络状况中断。此时,已抓取的数据不应丢失,再次启动时应忽略已处理数据。因此,需在爬虫逻辑中实现断点续传功能,使程序能从中断处继续运行。相关实现代码参考自匡虐博客。
URL管理器与断点记录代码
import os
class UrlManager(object):
 def __init__(self):						#建立两个数组的文件
  with open('new_urls.txt','r+') as new_urls:
   self.new_urls = new_urls.read()
  with open('old_urls.txt','r+') as old_urls:
   self.old_urls = old_urls.read()

 def add_new_url(self, url): 				 #添加url到new_ulrs文件中
  if url is None:
   return
  if url not in self.new_urls and url not in self.old_urls:
   with open('new_urls.txt', 'a') as new_urls:
    new_urls.write(url)
  else:
   print('url had done')

 def add_new_urls(self, urls):				#添加多个url到new_ulrs文件中
  # if urls is None or (len(url) == 0 for url in urls):
  if urls is None:
   print('url is none')
   return
  for url in urls:
   if urls is None:
    print('url is none')
    return
   else:
    self.add_new_url(url)

 def has_new_url(self):
  return len(self.new_urls) != 0

 def get_new_url(self):
  new_url = get_last_line('new_urls.txt') 	#读取new_urls文件中最后一个url
  del_last_url('new_urls.txt',new_url)		#删除new_urls文件中最后一个url
  add_old_urls('old_urls.txt',new_url)		#将读取出来的url添加入old_urls数组中
  return new_url

	def get_last_line(inputfile):
	 filesize = os.path.getsize(inputfile)
	 blocksize = 1024
	 dat_file = open(inputfile, 'rb')

	 last_line = b""
	 lines = []
	 if filesize > blocksize:
	  maxseekpoint = (filesize // blocksize) # 这里的除法取的是floor
	  maxseekpoint -= 1
	  dat_file.seek(maxseekpoint * blocksize)
	  lines = dat_file.readlines()
	  while ((len(lines) < 2) | ((len(lines) >= 2) & (lines[1] == b'\r\n'))): # 因为在Windows下,所以是b'\r\n'
	   # 如果列表长度小于2,或者虽然长度大于等于2,但第二个元素却还是空行
	   # 如果跳出循环,那么lines长度大于等于2,且第二个元素肯定是完整的行
	   maxseekpoint -= 1
	   dat_file.seek(maxseekpoint * blocksize)
	   lines = dat_file.readlines()
	 elif filesize: # 文件大小不为空
	  dat_file.seek(0, 0)
	  lines = dat_file.readlines()
	 if lines: # 列表不为空
	  for i in range(len(lines) - 1, -1, -1):
	   last_line = lines[i].strip()
	   if (last_line != b''):
	    break # 已经找到最后一个不是空行的
	 dat_file.close()
	 return last_line

	def del_last_url(fname,part):
	 with open(fname,'rb+') as f:
	  a = f.read()
	 a = a.replace(part,b'')
	 with open(fname,'wb+') as f:
	  f.write(a)

	def add_old_urls(fname,new_url):
	 line = new_url + b'\r'
	 with open(fname,'ab') as f:
	  f.write(line)
以上即为Python脚本自动重启及断点续爬的核心实现方案,希望能为相关技术学习提供协助,欢迎继续支持本站内容。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















