


Python使用Pandas将大数据CSV文件等分及处理中文路径的方法

发布时间:2026-10-13 |
6人浏览过
本文介绍如何使用Python的Pandas库将包含亿级数据的CSV文件等分为10份,并采用规则命名。针对文件路径含中文导致内存占用翻倍的问题,提供了通过文件对象读取的替代方案,同时建议优先修改路径为英文以优化性能。
Python等分大数据CSV文件的方法
针对一份包含超过一亿行数据的CSV文件,需要将其等分为10个文件。具体的Python实现代码如下所示:
import pandas as pd
data = pd.read_csv('C:\\Users\\PycharmProjects\\SplitData\\data\\UserBehavior.csv') # 路径则根据个人存放项目文件的习惯
num = 0
for i in range(1, 11):
start = num
num = num + int(data.shape[0] / 10)
file = data.iloc[start:num,]
file.to_csv("C:\\Users\\PycharmProjects\\SplitData\\newData\\" + str(i) + "_data.csv", index=False) # index=False是不想切分后的文件出现序号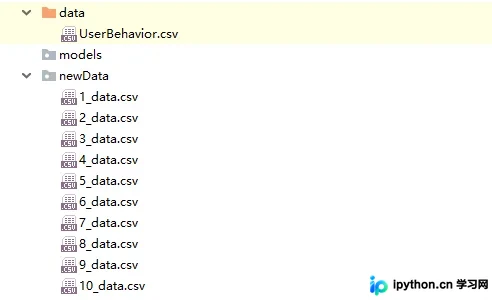
处理中文路径的替代方案
需要特别注意的是,如果文件路径中包含了中文字符,直接读取可能会导致问题,此时应改用以下代码处理方式:
import pandas as pd
f = open('C:\\Users\\PycharmProjects\\数据切分\\data\\UserBehavior.csv')
data = pd.read_csv(f)
num = 0
for i in range(1, 11):
start = num
num = num + int(data.shape[0] / 10)
file = data.iloc[start:num,]
file.to_csv("C:\\Users\\PycharmProjects\\SplitData\\newData\\" + str(i) + "_data.csv", index=False)
内存占用分析与路径建议
然而,通过打开文件对象再传入Pandas读取的方式会增加内存负担,因为涉及两次赋值操作,导致内存占用大致翻倍。因此,这种方法并不推荐,最佳实践仍是将文件路径修改为纯英文路径。
总结
总结
上述内容介绍了利用Python进行数据等分切分及规则命名的具体实现。希望这些示例代码能对大家有所帮助,如有任何疑问,欢迎留言交流,我们将及时回复。感谢大家对本站的支持!如果您觉得本文对您有参考价值,欢迎转载,请注明出处,谢谢。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















