


Python3从零搭建语音对话机器人:百度AI与图灵机器人实战

本文详细介绍如何使用Python3、百度AI开放平台语音识别API及图灵机器人API,从零搭建一个实时语音对话机器人。教程涵盖环境配置、录音模块实现、STT文字转换、图灵智能回复及TTS语音合成全流程,提供完整代码与常见问题解答,帮助开发者快速构建具备中文语义交互能力的本地语音助手。
语音对话机器人开发背景与选型
01-初心缘由
近期深入研究了语音识别领域,查阅大量资料梳理了其发展历程。当前主流的语音识别算法主要基于深度学习神经网络,其中循环神经网络(RNN)发挥了关键作用,使得语音识别技术真正达到了商用级别。受此启发,我尝试从GitHub下载并复现了MASR和ASRT两个流行开源项目,但发现实际识别效果未达预期。若从零开始训练专属语言模型,将耗费极其庞大的时间成本。
因此,我转变思路,决定利用现有的开源语音识别SDK来测试其实际效果。经对比百度和科大讯飞,通过搜索发现百度AI开放平台提供了完善的支持。查阅技术文档后,确认百度对Python的支持极为友好,而科大讯飞当时未提供Python接口,故最终选定百度作为语音识别服务提供方。
尽管百度平台存在诸多争议,但其在AI领域的投入与开放态度值得肯定。百度AI开放平台为开发者提供了丰富的AI服务,注册即可使用。百度大脑AI开放平台地址:http://ai.baidu.com/(注:本文纯属技术分享,未收取任何广告费用)。
实际体验表明,百度语音识别的准确率令人印象深刻,远超GitHub上的开源项目。在浏览CSDN博客时,我发现结合百度语音识别API与图灵机器人API可实现实时语音对话机器人,这激发了我的创作热情,遂决定搭建个人语音对话机器人。目前功能已实现,特此分享完整构建过程及避坑指南,助大家快速搭建属于自己的语音对话机器人。接下来开始实操!
开发环境准备与API配置
02-准备工作
(1)准备python开发环境
需安装的Python依赖包包括:speech_recognition(语音识别库)、pyaudio(录音接口库)、wave(音频文件处理库)、pyttsx3(文本转语音库)、json(JSON解析库)、requests(HTTP请求库)、baidu_aip(百度语音识别SDK)。
(2)准备百度API
访问百度AI开放平台语音识别页面:https://ai.baidu.com/tech/speech/asr 。若无账号请自行注册,目前提供免费试用额度。
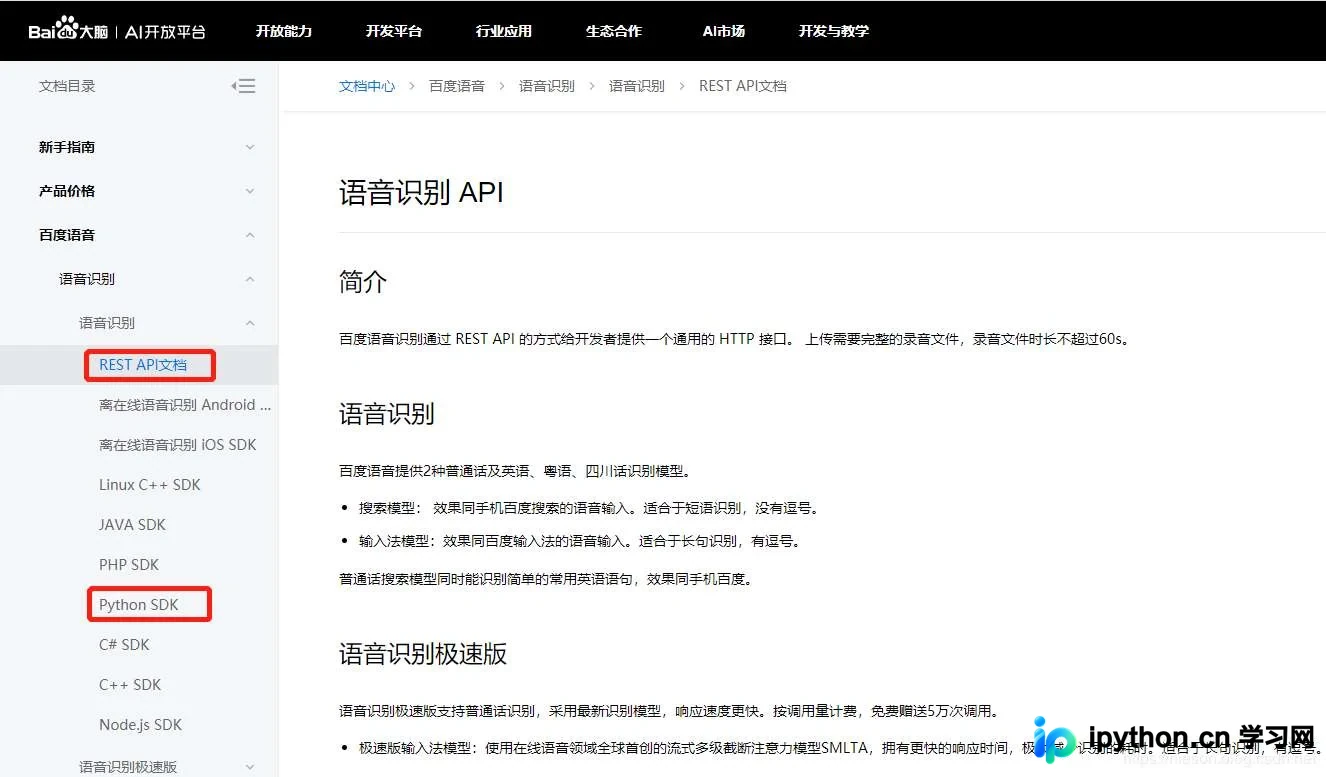
点击“技术文档”,重点阅读API文档与Python SDK部分,掌握在Python中调用API的具体方法。
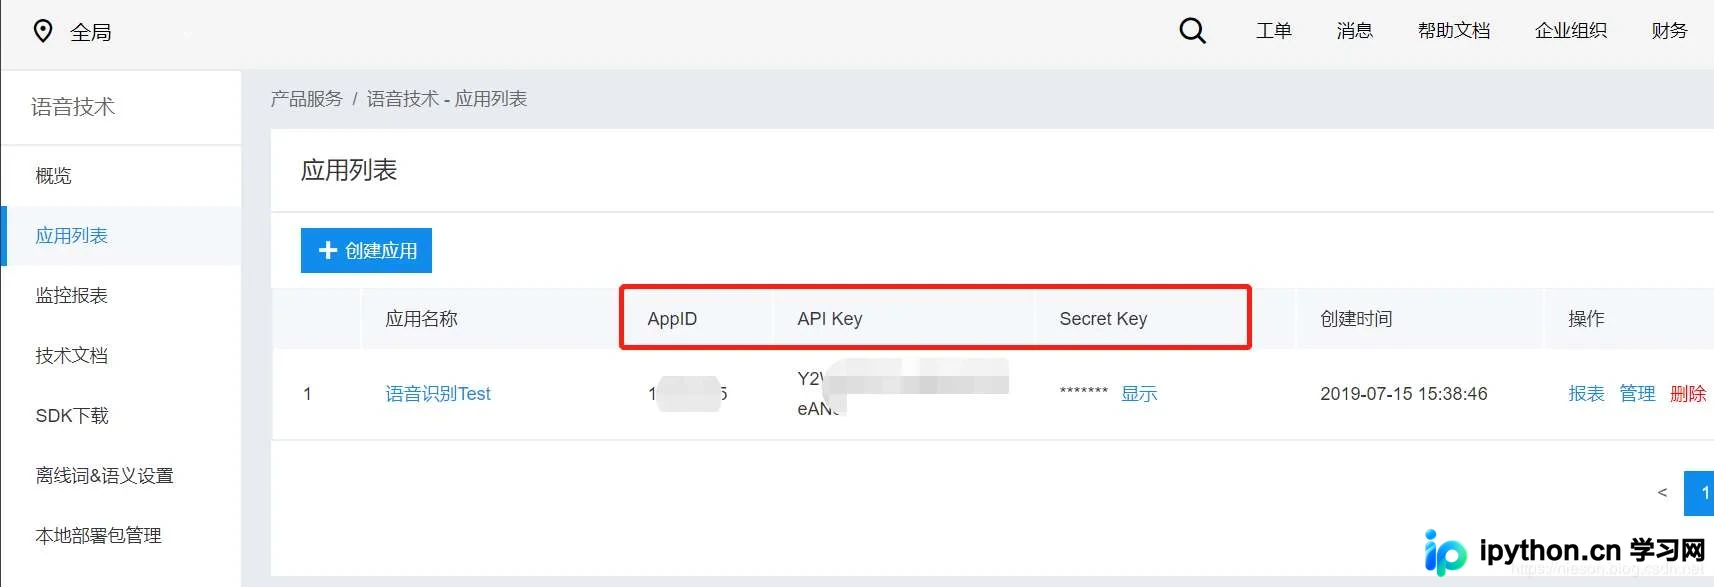
点击“立即使用”,进入服务管理界面并创建应用。务必记录关键的App ID、API Key和Secret Key,后续代码调用需使用这些凭证。
(3)准备图灵机器人:
图灵机器人具备强大的中文语义分析能力,能准确理解中文含义并做出回应,被誉为最擅长处理中文的机器人大脑,可为软硬件产品赋予自然流畅的人机对话能力。作为中文语境下智能度最高的“机器人大脑”,图灵机器人是全球先进的机器人中文语言认知与计算平台,其中文语义理解准确率已达90%,提供中文语义分析、自然语言对话、深度问答等AI技术服务。——摘自百科(看来又与百度有些关联)。
简而言之,需前往图灵机器人官网http://www.turingapi.com/注册并构建专属机器人。该机器人将用于接收经语音转文字后的内容,并返回智能回复,最后通过TTS技术将回复转换为语音输出。
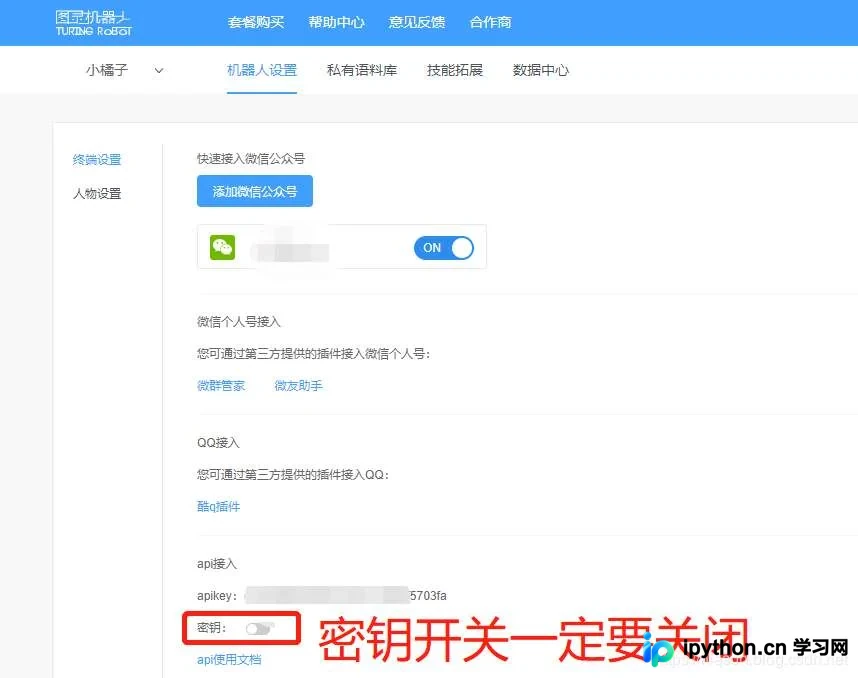
注册后创建机器人,并在机器人设置的终端设置中获取apikey(此Key至关重要)。务必关闭密钥开关,否则后续调用API时会报错3001,导致无法调用图灵机器人(此处为常见坑点,已解决)。
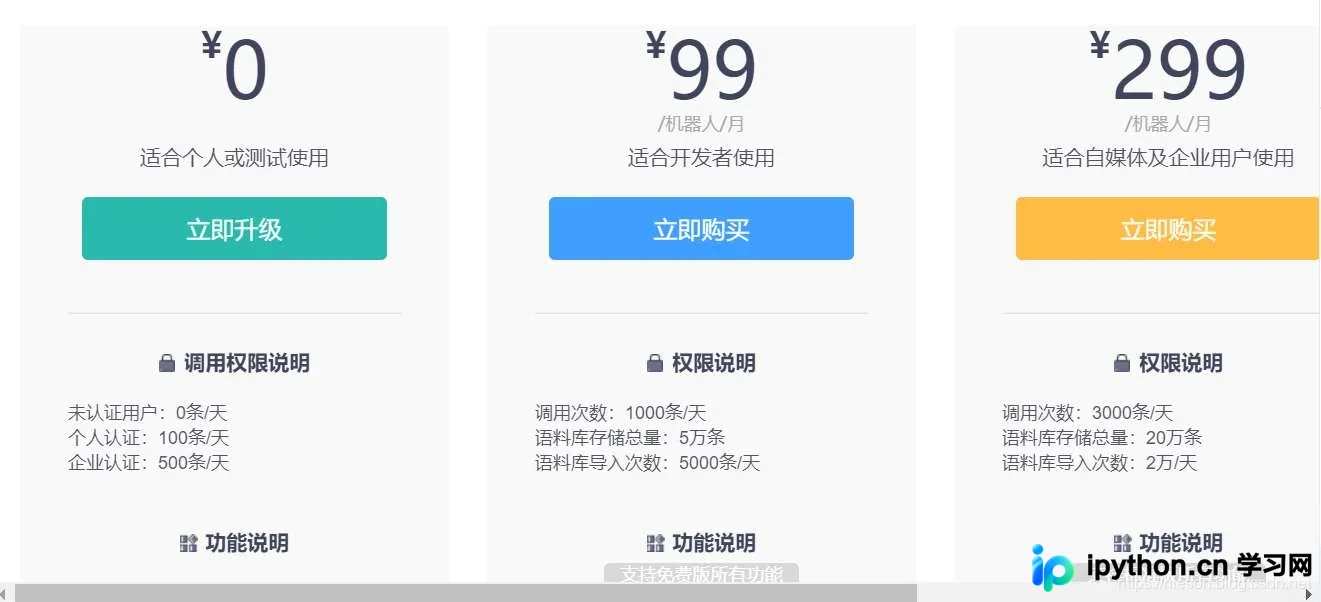
图灵机器人未通过身份认证时无法调用,会提示“请求次数超限制”。个人身份认证通过后,免费版每日可调用100次。100次显然不足,如需更多服务需购买会员,月费分别为99元和299元,具体方案见下图。个人娱乐使用免费版即可,开发测试可选99元套餐,若用于商业产品则需企业采购,普通开发者无需考虑高端套餐。
语音机器人核心构建思路
03-语音机器人的搭建思路
1、明确目标:实现纯语音对话聊天,无需文字输入。要求实时说话、实时回复,真正实现语音交互。
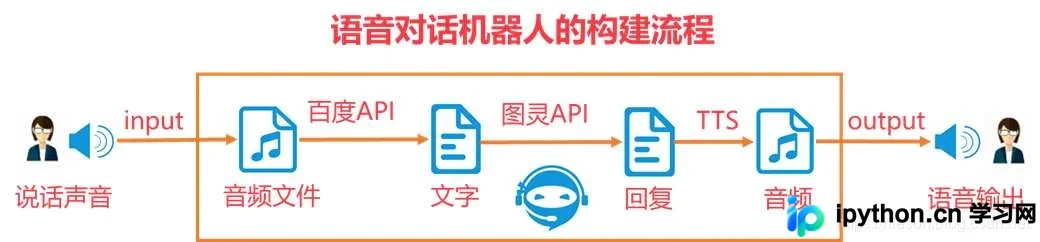
2、实现流程:用户说话,系统录音并保存为语音文件;调用百度API进行语音转文本(STT);将文本输入图灵机器人API获取回复;最后将回复文本通过TTS转换为语音输出。流程看似复杂,但逻辑清晰即可实现。
3、具体构建流程涉及多次API调用,请勿感到困惑,保持思路清晰是成功的关键。
录音模块实现与音频处理
04-语音生成音频文件
生成语音文件需进行录音,保存格式通常为wav,其他格式如pcm也支持,但不建议mp3,因需多次转换。【百度服务端会将非pcm格式转为pcm,故使用wav会增加额外转换耗时,但Windows自带播放器无法识别pcm,因此仍偏好使用wav格式】
第一种录音方式:使用speech_recognition包进行录音,效果较好且代码量少。
import speech_recognition as sr

# Use SpeechRecognition to record 使用语音识别包录制音频
def my_record(rate=16000):
  r = sr.Recognizer()
  with sr.Microphone(sample_rate=rate) as source:
    print("please say something")
    audio = r.listen(source)

  with open("voices/myvoices.wav", "wb") as f:
    f.write(audio.get_wav_data())
  print("录音完成!")

my_record()
第二种录音方式:使用wave和pyaudio包进行录音,可通过pip install直接安装。
import wave
from pyaudio import PyAudio, paInt16

framerate = 16000 # 采样率
num_samples = 2000 # 采样点
channels = 1 # 声道
sampwidth = 2 # 采样宽度2bytes
FILEPATH = 'voices/myvoices.wav'


def save_wave_file(filepath, data):
  wf = wave.open(filepath, 'wb')
  wf.setnchannels(channels)
  wf.setsampwidth(sampwidth)
  wf.setframerate(framerate)
  wf.writeframes(b''.join(data))
  wf.close()


#录音
def my_record():
  pa = PyAudio()
  #打开一个新的音频stream
  stream = pa.open(format=paInt16, channels=channels,
           rate=framerate, input=True, frames_per_buffer=num_samples)
  my_buf = [] #存放录音数据

  t = time.time()
  print('正在录音...')

  while time.time() < t + 10: # 设置录音时间(秒)
  	#循环read,每次read 2000frames
    string_audio_data = stream.read(num_samples)
    my_buf.append(string_audio_data)
  print('录音结束.')
  save_wave_file(FILEPATH, my_buf)
  stream.close()
语音转文字与智能对话集成
05-音频文件转文字STT
已获取音频文件后,需将其转化为文字。此处调用百度语音识别API接口,需安装该接口包,导入模块:pip install baidu_aip。导入所需模块名,将音频文件发送出去,即可返回文字结果。
# 音频文件转文字:采用百度的语音识别python-SDK
# 百度语音识别API配置参数
from aip import AipSpeech

APP_ID = 'your app_id'
API_KEY = 'your api_key'
SECRET_KEY = 'your secret_key'
client = AipSpeech(APP_ID, API_KEY, SECRET_KEY)
path = 'voices/myvoices.wav'


# 将语音转文本STT
def listen():
  # 读取录音文件
  with open(path, 'rb') as fp:
    voices = fp.read()
  try:
    # 参数dev_pid:1536普通话(支持简单的英文识别)、1537普通话(纯中文识别)、1737英语、1637粤语、1837四川话、1936普通话远场
    result = client.asr(voices, 'wav', 16000, {'dev_pid': 1537, })
    # result = CLIENT.asr(get_file_content(path), 'wav', 16000, {'lan': 'zh', })
    # print(result)
    # print(result['result'][0])
    # print(result)
    result_text = result["result"][0]
    print("you said: " + result_text)
    return result_text
  except KeyError:
    print("KeyError")
06-与图灵机器人对话
上一步已将声音转化为文字,接下来调用图灵机器人API接口进行自动应答。图灵机器人对中文识别准确率高达90%,是中文语境下智能度最高的机器人。网上Python使用图灵机器人API的博客多为1.0版本,本文介绍Python中使用图灵机器人API v2.0的方法,1.0版本调用方式已失效。
代码如下(需导入requests、json模块):
# 与机器人对话:调用的是图灵机器人
import requests
import json

# 图灵机器人的API_KEY、API_URL
turing_api_key = "your turing_api_key"
api_url = "http://openapi.tuling123.com/openapi/api/v2" # 图灵机器人api网址
headers = {'Content-Type': 'application/json;charset=UTF-8'}


# 图灵机器人回复
def Turing(text_words=""):
  req = {
    "reqType": 0,
    "perception": {
      "inputText": {
        "text": text_words
      },

      "selfInfo": {
        "location": {
          "city": "北京",
          "province": "北京",
          "street": "车公庄西大街"
        }
      }
    },
    "userInfo": {
      "apiKey": turing_api_key, # 你的图灵机器人apiKey
      "userId": "Nieson" # 用户唯一标识(随便填, 非密钥)
    }
  }

  req["perception"]["inputText"]["text"] = text_words
  response = requests.request("post", api_url, json=req, headers=headers)
  response_dict = json.loads(response.text)

  result = response_dict["results"][0]["values"]["text"]
  print("AI Robot said: " + result)
  return result
文字转语音输出与完整代码
07-文字转语音
获取图灵机器人回复后,需将结果转化为语音输出,实现语音交互。在Python中如何将文字转为语音并输出?此处需使用pyttsx3模块,它负责将文字转换为语音。
import pyttsx3

# 初始化语音
engine = pyttsx3.init() # 初始化语音库
# 设置语速
rate = engine.getProperty('rate')
engine.setProperty('rate', rate-50)
# 输出语音
engine.say("你好,很高兴认识你!") # 合成语音
engine.runAndWait()
使用Python编程的优势之一是音频输出方式多样,下面提供一种更简便的音频输出方式:
import win32com.client

speaker = win32com.client.Dispatch("SAPI.SpVoice")
speaker.Speak("我是语音助手,小灵!")
至此,语音机器人的所有元素已准备妥当,接下来进行组装!
08-语音对话机器人的完整代码
经优化,代码已精简至100行左右。按照步骤操作,即可快速复现并构建你的语音机器人!
# -*- coding: utf-8 -*-#
# -------------------------------
# Name:SpeechRobot
# Author:Nieson
# Date:2019/7/19 16:31
# 用python3实现自己的语音对话机器人
# -------------------------------

from aip import AipSpeech
import requests
import json
import speech_recognition as sr
import win32com.client

# 初始化语音
speaker = win32com.client.Dispatch("SAPI.SpVoice")


# 1、语音生成音频文件,录音并以当前时间戳保存到voices文件中
# Use SpeechRecognition to record 使用语音识别录制
def my_record(rate=16000):
  r = sr.Recognizer()
  with sr.Microphone(sample_rate=rate) as source:
    print("please say something")
    audio = r.listen(source)

  with open("voices/myvoices.wav", "wb") as f:
    f.write(audio.get_wav_data())


# 2、音频文件转文字:采用百度的语音识别python-SDK
# 导入我们需要的模块名,然后将音频文件发送给出去,返回文字。
# 百度语音识别API配置参数
APP_ID = 'your app_id'
API_KEY = 'your api_key'
SECRET_KEY = 'your secret_key'
client = AipSpeech(APP_ID, API_KEY, SECRET_KEY)
path = 'voices/myvoices.wav'


# 将语音转文本STT
def listen():
  # 读取录音文件
  with open(path, 'rb') as fp:
    voices = fp.read()
  try:
    # 参数dev_pid:1536普通话(支持简单的英文识别)、1537普通话(纯中文识别)、1737英语、1637粤语、1837四川话、1936普通话远场
    result = client.asr(voices, 'wav', 16000, {'dev_pid': 1537, })
    # result = CLIENT.asr(get_file_content(path), 'wav', 16000, {'lan': 'zh', })
    # print(result)
    # print(result['result'][0])
    # print(result)
    result_text = result["result"][0]
    print("you said: " + result_text)
    return result_text
  except KeyError:
    print("KeyError")
    speaker.Speak("我没有听清楚,请再说一遍...")


# 3、与机器人对话:调用的是图灵机器人
# 图灵机器人的API_KEY、API_URL
turing_api_key = "your turing_api_key"
api_url = "http://openapi.tuling123.com/openapi/api/v2" # 图灵机器人api网址
headers = {'Content-Type': 'application/json;charset=UTF-8'}


# 图灵机器人回复
def Turing(text_words=""):
  req = {
    "reqType": 0,
    "perception": {
      "inputText": {
        "text": text_words
      },

      "selfInfo": {
        "location": {
          "city": "北京",
          "province": "北京",
          "street": "车公庄"
        }
      }
    },
    "userInfo": {
      "apiKey": turing_api_key, # 你的图灵机器人apiKey
      "userId": "Nieson" # 用户唯一标识(随便填, 非密钥)
    }
  }

  req["perception"]["inputText"]["text"] = text_words
  response = requests.request("post", api_url, json=req, headers=headers)
  response_dict = json.loads(response.text)

  result = response_dict["results"][0]["values"]["text"]
  print("AI Robot said: " + result)
  return result


# 语音合成,输出机器人的回答
while True:
  my_record()
  request = listen()
  response = Turing(request)
  speaker.Speak(response)
机器人功能扩展与常见问题解答
09-结束语
至此,我们构建了一个完整的语音对话机器人。它可在你无聊、寂寞、有压力或想开心时陪伴左右,哄你开心!这个机器人非常聪明,你可千万不要被她调戏了!
此外,可在图灵机器人官网进行人物设置,设定姓名、年龄和星座。我的机器人名为小橘子,具备多种技能:闲聊、数字计算、中英互译、讲故事、笑话、脑筋急转弯、歇后语、绕口令、顺口溜、成语接龙、天气和日期查询等功能,相当强大!若开通
付费版本将拥有更多功能,如训练自己的语料库。目前免费版仅支持每日100次调用,确实不够用!
附上我与小橘子的聊天视频,有心者可为其制作前端页面!
优酷视频:https://v.youku.com/v_show/id_XNDI3OTYyMTgwNA==.html?spm=a2h3j.8428770.3416059.4
10-有问必答
博客发布两天多,阅读量已突破5000,获得众多博友关注、点赞和评论,说明大家对语音对话机器人的热情极高,正积极搭建自己的机器人。预计百度和图灵机器人近期API调用量将激增,我在考虑是否收取推广费(哈哈,玩笑而已)!注册调用百度AI开放平台API后,两天内会有客服致电体验问题,大家看到标记为诈骗电话的北京号码即可(哈哈)。图灵机器人公司则通过会员收费模式盈利,就看你能否捂紧口袋了!
第10模块“有问必答”旨在解答复现过程中可能遇到的问题。根据大家提问,针对性解答常见问题,也欢迎博友积极回复,毕竟博主精力有限,还需投入AI能力研究(或许也是懒)。刚好十个模块凑齐十全十美,处女座看着也舒心!闲话少叙,进入正题:
(1)问:我直接执行你全部代码的时候为什么跑不通呢?
答:首先强调,复现代码时,务必将百度和图灵机器人的api_id、api_key等替换为自己的凭证!另外,图灵机器人必须通过身份验证后才能调用!
(2)问:我在运行之后输出please say something,然后我说了话,之后隔一段时间才输出KeyError,AI Robot said: 请求次数超限制!这是什么原因?
答:原因有二:一是在05-音频文件转文字STT中,为避免录音文件问题(如不带耳机对着笔记本说话时环境嘈杂导致录音质量不佳,或长时间不说话),会报KeyError错误;二是图灵机器人若注册后未进行身份认证或认证未通过,调用次数为0次,即不会收到回复,从而提示“请求次数超限制”。通过认证后,目前每日可调用100次,聊天100次后也会出现“请求次数超限制”。
(3)问:Mac电脑上没有win32com怎么办啊?
答:若win32com不可用,可尝试安装pyttsx3包,使用前文提到的第一种语音输出方式。为保持代码整洁,完整代码中未包含第一种方式(其实已写,博客发布时删除了,别问为什么,为了整洁好看,lol!)。
(4)问:为什么我的with open那里说文件找不到?
答:因为所有录音文件(如myvoices.wav)均存放在voices目录下,请务必创建自己的voices文件夹目录。
(5)问:不会python,有没有Java版本?
答:看完Python版本后,可尝试用Java复现。既然你会Java,百度API也支持Java调用,请查阅官网文档!
(6)问:安装包出现问题,主要是from aip import AipSpeech、import speech_recognition as sr中的aip、speech_recognition包为啥安装不成功?
答:这两个包较特殊,import时名称为aip和speech_recognition,但install安装时名称分别为baidu-aip和SpeechRecognition,按此名称安装即可成功!
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















