



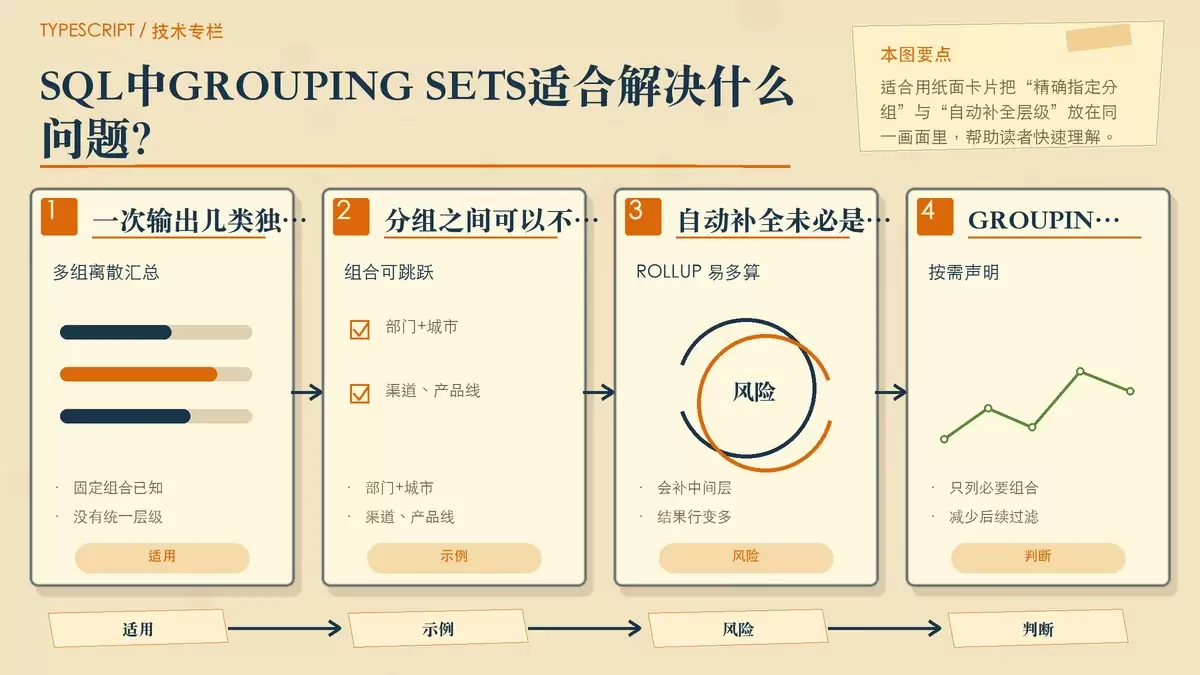
很多团队第一次接触 GROUPING SETS,都会把它当成 ROLLUP 或 CUBE 的替代品。其实它更适合另一类问题:你需要一次查出几组固定汇总结果,但这些分组维度之间并不存在严格的层级关系。判断它该不该用,关键看三点:分组组合是否离散、数据库是否支持、以及你能不能正确处理结果中的占位 NULL。
什么时候该用 GROUPING SETS
GROUPING SETS 的核心价值,是把多个不连续的分组粒度写死在一条查询里,避免数据库自动补出你并不需要的中间层。
典型场景是业务同时要看几类汇总:
- 按部门 + 城市汇总
- 只按渠道汇总
- 只按产品线汇总
这时真正需要的分组组合是:
((dept, city), (channel), (product_line))这几组之间没有统一层级。如果硬套 ROLLUP 或 CUBE,数据库会自动生成额外层次,结果反而更乱。
例如把需求塞进 ROLLUP(dept, city, channel),就可能多出许多根本没人要的汇总行,比如 (dept)、(dept, city) 等中间层结果。对于报表、接口或离线分析来说,这些多余数据不仅增加结果集体积,还会让后续过滤和展示逻辑变复杂。
所以,GROUPING SETS 最适合的不是“任何多维聚合”,而是“已知要哪些组合,而且这些组合并不连续”的场景。
先看支持情况:不是所有数据库都能用
在语法层面,GROUPING SETS 属于标准 SQL,但并不代表主流数据库都会实现。
如果你使用的是 MySQL,需要先排除这条路:截至 MySQL 8.4,GROUPING SETS 仍不支持,执行会直接报错 ERROR 1064。这不是版本开关问题,而是当前明确未实现。
常见支持情况可以这样看:
PostgreSQL 9.5+、SQL Server 2008+、Oracle 9i+、Trino/Presto:支持Hive、Spark SQL:支持,但 Hive 通常要到3.1+才更稳定,旧版可能解析失败SQLite以及不少 OLAP 引擎(如ClickHouse):不支持
这也是实务里最容易忽略的一步。很多人看到它是标准 SQL,就默认当前引擎应该可用,结果在联调或上线前才发现语法根本跑不通。写查询前先确认数据库能力,比事后改写成多段 UNION ALL 更省时间。
结果里的 NULL 该怎么理解
GROUPING SETS 最容易踩坑的地方,不是语法本身,而是结果解释。输出中的 NULL,很多时候并不是原始数据缺失,而是数据库为了对齐不同分组维度补出来的占位符。
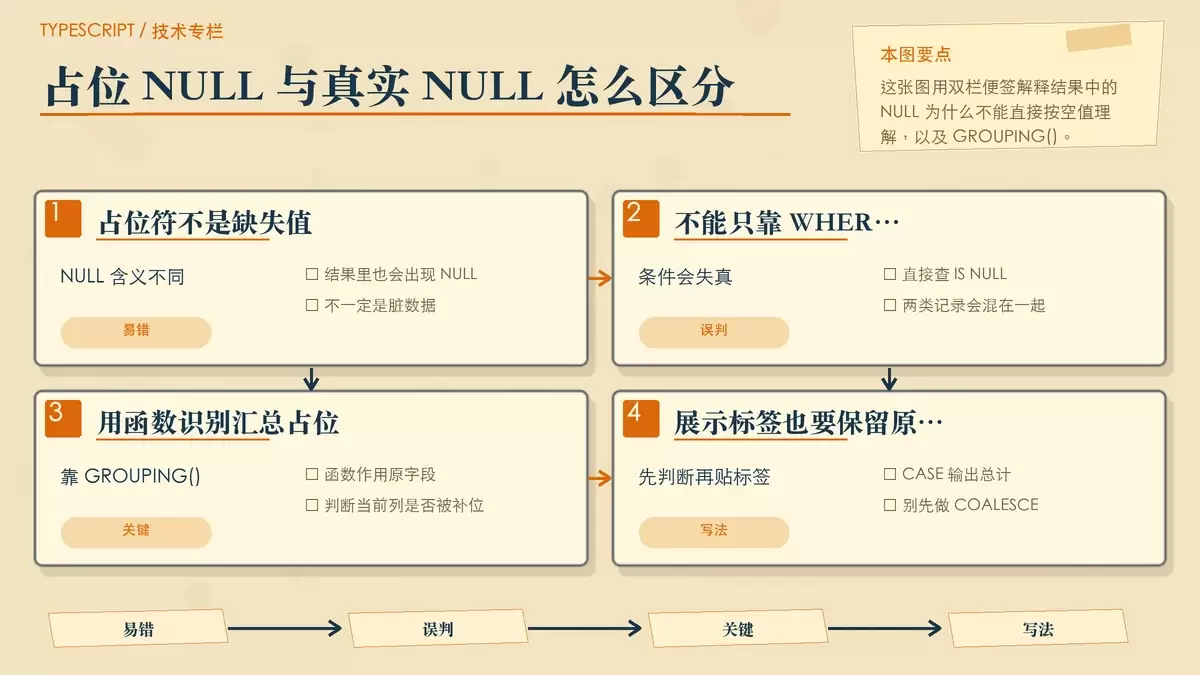
这意味着你不能直接把它当成业务含义上的空值来判断。
例如,真实数据里的 dept 本身就可能为 NULL。而在汇总结果中,某些行里的 dept = NULL 可能只是因为这一组根本没按 dept 分组。两种 NULL 混在一起后,如果只写:
WHERE dept IS NULL你就无法知道筛出来的是原始空值,还是分组占位值。
正确做法是配合 GROUPING() 使用。它必须直接作用于原始字段,用来判断该列当前是不是由汇总语法补出来的占位列。
尤其要注意这类误用:
COALESCE(dept, 'ALL')如果你先这样替换,再去判断分组状态,GROUPING(dept) 的意义就被破坏了,因为函数判断的前提就是原始字段本身。
想在结果里加可读标签,应当在 SELECT 中显式区分,例如:
CASE WHEN GROUPING(dept) = 1 THEN '总计' ELSE dept END这样才不会把“真实 NULL”与“汇总占位 NULL”混为一谈。
排序也要按数据库方言处理。比如 PostgreSQL 可以写:
ORDER BY dept NULLS FIRST而在 SQL Server 里,通常需要改写成类似:
ORDER BY ISNULL(dept, '')两者想解决的是同一类问题,但写法并不通用。
性能收益到底来自哪里
GROUPING SETS 经常被理解成“性能更好的聚合写法”,这个说法并不准确。它真正可能带来的收益,是把多次汇总合并为一次扫描,减少重复 I/O;但这不等于单次执行本身会更快。
如果底层表没有合适索引、数据量极大,或者聚合字段基数很高,查询依然可能很慢。它省下来的主要是重复读表的成本,不是凭空让聚合更轻。
这一点在大结果集场景里尤其明显。比如对高基数字段 user_id、order_no 做多层组合汇总,或者误写成下面这种近似全展开的形式:
GROUPING SETS ((a,b,c), (a,b), (a), (b), (c), ())结果集可能快速膨胀,严重时会导致内存压力上升,甚至溢出。类似问题在 CUBE 上更常见,因为它天然容易把组合数做大。
另外,底层存储也会影响收益判断。如果你的数据跑在列存环境中,例如 Parquet + Spark,扫描本身就已经相对高效,那么通过 GROUPING SETS 节省的 I/O 成本,未必像行存系统里那样明显。
还有一个容易被忽略的细节:某些数据库对 ROLLUP 做了专门优化。以 PostgreSQL 为例,在语义等效的情况下,ROLLUP(a,b) 有时会比下面这种展开式写法更快:
GROUPING SETS ((a,b),(a),())所以,若你的需求本身就是标准层级汇总,直接用 ROLLUP 可能更合适;不要因为 GROUPING SETS 更灵活,就默认它一定是最优解。
怎么判断它是不是合适的选择
可以把判断标准压缩成三个问题:
- 你要的是否是几组固定、离散、非连续的分组组合
- 当前数据库是否真的支持
GROUPING SETS - 你是否准备好用
GROUPING()区分占位NULL与真实NULL
如果这三点都满足,GROUPING SETS 能明显减少多段聚合 SQL 的拼接成本,让结果更集中、逻辑更清晰。反过来,如果需求本身是层级汇总、数据库不支持,或者团队对占位 NULL 没有统一处理方式,那它带来的麻烦往往会比收益更大。















