



在报表、趋势分析和按用户统计这类场景里,移动平均往往不是“会不会写”这么简单,真正决定结果是否可信的是窗口范围、排序方式和分组边界。下面就按数据库能力来拆解:先看 MySQL 8.0+ 的标准写法,再说明 PostgreSQL、SQL Server 与 SQLite 的差异,最后补上首尾行和 NULL 值该怎么处理,方便你判断哪种结果才符合业务定义。
MySQL 8.0+:分组移动平均的标准写法
在 MySQL 8.0+ 中,AVG() 配合 OVER() 窗口函数,是计算分组移动平均最直接也最稳妥的方式。相比 MySQL 5.7 及更早版本用子查询、自连接硬算,8.0+ 不仅语法更清晰,也更适合在生产环境里使用。
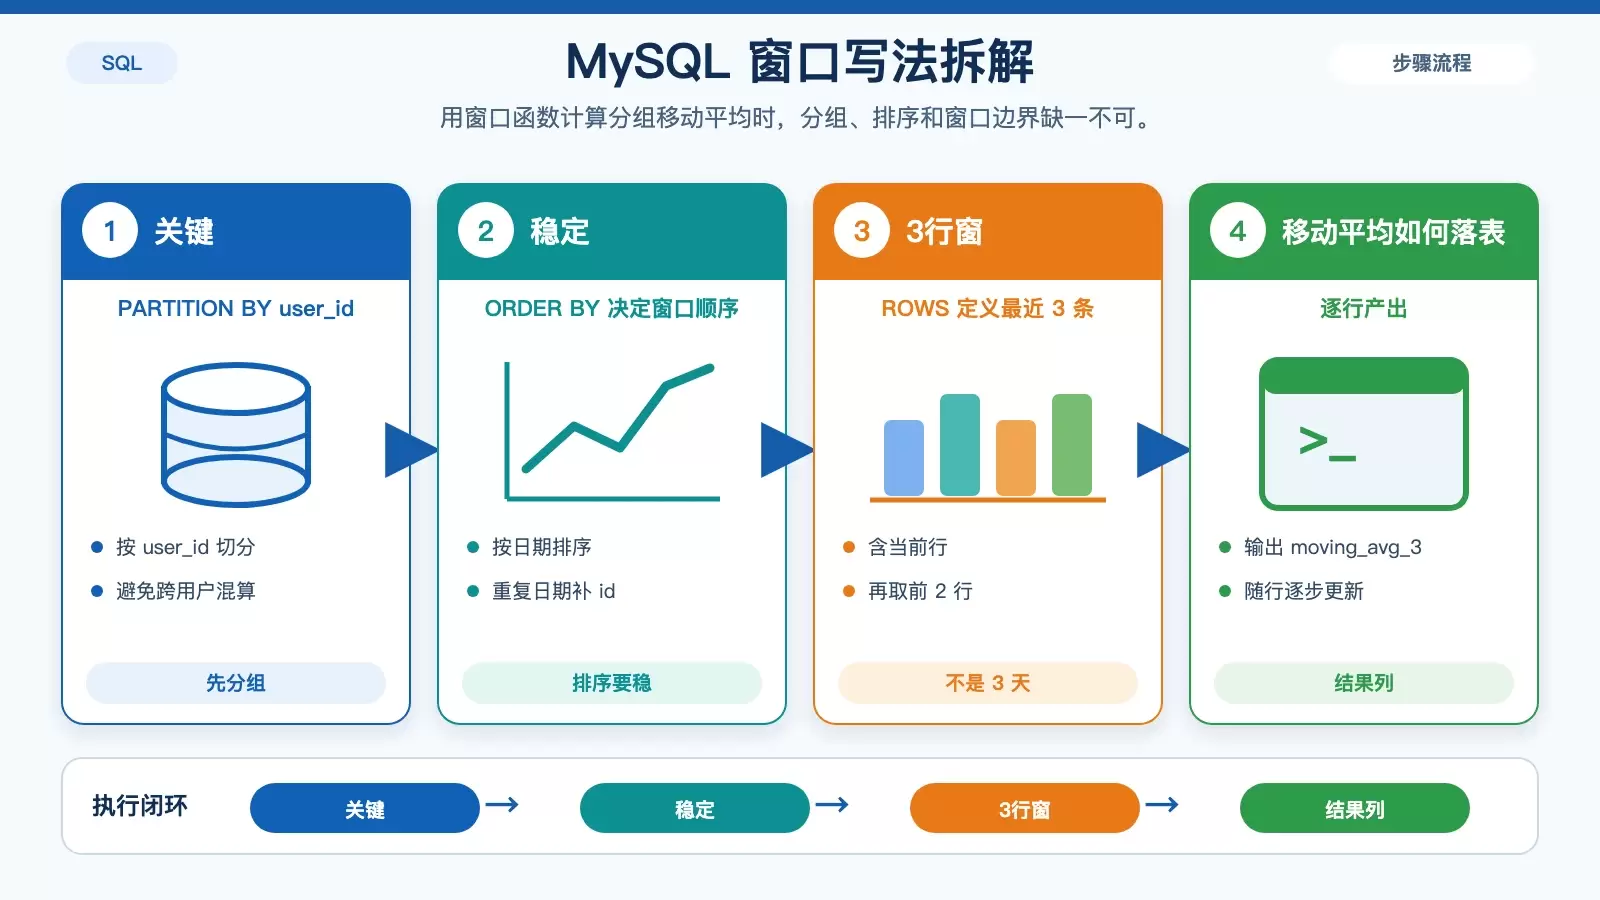
关键点不在于能不能求平均,而在于你如何定义窗口。若需求是“按时间排序,对每个用户计算最近 3 条记录的销售额移动平均”,可以直接这样写:
SELECT
user_id,
sale_date,
amount,
AVG(amount) OVER (
PARTITION BY user_id
ORDER BY sale_date
ROWS BETWEEN 2 PRECEDING AND CURRENT ROW
) AS moving_avg_3
FROM sales;
这段 SQL 里有三个不能省略的判断点:
PARTITION BY user_id用来按用户分组,否则不同用户的数据会被放进同一窗口里一起计算。ORDER BY sale_date决定窗口向前回溯的顺序,没有排序就谈不上“移动”。ROWS BETWEEN 2 PRECEDING AND CURRENT ROW表示当前行加前面 2 行,总共 3 行,它表示的是“最近 3 条记录”,不是“过去 3 天”。
这里最容易被忽略的是排序稳定性。如果 sale_date 可能重复,那么只按日期排序会带来非确定性结果,实际使用时应补上唯一字段,例如:
ORDER BY sale_date, id这样可以避免同一天多条记录在不同执行中排序不一致,进而影响移动平均结果。
ROWS 和 RANGE 不是一回事
很多“结果看起来差一点”的问题,根源都在把 ROWS 和 RANGE 混用了。两者名字接近,但含义完全不同:
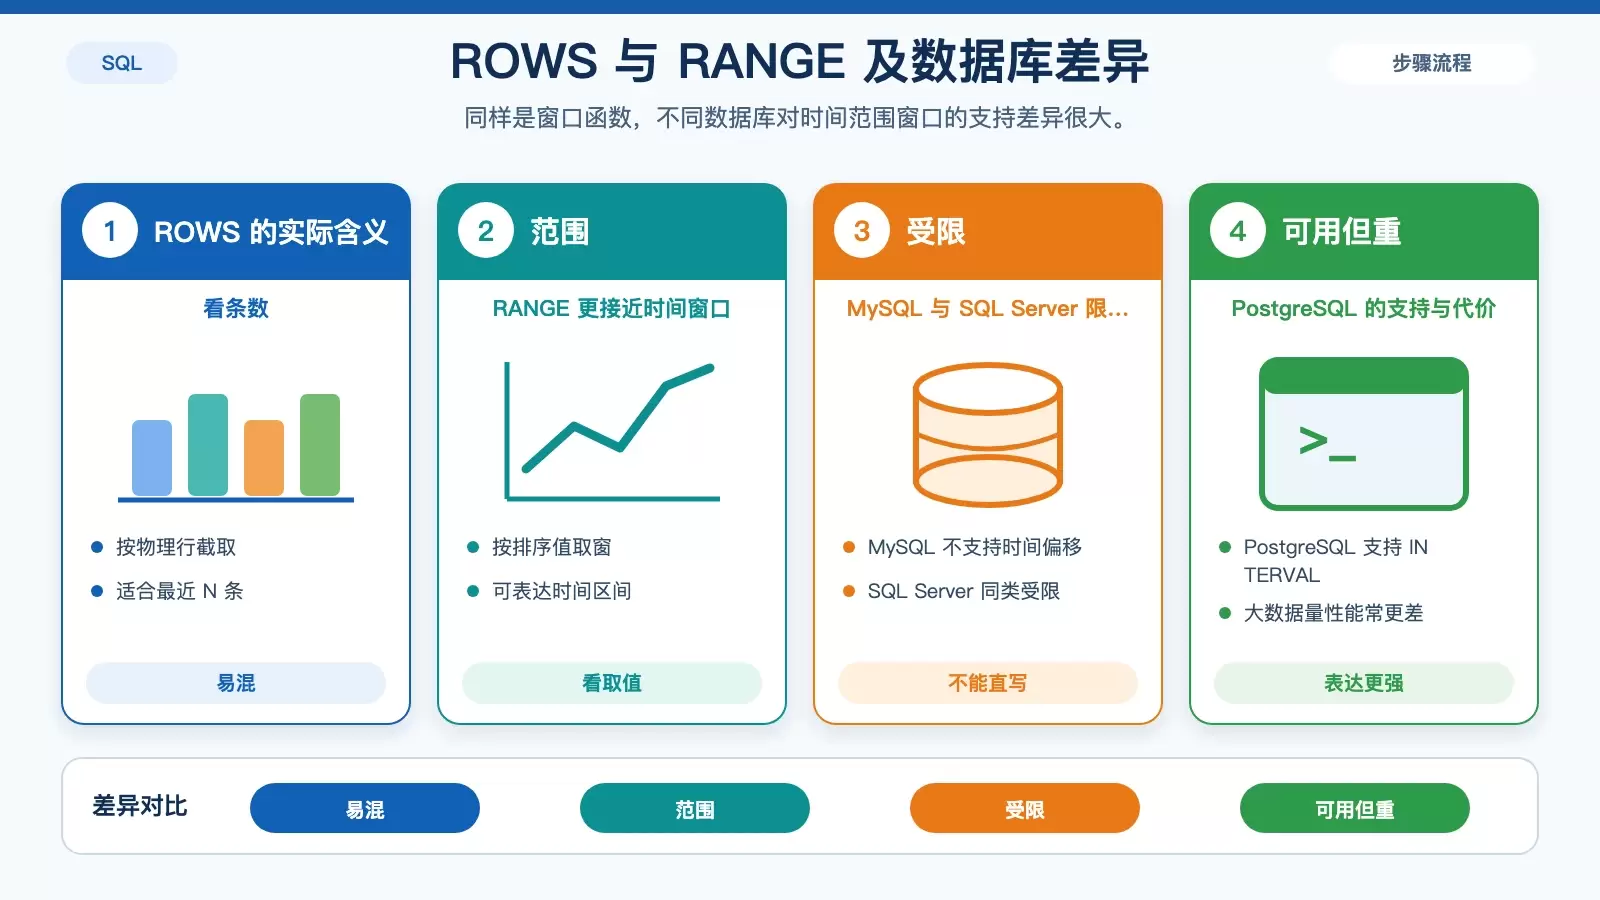
ROWS按物理行数截取窗口,适合“最近 N 条记录”这类需求。RANGE按排序值的范围截取窗口,更接近“过去 N 天”“价格差在某范围内”这类语义。
以 PostgreSQL 为例,下面这种“按时间范围取窗口”的写法是成立的:
RANGE BETWEEN INTERVAL '2 days' PRECEDING AND CURRENT ROW但在 MySQL 8.0+ 中,RANGE 不能这样搭配时间间隔使用,所以如果需求是“统计过去 7 天内的移动平均”,就不能直接套窗口范围语法。
这也是跨数据库迁移时最常见的坑之一。表面上看都是窗口函数,实际上支持边界完全不同:
- MySQL 8.0+:适合用
ROWS处理固定条数窗口,但不支持基于时间偏移的RANGE写法。 - PostgreSQL:支持
RANGE+INTERVAL,表达能力更强,但大数据量下性能通常不如ROWS。 - SQL Server 2012+:支持
ROWS,但和 MySQL 一样,不支持这类时间偏移的RANGE。
所以在写 SQL 之前,先确认你要的是“最近几条”还是“过去几天”,这一步比函数本身更重要。
SQLite 或旧版本环境只能退回子查询
如果数据库不支持窗口函数,问题就不再是语法优雅,而是如何在可接受的性能内把结果算出来。SQLite 3.25+ 已支持窗口函数,但不少旧环境,尤其是 Android 自带 SQLite,仍可能无法直接使用这套能力。
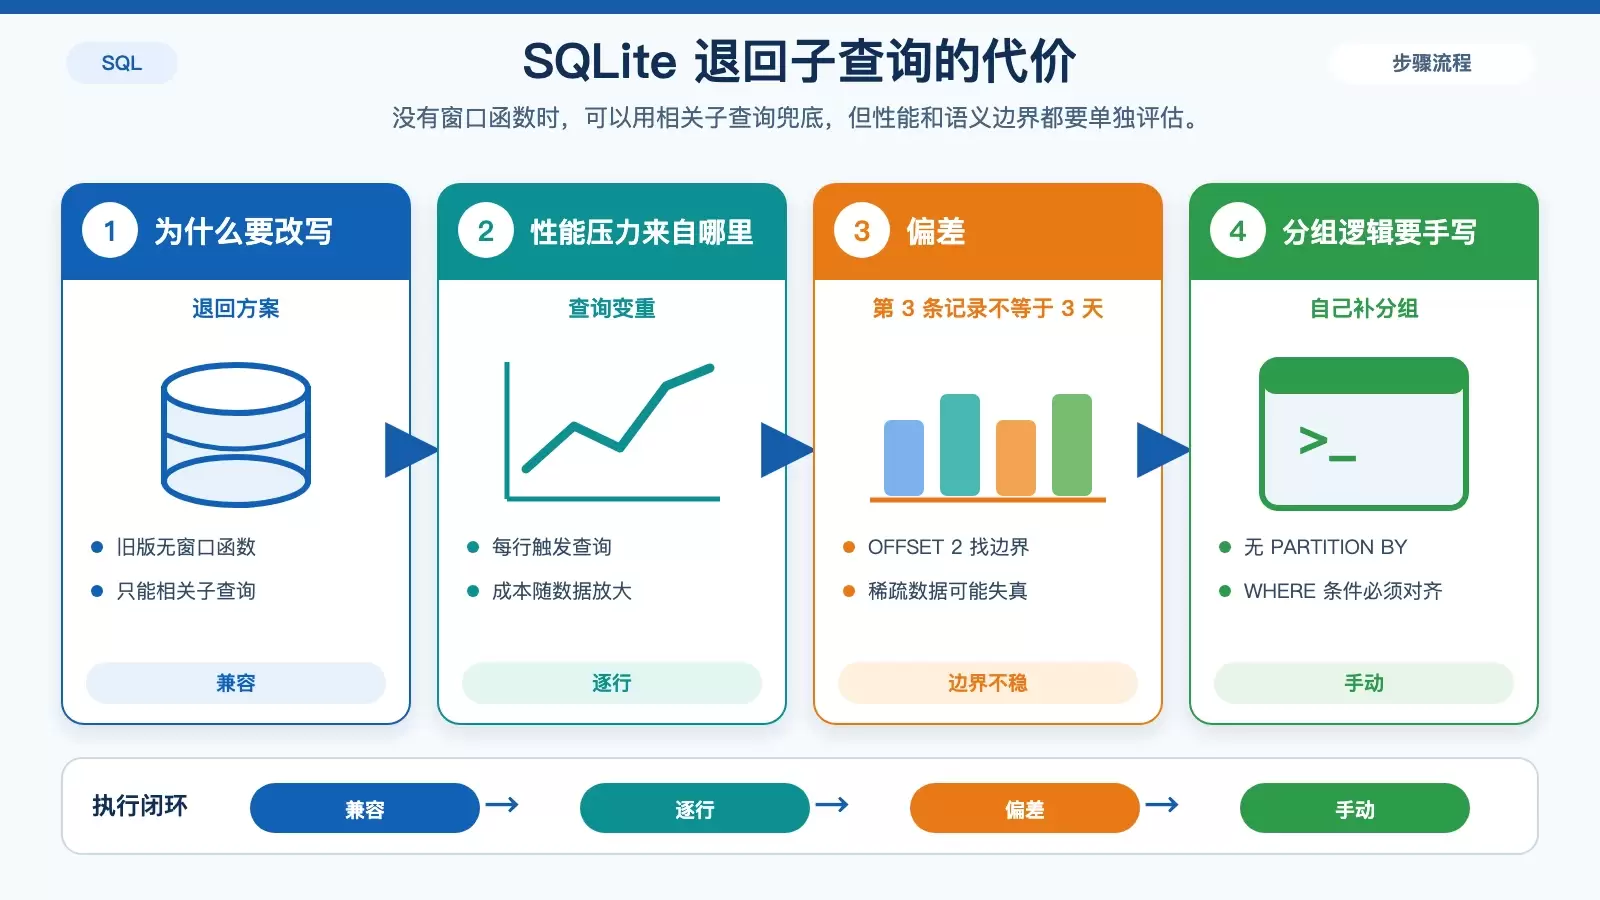
这时只能退回相关子查询写法,例如:
SELECT
t1.user_id,
t1.sale_date,
t1.amount,
(SELECT AVG(t2.amount)
 FROM sales t2
 WHERE t2.user_id = t1.user_id
 AND t2.sale_date <= t1.sale_date
 AND t2.sale_date >= (
 SELECT MAX(t3.sale_date)
 FROM sales t3
 WHERE t3.user_id = t1.user_id
 AND t3.sale_date <= t1.sale_date
 ORDER BY t3.sale_date DESC
 LIMIT 1 OFFSET 2
 )
) AS moving_avg_3
FROM sales t1;
这种写法能跑,但代价也很明显:
- 每一行都要触发子查询,数据量一大,延迟会快速上升,10 万行数据很容易从毫秒级变成秒级。
LIMIT 1 OFFSET 2试图找到“往前数第 3 条”的边界,但如果某个用户的数据分布很稀疏,结果未必符合你原本想表达的窗口定义。- 没有
PARTITION BY这种天然分组机制,必须在WHERE里手动把分组条件写完整,例如这里的t2.user_id = t1.user_id。
换句话说,旧环境里不是不能做移动平均,而是成本会显著上升。只要数据库版本允许,优先升级到支持窗口函数的版本,通常比继续堆复杂子查询更划算。
边界行与 NULL 值要先和业务对齐
移动平均的另一个高频误区,不是 SQL 写错,而是默认行为和业务预期不一致。所有主流数据库在窗口开头不足 N 行时,默认只对实际存在的行求平均,不会自动补 NULL,也不会补 0。
例如 3 行移动平均中:
- 第 1 行的结果就是它本身的值。
- 第 2 行是前 2 行的平均值。
- 第 3 行开始,才会稳定进入完整的 3 行窗口。
这不是 bug,而是窗口函数的默认定义。但在业务报表中,这种首行、前两行数值偏高或偏低的现象,经常会被误认为异常,因此最好提前确认规则。
如果你的要求是“不满 3 行就返回 NULL”,就要显式加判断。在 MySQL 中可以这样处理:
CASE WHEN COUNT(*) OVER(...) < 3 THEN NULL ELSE AVG(...) OVER(...) END另外,原始数据里如果 amount 本身存在 NULL,AVG() 会像普通聚合函数一样自动忽略这些值。这一点虽然符合 SQL 常规行为,但在排查结果偏差时很容易被漏看,尤其当业务方默认把缺失值理解为 0 时,统计口径就会直接不同。
因此,写移动平均时至少要确认三件事:窗口是按行还是按时间,首尾不足 N 行时是否照算,以及源数据中的 NULL 到底是忽略还是需要先补值。把这些规则说清楚,比单纯跑出一个平均数更重要。















