



做“相邻订单时间差”统计时,很多查询看起来能跑通,结果却不一定有业务意义。最常见的问题有三个:排序字段选错,把不同用户的订单混到一起算,以及在大表上因为缺索引导致查询突然变慢。
这篇文章把这类查询拆成几个关键环节:先用 LAG() 取到上一笔订单时间,再根据不同数据库计算时间差,接着处理首单的 NULL,最后再看执行计划和索引是否到位。看完后,你可以判断自己的 SQL 到底是“能出结果”,还是“结果正确且能上线”。
为什么要先用 LAG() 取上一笔订单时间
窗口函数计算相邻订单时间差,本质上是先拿到当前行和上一行的时间字段。最直接的方式就是 LAG(),它能按照指定顺序返回前 N 行的值。
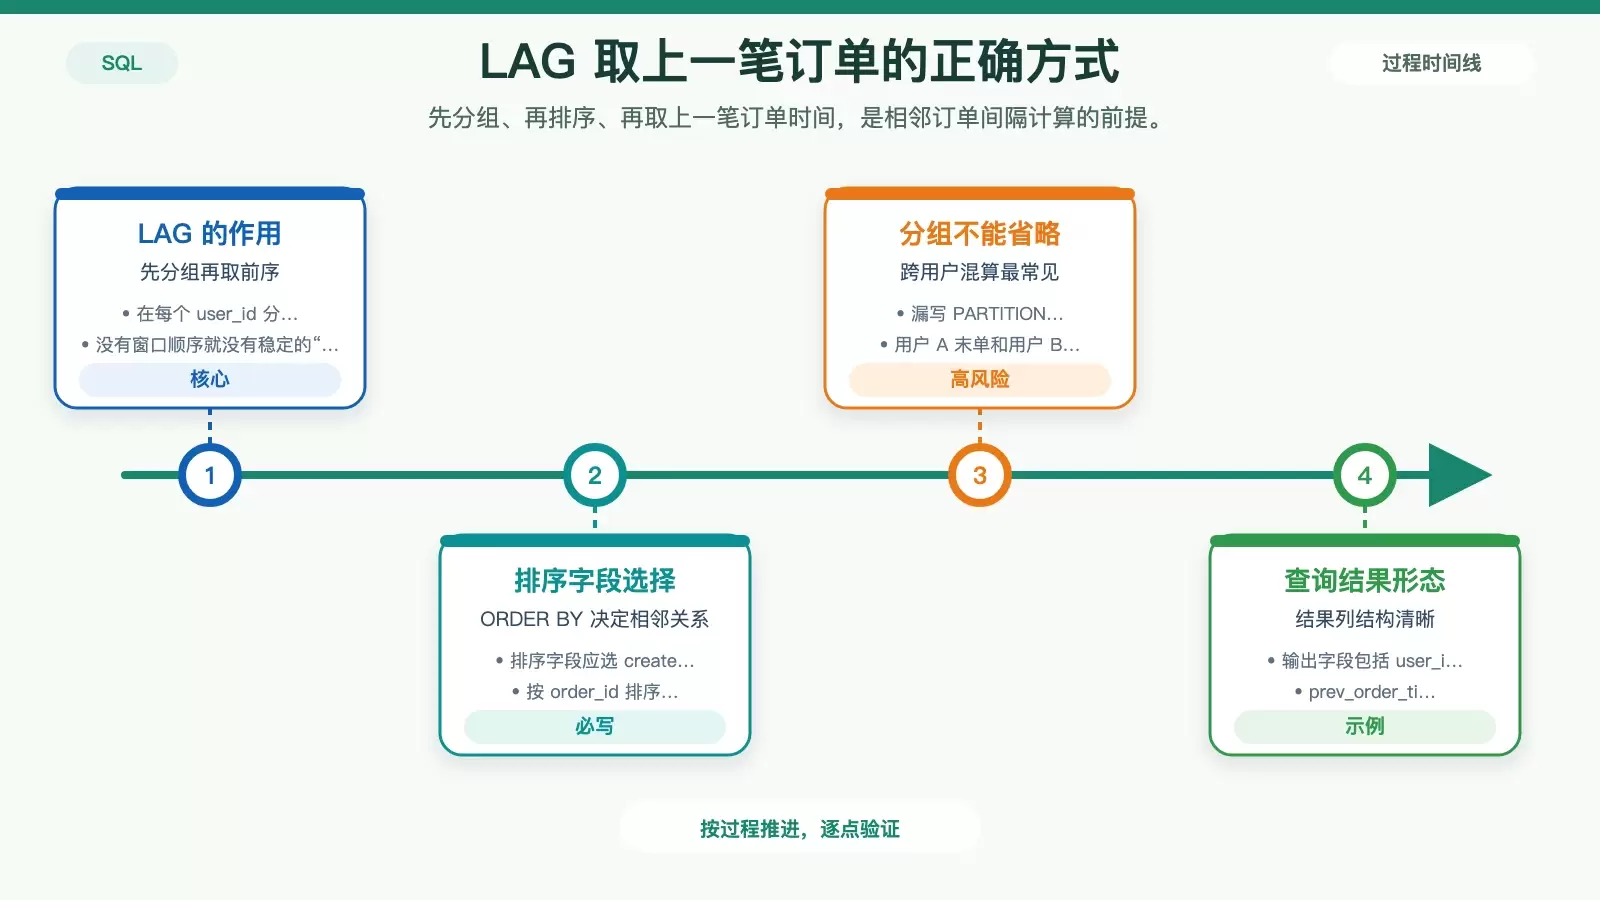
这里有两个前提不能省:
- 必须写
ORDER BY,否则“上一行”没有稳定含义。 - 多数业务场景都要写
PARTITION BY,否则会把不同用户的订单串在一起计算。
尤其要注意,按 order_id 排序不等于按真实下单时间排序。要计算订单间隔,排序字段应该是 created_at 或 order_time 这类真实时间列。
常见错误是漏掉 PARTITION BY。这样一来,用户 A 的最后一单和用户 B 的第一单可能会被当成“相邻订单”,得到的时间差没有任何业务价值。
SELECT
user_id,
order_time,
LAG(order_time) OVER (PARTITION BY user_id ORDER BY order_time) AS prev_order_time
FROM orders;
这条 SQL 的作用很明确:在每个 user_id 分组内,按 order_time 排序,取出上一笔订单时间,生成 prev_order_time。
不同数据库怎样计算时间差
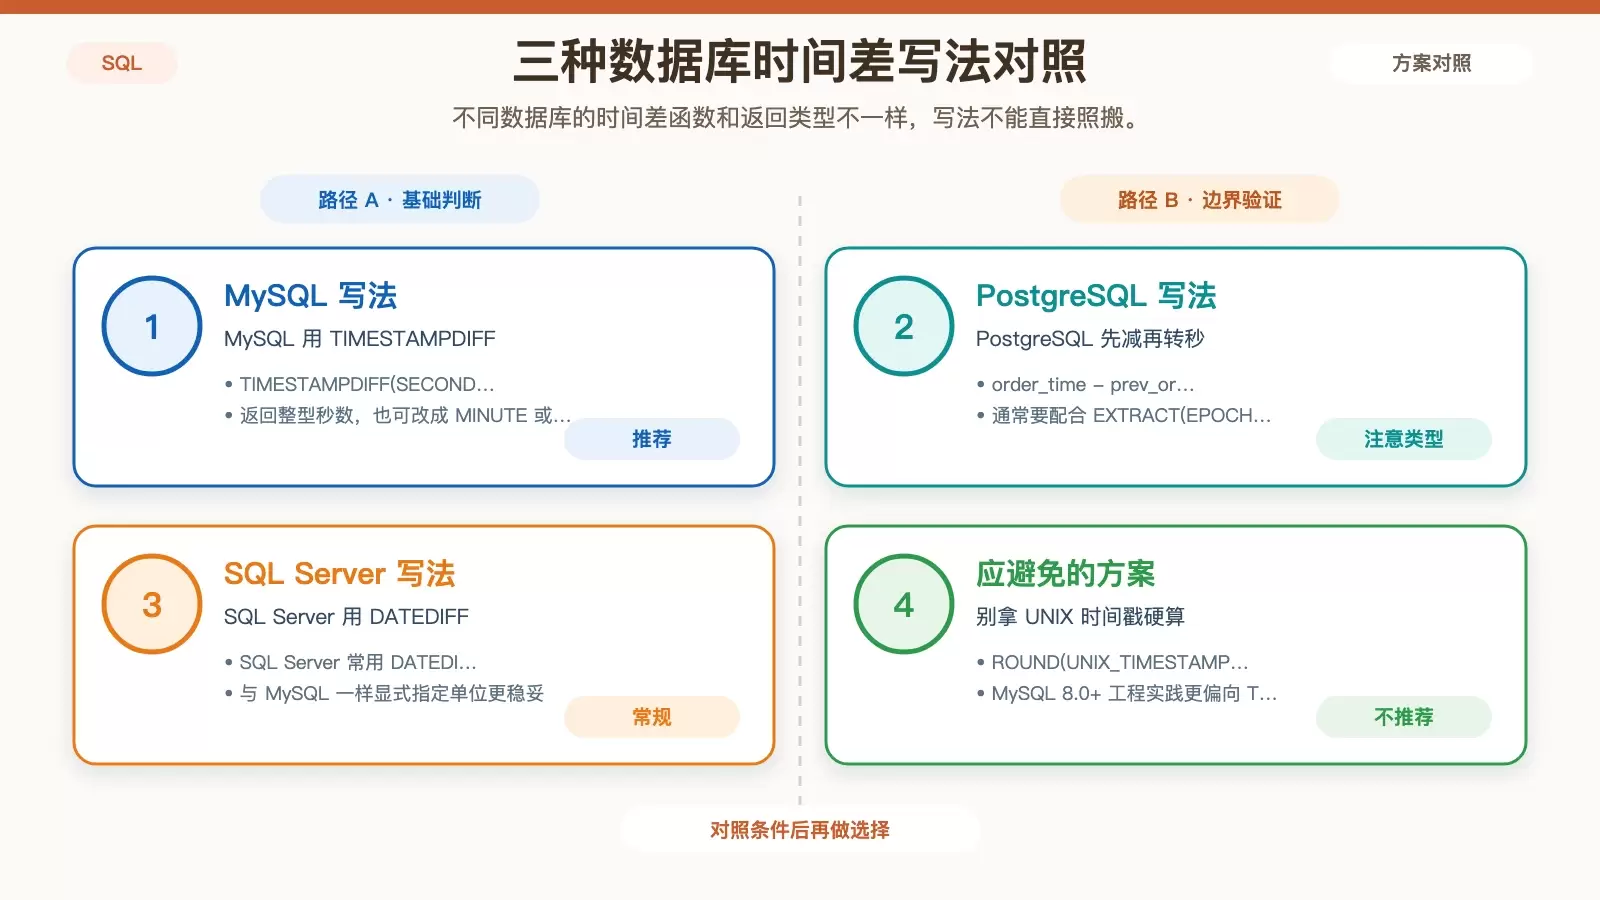
拿到当前订单时间和前一笔订单时间后,下一步就是做差值。不过这一段在不同数据库里的写法并不一样。
MySQL:优先用 TIMESTAMPDIFF()
MySQL 更适合直接用 TIMESTAMPDIFF() 指定单位来计算,这样结果更清晰,也能避免直接相减得到“小数天”的情况。
TIMESTAMPDIFF(SECOND, prev_order_time, order_time)这会返回整型秒数。把 SECOND 换成 MINUTE、HOUR 也可以得到分钟或小时级间隔。
PostgreSQL:减法返回 interval,需要再转秒
在 PostgreSQL 里,直接执行 order_time - prev_order_time,返回的是 interval 类型,不是整数秒。要用于统计或排序,通常还要再转一次:
EXTRACT(EPOCH FROM order_time - prev_order_time)这样可以得到秒数结果,便于后续聚合或判断。
SQL Server:使用 DATEDIFF()
SQL Server 的常见写法是:
DATEDIFF(second, prev_order_time, order_time)这一点和 MySQL 的思路类似,都是显式指定单位,而不是依赖时间字段直接相减。
为什么不建议用 UNIX_TIMESTAMP() 差值凑结果
像下面这种写法,虽然表面上也能得出秒数,但并不推荐:
ROUND(UNIX_TIMESTAMP(...) - UNIX_TIMESTAMP(...))原因主要有两个:
- 时区处理更容易出错。
- 在 MySQL 8.0+ 场景里,官方和实际工程实践都更偏向
TIMESTAMPDIFF()这类明确表达语义的方式。
首单和空值怎么处理才不误判
LAG() 对每个分组的第一行一定会返回 NULL。如果直接参与减法,结果也会跟着变成 NULL。这本身没错,但业务层通常需要更明确的规则。
方案一:用 COALESCE() 把首单差值设为 0
如果你的报表希望第一笔订单直接显示为 0 秒,可以这样写:
COALESCE(TIMESTAMPDIFF(SECOND, LAG(order_time) OVER (...), order_time), 0)这种做法适合展示型场景,前端或报表不需要额外处理空值。
方案二:保留空值,通常更适合分析场景
如果你希望明确区分“没有前序订单”和“确实间隔为 0 秒”,那就不该简单把首单都改成 0。更稳妥的思路是保留原始空值语义,必要时结合 NULLIF() 处理:
NULLIF(TIMESTAMPDIFF(...), 0)配合 LAG 产生的原始 NULL,可以更清楚地区分两类情况:
- 首单没有上一笔订单,结果应为空。
- 两笔订单时间完全一致,才可能出现 0 秒间隔。
一个容易踩坑的细节:不要提前包裹 LAG()
COALESCE 不能在差值计算前就包住 LAG()。如果你先把 LAG() 返回的 NULL 强行替换成某个固定时间,再去计算差值,得到的间隔就是伪造出来的,已经失去了原始数据含义。
性能关键点:ORDER BY 字段必须命中索引
窗口函数里的 ORDER BY 不是装饰项,它直接决定数据库怎样扫描和排序数据。没有索引时,大表很容易触发文件排序,也就是执行计划里的 Using filesort。
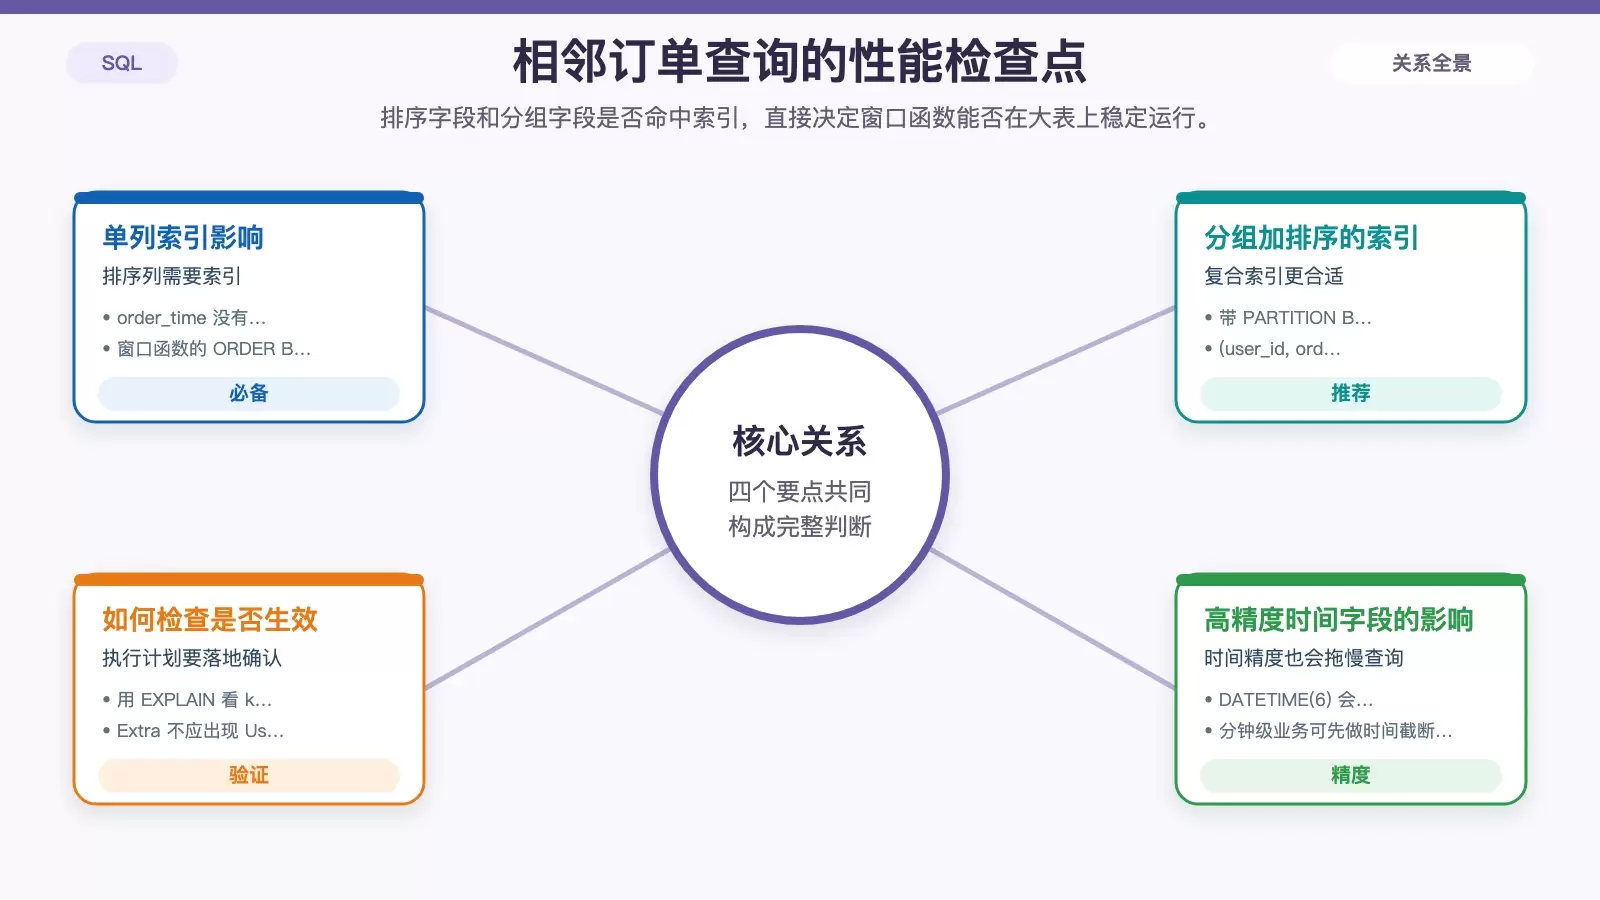
如果只是按时间排序,至少要关注 order_time 的索引;如果查询还带了 PARTITION BY user_id,那更实用的做法通常是建立复合索引:
(user_id, order_time)这能让“按用户分组、按时间排序”的访问路径更贴近实际查询模式。
怎么验证索引有没有真正生效
最直接的方法是跑一次 EXPLAIN,重点看两处:
key列是否命中了预期索引。Extra里是否出现Using temporary; Using filesort。
如果没有索引,10 万行数据的查询很可能从毫秒级拖到秒级,这在报表页或实时接口里都很容易出问题。
时间精度过高时,排序和业务判断都可能受影响
还有一个经常被忽略的问题是时间字段精度。假设表里存的是 DATETIME(6),也就是微秒级时间戳,但业务上只关心分钟级间隔,那么过高精度会带来两类影响:
- 排序比较成本更高。
- 同一分钟内的订单,可能因为毫秒或微秒差异被判成“不同间隔”。
这种情况下,可以按业务粒度先做截断。例如:
DATE_SUB(order_time, INTERVAL SECOND(order_time) SECOND)这样能先把秒级部分处理掉,既减少比较开销,也能避免“同一分钟订单却被当成非相邻”的误判。
写这类 SQL 时,最该检查的 4 件事
如果你要把“相邻订单时间差”查询放进正式业务,至少要逐项确认下面这几件事:
LAG()是否配合了正确的ORDER BY。- 是否按
user_id等业务维度使用了PARTITION BY。 - 时间差函数是否符合当前数据库的返回类型和单位习惯。
- 排序字段或复合字段是否有索引,并用
EXPLAIN验证过执行计划。
这几个点都成立,查询结果才既有业务意义,也更接近可上线的状态。















