


Python爬取豆瓣Top250电影信息实战:从基础到多线程

本文详解使用Python requests库与正则表达式爬取豆瓣电影Top250的完整流程。涵盖获取页面源码、解析电影序号、名称、评分及经典台词,并将结果以字典形式追加写入TXT文件。此外,文章对比了常规循环与多线程Pool的实现方式,提供高效获取电影数据的代码示例。
本文通过一个具体实例,展示如何使用Python实现豆瓣电影信息的抓取功能。该案例旨在为读者提供可参考的代码实践。
爬取目标与数据格式定义
本案例的核心任务是抓取豆瓣电影Top250榜单中的电影数据,具体字段包括排名序号、电影标题、导演及主演信息、评分以及经典台词。抓取到的数据将整理为字典格式,并保存至txt文件中。值得注意的是,本示例仅依赖requests库进行网络请求,未引入beautifulsoup等HTML解析库。
第一步是获取每一页的网页源代码。通过调用requests.get函数发起请求,为了增强程序的健壮性,防止因网络波动或服务器拒绝导致的程序崩溃,代码中使用了try...except结构来处理可能出现的异常。
获取网页源代码与异常处理
def getpage(url):
  try:
    res=requests.get(url)
    if res.status_code==200:
      return res.text
    return None
  except RequestException:
    return None
第二步是对每一页的网址进行解析。以原始网址https://movie.douban.com/top250?为例,检查网页源代码可知,每部电影的HTML结构均始于<li>标签,止于</li>标签。编写相应的正则表达式后,解析得到的列表每一项包含五个元素。为了结构化存储这些数据,将其转换为字典格式。此过程使用了yield函数生成器,关于yield的具体用法,可参考廖雪峰老师的相关文章(链接见)。
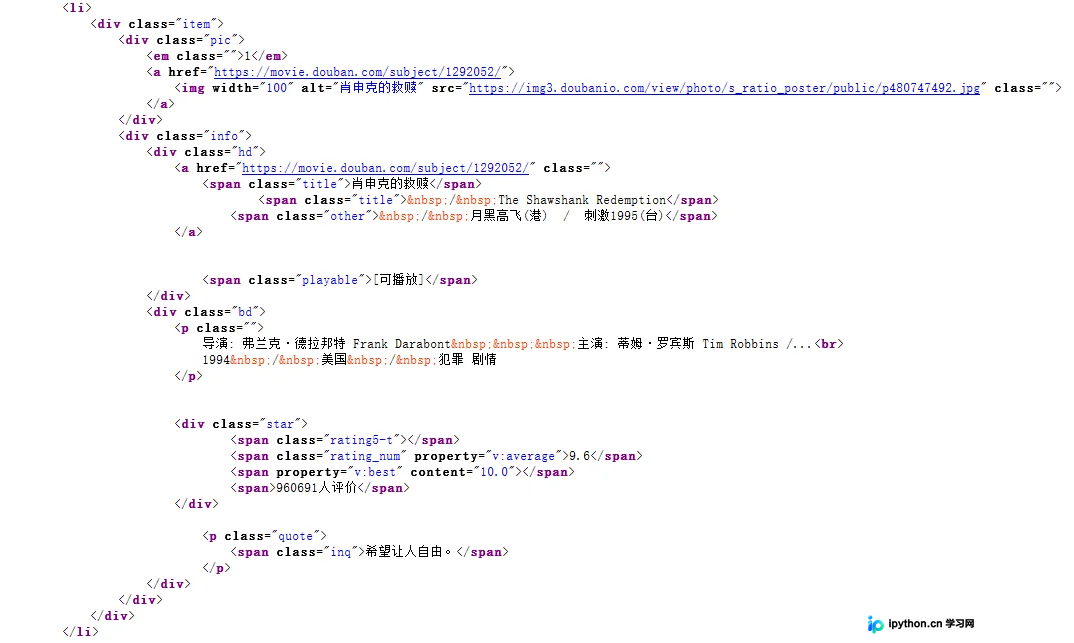
以下是针对单个网页进行数据解析的核心代码实现:
正则解析与字典生成
def parsepage(html):
  pat=re.compile('<li>.*?<em class="">(.*?)</em>.*?<img width="100" alt="(.*?)" src=.*?<p class="">'
          +'(.*?)</p>.*?property="v:average">(.*?)</span>.*?<span class="inq">(.*?)</span>.*?</li>',re.S)
  items=re.findall(pat,html)
  for item in items:
    yield{
      'index':item[0],
      'title':item[1],
      'stars':item[2].strip(),
      'score':item[3],
      'concept':item[4]
    }
接下来是将解析后的每个item写入文件。在open函数中指定encoding='utf-8'和ensure_ascii=False,以确保写入文件时中文字符不会乱码。使用json.dumps将字典对象转换为字符串(需提前import json模块)。with open打开文件时,第二个参数设置为'a',表示以追加模式写入,即每次写入内容会接在文件末尾,而非覆盖原有内容。此外,在写入字符串后添加\n换行符,保证每个item独占一行。
数据写入TXT文件规范
def write_tofile(content):
  with open('doubanfilms.txt','a',encoding='utf-8' ) as f:
    f.write(json.dumps(content,ensure_ascii=False)+'\n')
    f.close()
最后,需要通过循环语句对全部10页内容进行上述操作。第二页的URL是在第一页基础上添加start=25参数,第三页添加start=50,依此类推,第i页(从0开始计数)的start值为25*i。以下是主函数的完整代码:
主循环与URL构造逻辑
def main():
  url="https://movie.douban.com/top250?"
  for i in range(0,9):
    url_i=url+'start='+str(25*i)
    html_i=getpage(url_i)
    for item in parsepage(html_i):
      print(item)
      write_tofile(item)
if __name__ == '__main__':
  main()
上述主函数代码还有另一种等效的写法,逻辑如下:
主函数替代写法
def main(start):
  url="https://movie.douban.com/top250?start="+str(start)
  html=getpage(url)
  for item in parsepage(html):
    print(item)
    write_tofile(item)
if __name__ == '__main__':
  for i in range(10):
    main(i*10)
若希望提升程序的运行效率,可以采用多线程爬虫技术(尽管对于此小规模数据抓取,多线程并非必要):
多线程优化方案
#在最开始加载Pool包
from multiprocessing import Pool
#最后的执行段改为:
if __name__ == '__main__':
  for i in range(10):
    main(i*10)
  pool=Pool() #在循环外写
  pool.map(main,[i*10 for i in range (10)])
如需了解更多Python相关技术,可查阅本站系列教程,包括《Python Socket编程技巧总结》、《Python正则表达式用法总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》以及《Python文件与目录操作技巧汇总》。
希望本文提供的代码与解析能对大家学习Python程序设计有所帮助。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















