


Python多线程爬虫实战:解析与抓取笑话网站内容

发布时间:2026-10-13 |
3人浏览过
本文介绍使用Python爬取幽默笑话网站的技术实现。通过threadpool线程池处理多页并发请求,优化系统性能;利用lxml与正则表达式结合的方式清洗HTML结构中的混乱文本。文章提供了完整的代码示例,包括多线程任务调度、节点提取及文本过滤逻辑,帮助开发者掌握高效的数据抓取技巧。
爬虫目标与难点分析
本次爬取的目标网站为:http://xiaohua.zol.com.cn/youmo/
在分析网页结构时,发现直接爬取笑话内容存在以下难点:
多线程处理方案
1、分页处理:每页内容需点击“查看更多”链接进入子页面才能获取完整数据。由于子页面数量较多,采用多线程任务处理。引入线程池可以有效控制系统中的并发线程数量,避免因大量并发线程导致系统性能下降或Python解释器崩溃,从而提升执行效率并节省时间。
- 创建线程池:threadpool.ThreadPool()
- 创建需由线程池处理的任务:threadpool.makeRequests()。该函数用于指定开启多线程的函数、相关参数以及回调函数(若不指定则默认为无)。
- 将创建好的多个任务放入线程池:threadpool.putRequest()
- 等待所有任务处理完毕:threadpool.pool()
文本解析与清洗策略
2、内容解析:查看笑话详情页内容时,div元素内的文本分布较为混乱。部分文本位于<p>标签内,部分直接属于div文本节点。为此,采用正则表达式进行数据提取和清洗。
注意两种获取元素节点的方式:
1)使用lxml获取节点字符串
res=requests.get(url,headers=headers)
html = res.text

lxml 获取节点写法
element=etree.HTML(html)
divEle=element.xpath("//div[@class='article-text']")[0]  # 获取div节点
div= etree.tostring(divEle, encoding = 'utf-8' ).decode('utf-8') # 转换为div字符串
2)正则表达式写法1,用于过滤回车、制表符和<p>标签
# 第一种方式:replace
content = re.findall('<div class="article-text">(.*?)</div>',html,re.S)
content = content[0].replace('\r','').replace('\t','').replace('<p>','').replace('</p>','').strip()
3)正则表达式写法2,同样用于过滤回车、制表符和<p>标签
# 第二种方式:sub
for index in range(len(content)):
  content[index] = re.sub(r'(\r|\t|<p>|<\/p>)+','',content[index]).strip()

list = ''.join(content)
print(list)
完整代码示例
3、完整代码实现
index.py
import requests
import threadpool
import time
import os,sys
import re
from lxml import etree
from lxml.html import tostring


class ScrapDemo():
  next_page_url=""  #下一页的URL
  page_num=1 #当前页
  detail_url_list=0 #详情页面URL地址list
  deepth=0 #设置抓取的深度
  headers = {
    "user-agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/68.0.3440.84 Safari/537.36"
  }
  fileNum=0

  def __init__(self,url):
    self.scrapyIndex(url)

  def threadIndex(self,urllist): #开启线程池
    if len(urllist) == 0:
      print("请输入需要爬取的地址")
      return False
    ScrapDemo.detail_url_list=len(urllist)
    pool=threadpool.ThreadPool(len(urllist))
    requests=threadpool.makeRequests(self.detailScray,urllist)
    for req in requests:
      pool.putRequest(req)
      time.sleep(0.5)
    pool.wait()

  def detailScray(self,url): # 获取html结构
    if not url == "":
      url='http://xiaohua.zol.com.cn/{}'.format(url)
      res=requests.get(url,headers=ScrapDemo.headers)
      html=res.text
      # element=etree.HTML(html)
      # divEle=element.xpath("//div[@class='article-text']")[0]  # Element div
      self.downloadText(html)

  def downloadText(self,ele): # 抓取数据并存为txt文件
    clist = re.findall('<div class="article-text">(.*?)</div>',ele,re.S)
    for index in range(len(clist)):
      '''
        正则表达式:过滤掉回车、制表符和p标签
      '''
      clist[index]=re.sub(r'(\r|\t|<p>|<\/p>)+','',clist[index])
    content="".join(clist)
    # print(content)
    basedir=os.path.dirname(__file__)
    filePath=os.path.join(basedir)
    filename="xiaohua{0}-{1}.txt".format(ScrapDemo.deepth,str(ScrapDemo.fileNum))
    file=os.path.join(filePath,'file_txt',filename)
    try:
      f=open(file,"w")
      f.write(content)
      if ScrapDemo.fileNum == (ScrapDemo.detail_url_list - 1):
        print(ScrapDemo.next_page_url)
        print(ScrapDemo.deepth)
        if not ScrapDemo.next_page_url == "":
          self.scrapyIndex(ScrapDemo.next_page_url)
    except Exception as e:
      print("Error:%s" % str(e))

    ScrapDemo.fileNum=ScrapDemo.fileNum+1
    print(ScrapDemo.fileNum)

  def scrapyIndex(self,url):
    if not url == "":
      ScrapDemo.fileNum=0
      ScrapDemo.deepth=ScrapDemo.deepth+1
      print("开启第{0}页抓取".format(ScrapDemo.page_num))
      res=requests.get(url,headers=ScrapDemo.headers)
      html=res.text
      element=etree.HTML(html)
      a_urllist=element.xpath("//a[@class='all-read']/@href") # 当前页所有查看全文
      next_page=element.xpath("//a[@class='page-next']/@href") # 获取下一页的url
      ScrapDemo.next_page_url='http://xiaohua.zol.com.cn/{}'.format(next_page[0])
      if not len(next_page) == 0 and ScrapDemo.next_page_url != url:
        ScrapDemo.page_num=ScrapDemo.page_num+1
        self.threadIndex(a_urllist[:])
      else:
        print('下载完成,当前页数为{}页'.format(ScrapDemo.page_num))
        sys.exit()
runscrapy.py
from app import ScrapDemo
url="http://xiaohua.zol.com.cn/youmo/"
ScrapDemo(url)
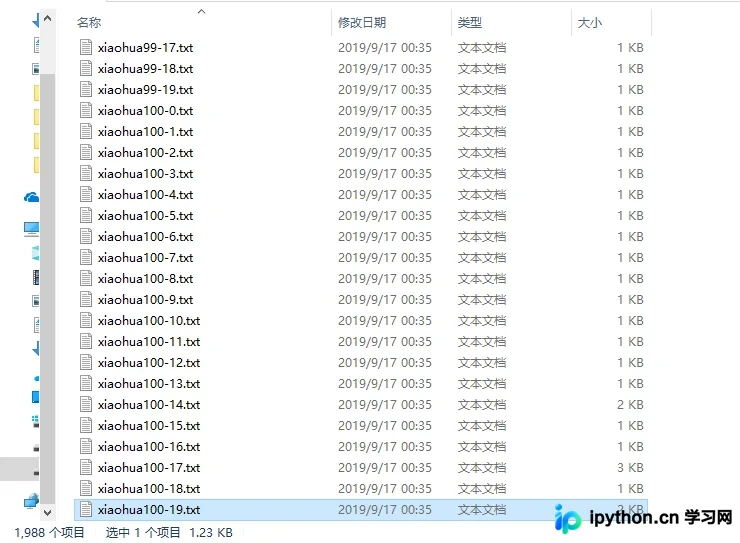
运行结果如下:
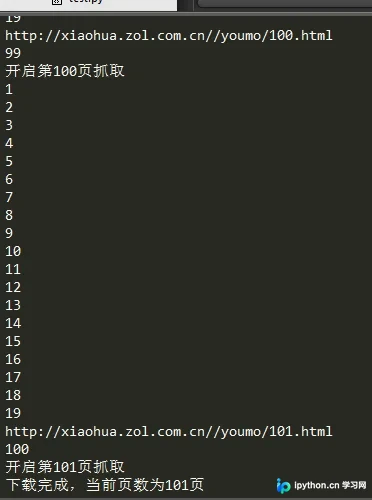
总共下载1988个文件,任务完成。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















