


Python统计学基础:数据概括性度量详解与代码实现

本文详细介绍Python中数据概括性度量的核心概念,涵盖集中趋势(众数、中位数、四分位数、平均数)与离散趋势(四分位差、极差、方差、标准差、离散系数)的计算方法,以及偏度与峰度的分布特征分析。结合Python3.5环境下的numpy和stats库代码示例,展示如何批量计算各项统计指标,为数据分析提供量化依据。
数据概括性度量概述
一、数据的概括性度量
1、统计学概括:
统计学作为应用数学的重要分支,主要依托概率论构建数学模型,对观测系统的数据进行收集、量化分析与总结,进而实施推断和预测,为决策提供科学依据。统计学通常划分为描述统计学与推断统计学两大领域。针对给定数据集,通过摘要和描述来呈现数据特征的方法被称为描述统计学;而观察者基于数据形态建立数学模型以解释随机性和不确定性,并据此推论研究步骤及母体的方法,则被称为推论统计学。
2、数据的概括性度量:
集中趋势度量方法
1)集中趋势的度量:
众数(Mode):指一组数据中出现频率最高的数值,记作M。在某些数据集中,可能存在多个众数。
中位数(Median):将数据按大小顺序排列后,位于数列中间位置的那个数值,记作Me。其具体计算公式如下:
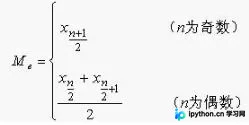
四分位数(Quartile):将所有数值从小到大排列并划分为四等份,处于三个分割点位置的数值即为四分位数。其中,QL表示下四分位数,对应第25百分位数(计算公式为 n / 4);QU表示上四分位数,对应第75百分位数(计算公式为 3n / 4)。
平均数:算术平均数(arithmetic mean)是指所有观测值的总和除以观测值个数所得的商,简称平均数或均数。
离散趋势度量指标
2)离散趋势的度量:
四分位差(quartile deviation):也称为内距或四分间距(inter-quartile range),其值为上四分位数(QU,即位于75%位置)与下四分位数(QL,即位于25%位置)之差。
极差(Range):又称全距,用于表示统计资料中的变异量数(measures of variation),其数值等于最大值与最小值之间的差距。
方差(variance):样本方差是指各个数据分别与其平均数之差的平方的和的平均数,通常以σ2表示。方差的计算公式为:
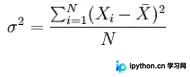
标准差(Standard Deviation):也称均方差(Mean square error),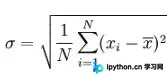 。
离散系数:又称变异系数,用CV(Coefficient of Variance)表示。CV即标准差与均值的比值。离散系数越小,表明数据的离散程度越低;反之,离散程度越高。
偏度与峰度分析
3)偏度与峰度的度量:
偏态系数:偏度(Skewness)亦称偏态或偏态系数,是衡量统计数据分布偏斜方向和程度的指标,反映分布的非对称程度。当Sk>0时,分布呈正偏态(右偏);当Sk<0时,分布呈负偏态(左偏)。
峰态系数(Kurtosis):该系数用于反映频数分布曲线顶端的尖峭或扁平程度。在正态分布情况下,峰度系数值为3。若峰度系数>3,说明观察量更集中,具有比正态分布更短的尾部;若<3,说明观测量不那么集中,具有比正态分布更长的尾部,形态类似于矩形的均匀分布。峰度系数的标准误用于判断分布的正态性,通过计算峰度系数与其标准误的比值来检验正态性。如果该比值的绝对值大于2,则拒绝正态性假设。
3、Python代码实现:
Python代码实现示例
<span style="font-family:Microsoft YaHei;font-size:12px;">#以下代码基于Python3.5环境编写
import numpy as np
import stats as sts
scores = [31, 24, 23, 25, 14, 25, 13, 12, 14, 23,
     32, 34, 43, 41, 21, 23, 26, 26, 34, 42,
     43, 25, 24, 23, 24, 44, 23, 14, 52,32,
     42, 44, 35, 28, 17, 21, 32, 42, 12, 34]
#集中趋势的度量
print('求和:',np.sum(scores))
print('个数:',len(scores))
print('平均值:',np.mean(scores))
print('中位数:',np.median(scores))
print('众数:',sts.mode(scores))
print('上四分位数',sts.quantile(scores,p=0.25))
print('下四分位数',sts.quantile(scores,p=0.75))
#离散趋势的度量
print('最大值:',np.max(scores))
print('最小值:',np.min(scores))
print('极差:',np.max(scores)-np.min(scores))
print('四分位差',sts.quantile(scores,p=0.75)-sts.quantile(scores,p=0.25))
print('标准差:',np.std(scores))
print('方差:',np.var(scores))
print('离散系数:',np.std(scores)/np.mean(scores))
#偏度与峰度的度量
print('偏度:',sts.skewness(scores))
print('峰度:',sts.kurtosis(scores))</span>
以上关于Python统计学中数据概括性度量的详解内容分享完毕,希望能对读者有所帮助,也欢迎大家继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















