


领域模型设计:聚合根与值对象建模

明确业务边界:识别实体、聚合与聚合根
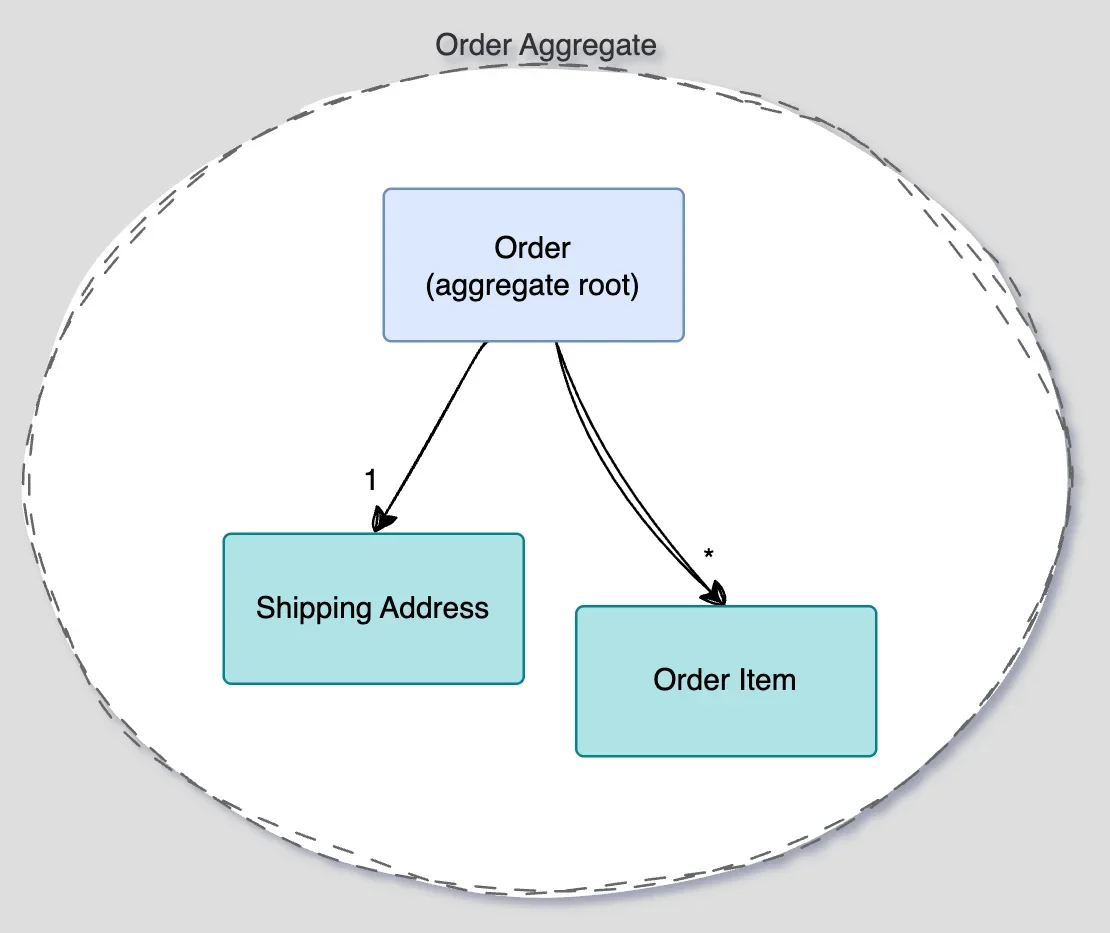
在领域驱动设计中,聚合是保证数据一致性的最小边界单元,而聚合根则是该边界的唯一访问入口。识别聚合边界必须从业务不变性出发,例如“订单总金额必须等于各订单项金额之和”或“库存扣减不能为负”。这些强一致性规则决定了哪些对象必须被包裹在同一个事务边界内。并非所有实体都应成为聚合根,因为聚合根过多会导致事务碎片化、并发冲突加剧以及领域逻辑分散。例如,在电商系统中,“订单项”是实体,但它必须依附于“订单”聚合根,因为订单项的增删改会直接影响订单总价这一不变量。从业务规则反推聚合边界的具体方法是:首先列出核心业务用例,提取其中的强一致性约束;接着将受同一约束直接影响的对象划入同一聚合;最后为每个聚合指定一个生命周期最长、负责协调内部状态的对象作为聚合根。通过这种方式,可以确保聚合边界既不过宽导致性能瓶颈,也不过窄破坏业务一致性。
设计值对象:用业务语义替代原始类型
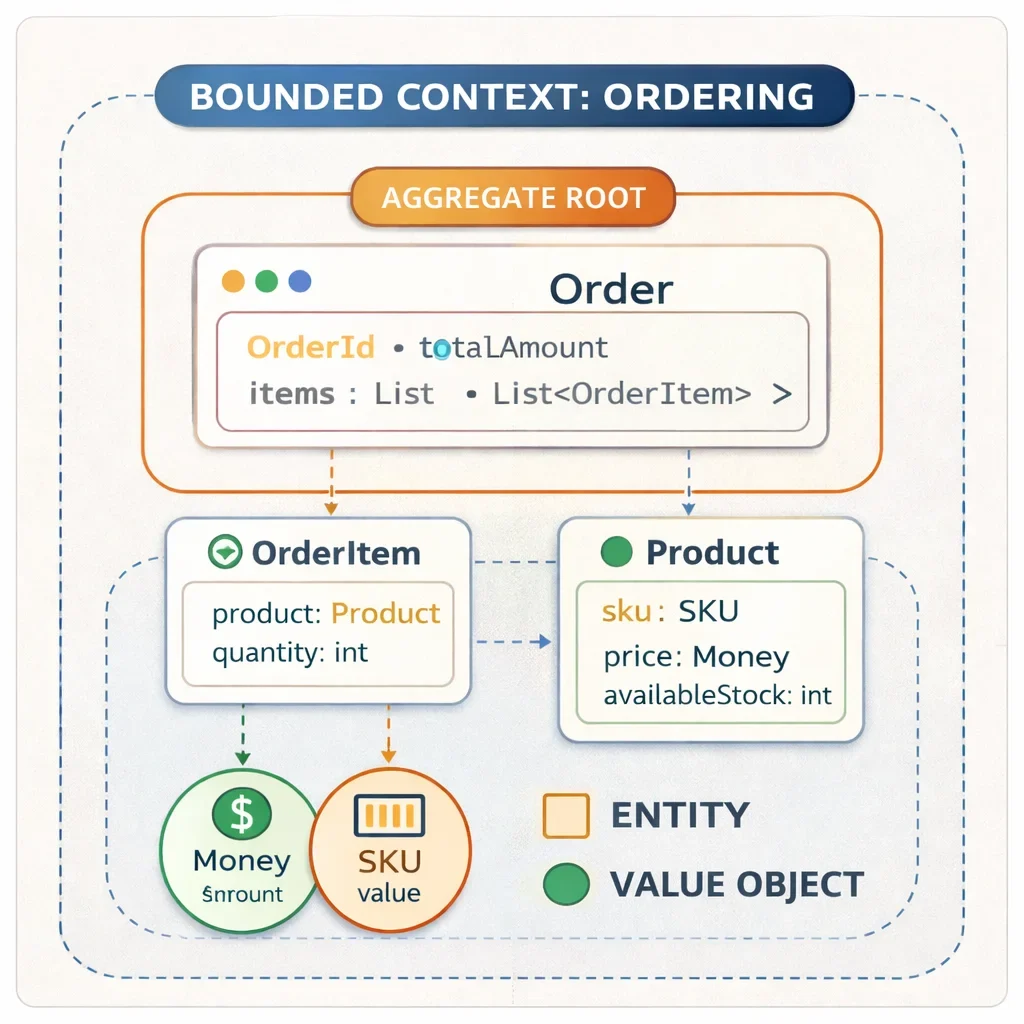
值对象与实体的核心区别在于身份标识与生命周期管理。实体通过唯一标识区分,关注状态演变;而值对象没有独立身份,其相等性完全由属性值决定,且一旦创建便不可变。在建模时,应避免直接使用字符串、浮点数等原始类型,而应将其封装为具备业务语义的值对象。例如,将“金额”封装为包含数值与币种的值对象,并在内部实现加减运算与精度校验,避免浮点数计算误差;将“地址”封装为包含省市区、街道、邮编的组合对象,提供格式化输出与合法性验证方法;将“时间范围”封装为包含起止时间的对象,内置重叠检测与时长计算逻辑。值对象的设计不仅提升了代码的可读性,还将分散在应用层的校验逻辑收敛至领域层。在实际编码中,可通过构造函数强制校验、提供工厂方法创建实例,并重写相等性判断方法确保基于值的比较。这种设计使得领域模型更贴近业务语言,同时天然具备线程安全性。
落地建模:从业务场景推导聚合内部结构
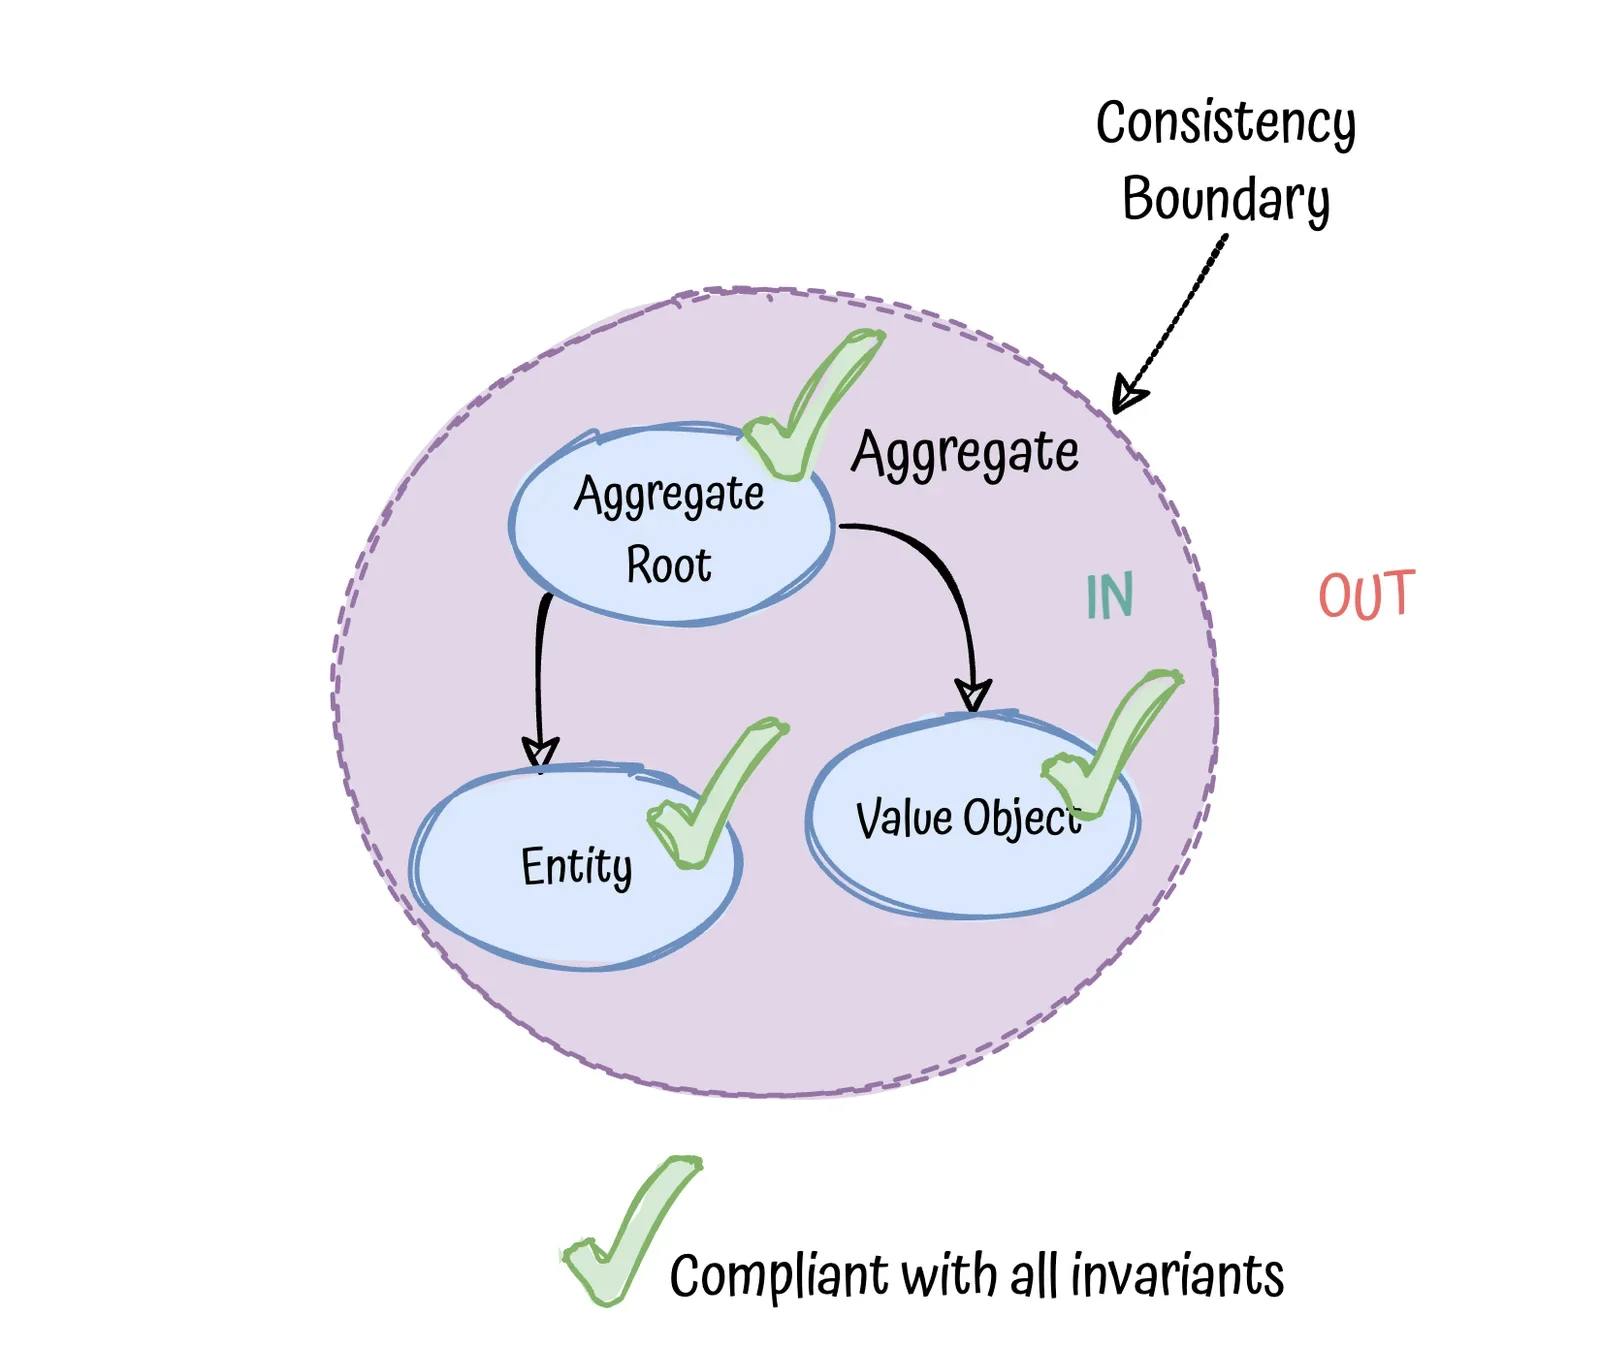
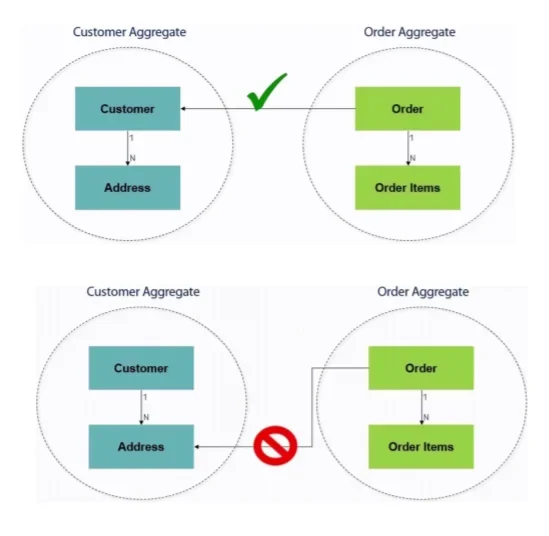
落地建模需遵循“场景驱动、规则收敛”的原则。以支付场景为例,首先梳理“用户发起支付”用例,识别出核心业务规则:支付单状态流转必须严格遵循“待支付→处理中→成功或失败”,且同一订单不可重复支付。基于此,将“支付单”确立为聚合根,负责维护状态机与幂等校验;将“支付渠道配置”与“交易流水”作为内部实体,记录渠道参数与第三方交互明细;将“金额”“时间戳”“渠道编码”抽象为值对象。聚合内部的行为组织应遵循高内聚原则,所有状态变更必须通过聚合根暴露的方法触发,例如支付方法内部会校验当前状态、扣减金额并生成流水记录,而非由外部直接修改字段。外部系统严禁绕过聚合根直接操作内部实体或值对象,因为聚合根是维护聚合内不变性的唯一守门人。若允许跨边界直接修改,将导致业务规则碎片化、数据状态不一致,最终破坏领域模型的完整性与可维护性。
验证与避坑:检查聚合边界和模型质量
模型设计完成后,需通过可执行的验证清单进行质量审查。首先检查一致性边界:聚合内的强规则是否仅由聚合根保护?事务边界是否严格对齐聚合边界,避免跨聚合长事务?其次评估聚合规模:单个聚合包含的实体与值对象是否过多?若超过合理阈值,应考虑拆分或引入最终一致性。同时排查贫血值对象:值对象是否仅作为数据容器而缺乏业务行为?若存在,需将校验与计算逻辑内聚至值对象内部。常见反模式需重点规避:一是数据库表驱动建模,即直接按表结构生成实体,导致领域逻辑泄漏至基础设施层;二是万能聚合根,将大量无关业务塞入单一聚合,引发严重的锁竞争与性能瓶颈;三是跨聚合直接修改,如通过外键或共享标识绕过聚合根更新关联数据,破坏封装性。通过定期执行上述检查,可确保领域模型持续贴合业务演进,保持架构的清晰与健壮。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















