


Kubernetes部署:滚动更新与回滚历史

理解 Deployment 滚动更新机制
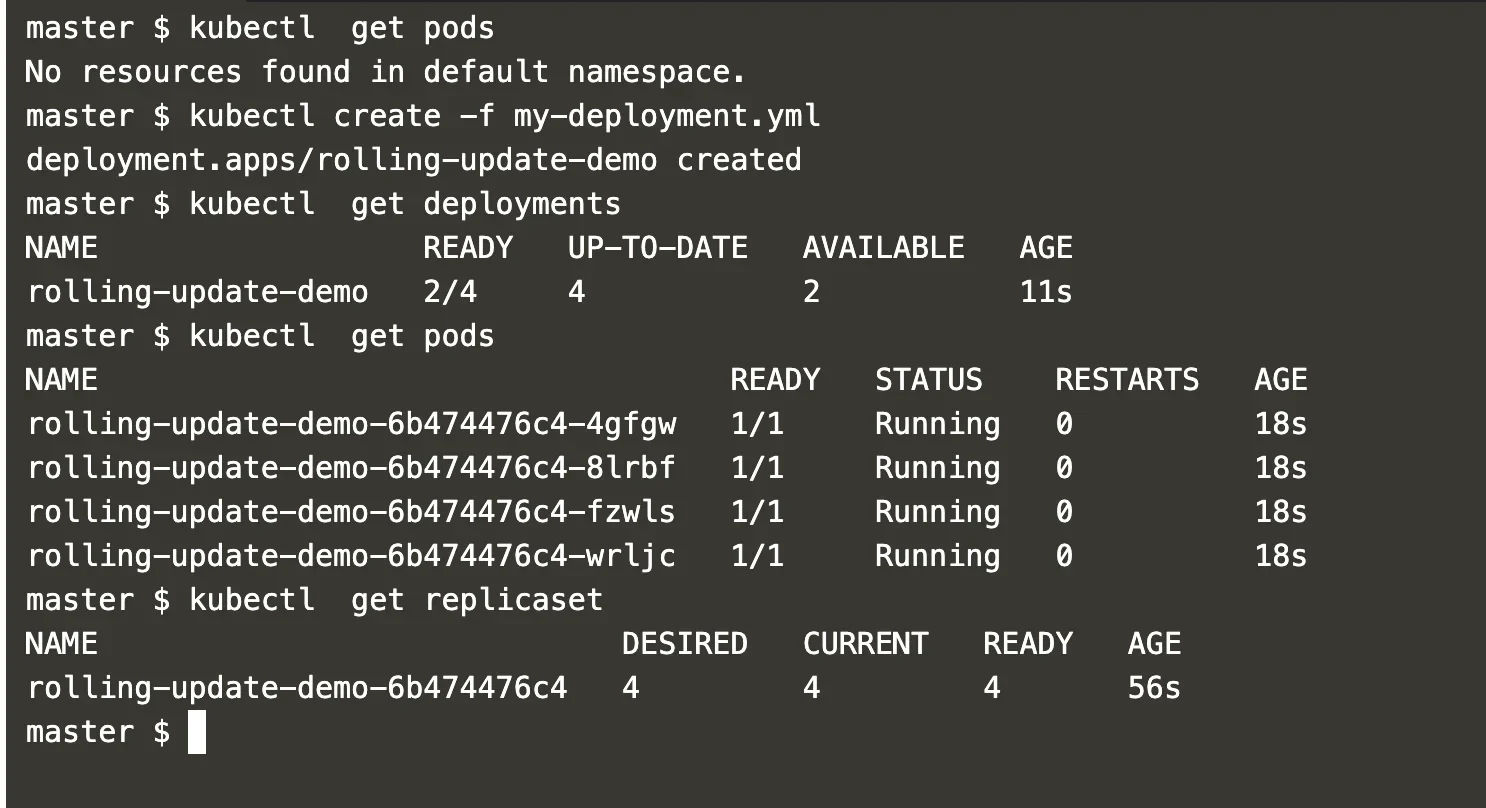
Kubernetes 的 Deployment 控制器默认采用 RollingUpdate(滚动更新)策略来管理应用发布。该机制的核心在于逐步替换旧版本 Pod,而非一次性销毁重建,从而有效降低更新期间的服务中断风险。在底层架构中,Deployment 并不直接管理 Pod,而是通过创建和管理 ReplicaSet 来实现。每当修改 Deployment 的 Pod 模板(如更新容器镜像、环境变量或资源限制),控制器会生成一个新的 ReplicaSet,并为其分配一个递增的 Revision 版本号。此时,Deployment 会逐步将旧 ReplicaSet 的副本数缩容至 0,同时将新 ReplicaSet 扩容至目标值。需要注意的是,仅执行扩缩容操作(修改 replicas 字段)不会触发新 ReplicaSet 的创建,也不会产生新的 Revision,因为 Pod 模板并未发生实质性变更。理解这一映射关系是掌握平滑发布与故障恢复的基础。
执行一次滚动更新并监控上线状态
在实际发布流程中,触发滚动更新通常有两种方式:一是直接修改 YAML 文件中的镜像版本并执行 kubectl apply -f deployment.yaml;二是使用快捷命令 kubectl set image deployment/<name> <container-name>=<new-image>。更新启动后,可通过 kubectl rollout status deployment/<name> 实时观察进度。该命令会阻塞等待,直到所有新 Pod 进入 Ready 状态且旧 Pod 完全终止。更新节奏由 strategy.rollingUpdate 下的 maxSurge 和 maxUnavailable 参数控制:maxSurge 决定更新过程中允许超出期望副本数的最大 Pod 数量,maxUnavailable 则限制不可用 Pod 的上限。例如,当期望副本为 3,maxSurge=1 且 maxUnavailable=0 时,系统会先创建 1 个新 Pod,待其就绪后再销毁 1 个旧 Pod,全程保持服务可用。通过 kubectl get pods -w 可直观看到新旧 Pod 交替创建与销毁的过程,直至 Deployment 的 AVAILABLE 列与期望值一致,即标志着更新完成。
查看回滚历史并定位目标 Revision
当需要追溯发布记录或准备回滚时,kubectl rollout history deployment/<name> 是首要工具。该命令会列出该 Deployment 关联的所有历史 Revision 及其对应的 CHANGE-CAUSE。CHANGE-CAUSE 字段实际上读取的是 Deployment 资源上的 kubernetes.io/change-cause 注解。若在执行 kubectl apply 或 kubectl set image 时通过 --record 参数或手动添加该注解,即可在历史记录中清晰标注每次变更的具体命令或原因。需要明确的是,Kubernetes 并不会将历史配置单独存储在 Deployment 对象中,而是完整保留在由 Deployment 管理的旧 ReplicaSet 资源里。每个 ReplicaSet 的标签选择器中都会包含 pod-template-hash,且其元数据中记录了所属的 Revision 编号。通过执行 kubectl rollout history deployment/<name> --revision=<N>,可以查看指定版本完整的 Pod 模板配置,包括镜像、环境变量、探针等,从而精准定位需要恢复的目标状态。
执行回滚并验证恢复结果
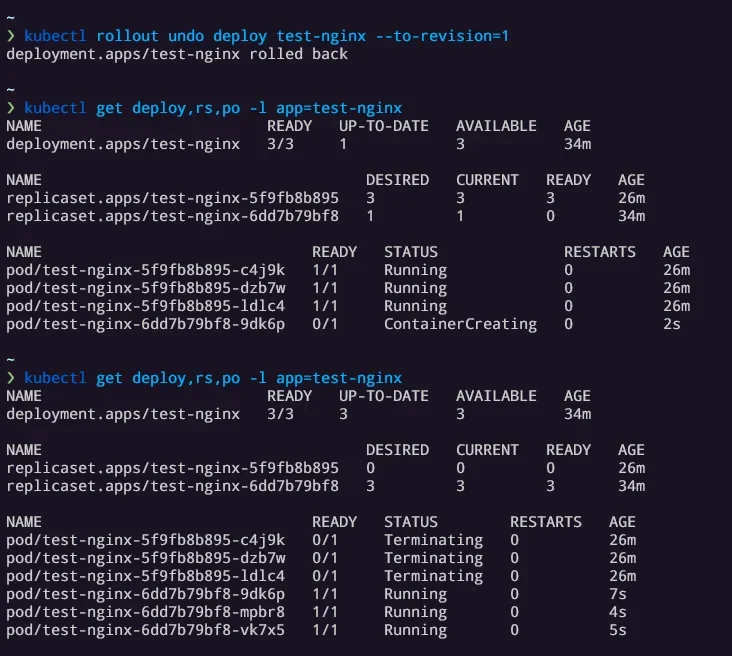
确认目标版本后,可执行 kubectl rollout undo deployment/<name> 快速回滚至上一个 Revision,或使用 kubectl rollout undo deployment/<name> --to-revision=<N> 精确回退至指定历史版本。回滚操作的本质并非“撤销”某次 API 调用,而是将目标 Revision 对应的 Pod 模板重新应用到 Deployment 中,从而触发一次反向的滚动更新流程:旧版本 ReplicaSet 重新扩容,当前异常版本的 ReplicaSet 逐步缩容。执行回滚后,务必通过 kubectl rollout status deployment/<name> 确认新(旧)Pod 已完全就绪。同时,应结合 kubectl get pods 检查 Pod 的 READY 状态是否为 1/1,并观察 kubectl describe deployment/<name> 中的 Events 字段,确认无镜像拉取失败或调度异常。最终,必须通过应用自身的健康检查接口或业务日志验证服务是否真正恢复,避免仅凭 Kubernetes 层面的 Pod Running 状态误判业务可用性。
历史保留与常见避坑
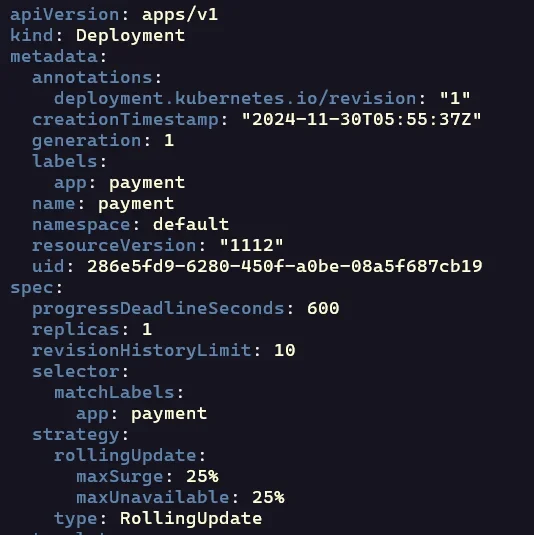
Kubernetes 默认通过 revisionHistoryLimit 字段保留最近 10 个旧 ReplicaSet,以便随时回滚。若将该值显式设置为 0,控制器将在更新完成后立即清理所有历史 ReplicaSet,导致彻底丧失回滚能力,生产环境中应谨慎配置。此外,回滚操作仅针对 Pod 模板部分生效,Deployment 的 replicas、selector 或 strategy 等非模板字段不会随回滚自动还原,需手动核对。在实际发布中,常见陷阱包括:未配置就绪探针(readinessProbe)导致流量过早打入未初始化容器;镜像拉取策略不当引发 ImagePullBackOff 阻塞滚动;以及频繁使用无意义的标签或注释覆盖 CHANGE-CAUSE,造成历史记录混乱难以定位。建议在每次发布前通过 kubectl diff 预览变更,发布后严格验证探针状态与业务指标,并定期归档关键版本的 YAML 快照,以构建安全可控的发布流水线。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















