


Kubernetes HPA:自定义指标与Prometheus适配器

理解 HPA 自定义指标链路:从 Prometheus 到 custom.metrics.k8s.io
Kubernetes 原生 HPA 控制器默认仅能读取 metrics.k8s.io 提供的核心资源指标(如 CPU、内存),无法直接对接 Prometheus。这是因为 Kubernetes 采用 API 聚合层(Aggregation Layer)架构,外部数据源必须通过 APIService 注册为独立的 API 组。Prometheus Adapter 正是扮演这一桥梁角色:它定期向 Prometheus 发起 PromQL 查询,将结果转换为符合 Kubernetes 自定义指标 API 规范的 JSON 格式,并挂载到 custom.metrics.k8s.io 路径下。HPA Controller 随后通过该 API 获取数据并计算目标副本数。在实际架构中,需严格区分三类指标:metrics.k8s.io 仅用于核心资源指标;custom.metrics.k8s.io 用于绑定到具体 K8s 对象(如 Pod、Deployment)的业务指标(如 QPS、延迟);external.metrics.k8s.io 则用于与集群对象无直接绑定的全局指标(如消息队列积压量)。理解这一数据流向与分类,是构建可靠弹性伸缩链路的前提。
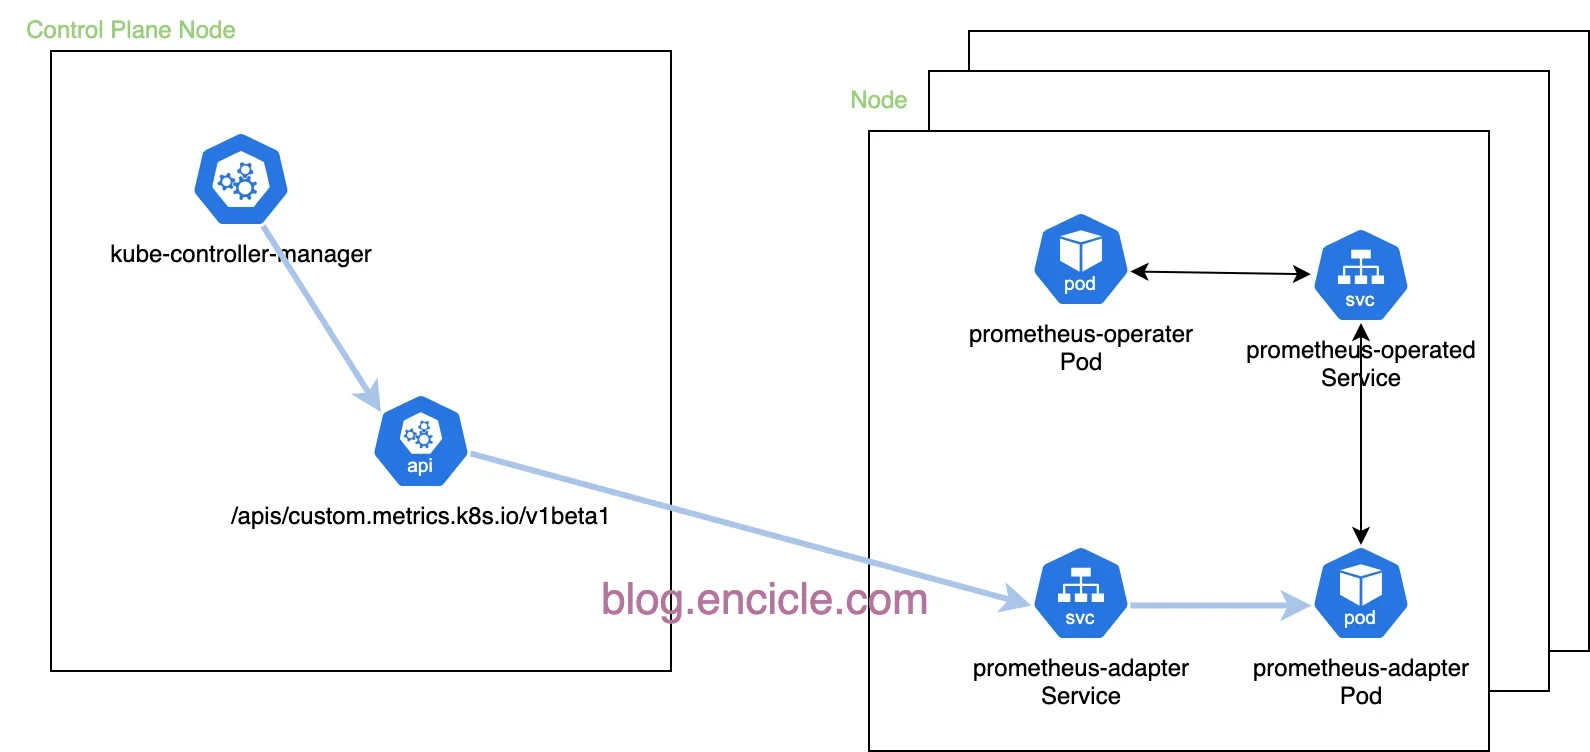
部署 Prometheus Adapter 并配置指标映射规则
部署 Prometheus Adapter 推荐使用 Helm 包管理器,通过 helm install prometheus-adapter prometheus-community/prometheus-adapter 快速拉起。核心配置位于 values.yaml 的 prometheus.url 与 rules.custom 字段。以业务 QPS 为例,seriesQuery 负责在 Prometheus 中按正则发现指标序列(如 http_requests_total);resources 定义指标与 K8s 资源的关联维度(通常配置 overrides 将 namespace 和 pod 标签映射为 K8s 原生资源);name 指定暴露给 API 的指标名称;metricsQuery 则是实际执行的 PromQL,需使用 <<.LabelMatchers>> 占位符接收 HPA 传入的过滤条件。强烈建议显式编写 custom 规则而非依赖默认发现,因为默认规则往往无法正确处理复杂标签或聚合逻辑。例如,若业务指标携带 service="api" 标签,需在 metricsQuery 中通过 sum by (<<.GroupBy>>) (rate(http_requests_total{<<.LabelMatchers>>, service="api"}[5m])) 确保按 Pod 维度正确聚合,避免数据错位。
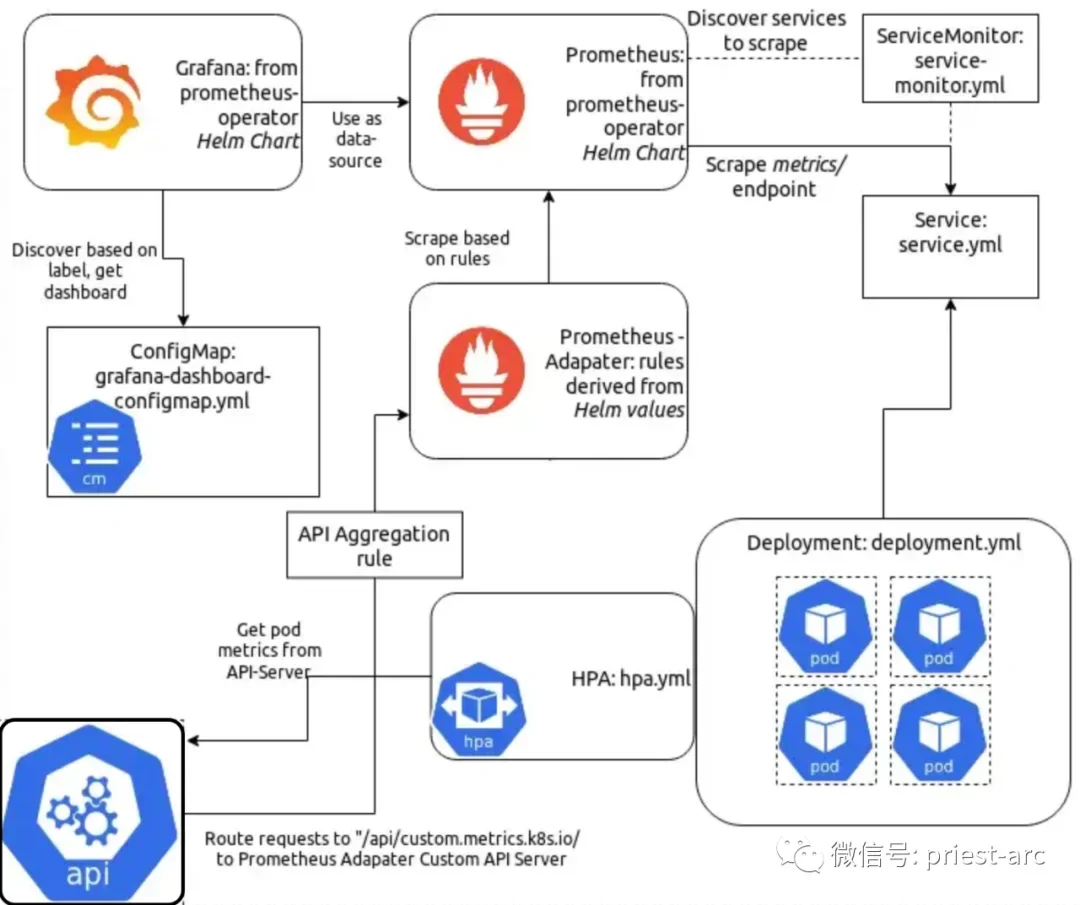
配置 HPA 使用自定义指标,并验证扩缩容闭环
配置 HPA 需使用 autoscaling/v2 API 版本,在 metrics 数组中声明 type: Pods 并指定自定义指标。关键字段包括 metric.name(对应 Adapter 暴露的名称)、target.type: AverageValue 以及 averageValue(如 100 表示单 Pod 平均 QPS 达 100 时触发扩容)。部署后,可通过 kubectl get --raw "/apis/custom.metrics.k8s.io/v1beta1/namespaces/default/pods/*/http_requests_per_second" | jq 直接验证 API 是否返回有效数值。为验证闭环,可使用 hey -n 10000 -c 50 http://<service-ip> 模拟突发流量。观察 kubectl get hpa 的 TARGETS 列是否从 0/100 逐步上升,随后 kubectl get deploy 的 READY 副本数是否按预期增加。整个过程中,Adapter 的 metrics-relist-interval(默认 1 分钟)与 HPA 的同步周期共同决定了扩缩容的响应延迟,需结合业务容忍度合理评估。

排查指标不显示、数值异常与 HPA 不扩容
自定义指标链路故障排查需遵循“自底向上”原则。首先确认 Prometheus 中 http_requests_total 是否存在且带 namespace/pod 标签;若 Adapter 日志报 no metrics found,通常因 seriesQuery 正则未匹配或标签未正确映射。其次检查 APIService 状态:kubectl get apiservice v1beta1.custom.metrics.k8s.io 若显示 False,说明 Adapter 未成功注册或证书过期。若 API 有值但 HPA 显示 <unknown>,多为 metrics-relist-interval 远大于 Prometheus scrape_interval 导致数据断档。此外,Kubernetes 数量单位易引发误解:averageValue: 100m 实际代表 0.1,若业务期望阈值为 100,应直接写 100 而非 100m。最后,若 metricsQuery 中遗漏 <<.GroupBy>> 或聚合函数错误,会导致多 Pod 指标被错误累加,触发异常扩容。逐层核对查询结果、Adapter 日志与 HPA 事件,可快速定位根因。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















