


Kubernetes资源限制:requests与limits设置

理解requests与limits:调度与运行时限制的区别
在Kubernetes中,requests与limits是控制容器资源使用的核心字段,但二者作用阶段截然不同。requests主要用于调度阶段,Kube-Scheduler会依据该值在节点上预留对应资源,确保Pod能被分配到具备充足可用容量的节点。若未设置requests,调度器将默认按0处理,极易导致节点超卖,引发节点整体资源耗尽;设置过高则会造成节点碎片化,降低集群调度成功率。limits则作用于容器运行时,由cgroups强制执行,限制容器实际可使用的CPU与内存上限。CPU limits通过CFS配额实现时间片分配,内存limits则直接划定物理内存边界。若limits设置过低,应用在高负载时会被强制限流或触发OOM;设置过高则失去保护意义,可能拖垮同节点其他工作负载。合理区分二者,是保障集群稳定与高效调度的前提。
requests与limits怎么设置:从业务负载到YAML配置
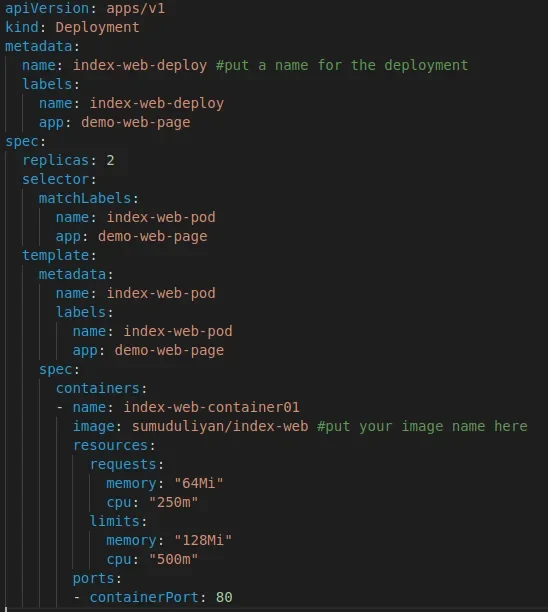
配置requests与limits需结合业务实际负载特征与节点容量进行科学测算。在YAML中,资源声明位于spec.containers[].resources下,CPU单位通常为m(毫核),内存单位为Mi或Gi。推荐设置思路为:先通过压测或历史监控获取应用基线与峰值,requests建议贴近基线值以保障调度成功率,limits则参考峰值并预留缓冲。例如某微服务日常CPU使用约200m,内存约512Mi,突发峰值可达400m与800Mi,可配置requests为cpu:200m、memory:512Mi,limits为cpu:500m、memory:1Gi。以下为标准Deployment配置示例:apiVersion: apps/v1
kind: Deployment
metadata:
name: web-app
spec:
template:
spec:
containers:
- name: nginx
image: nginx:1.24
resources:
requests:
cpu: "250m"
memory: "256Mi"
limits:
cpu: "500m"
memory: "512Mi"
实际部署时需确保单节点总requests不超过节点可分配容量,避免调度失败。
验证资源配置:查看Pod实际使用量与调度结果
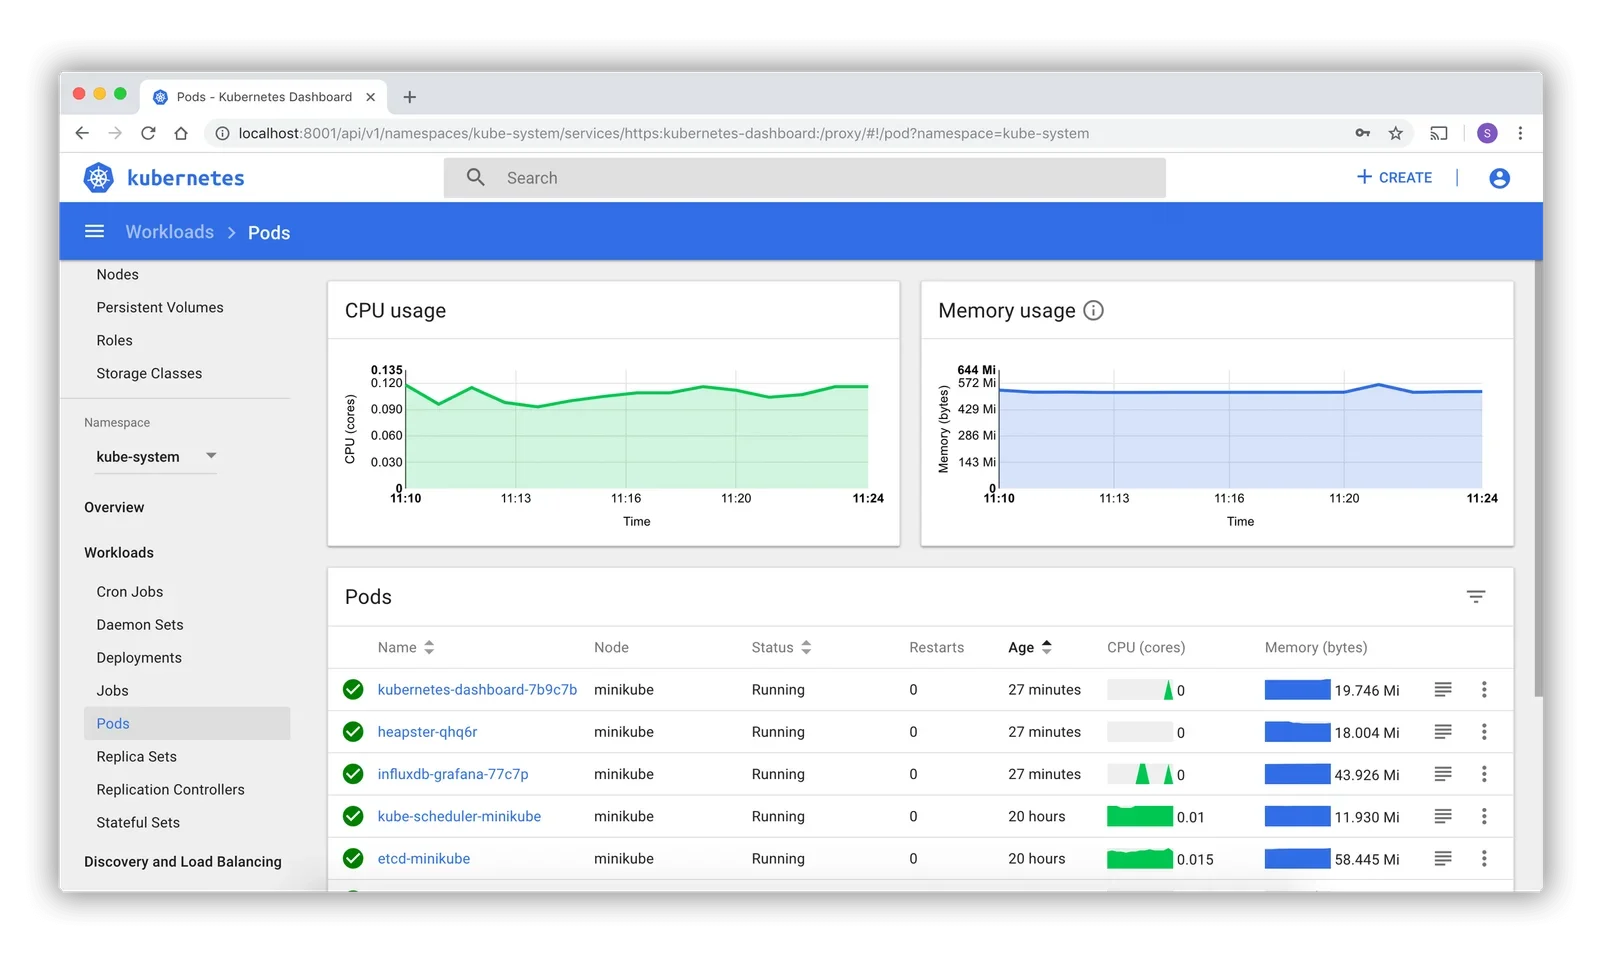
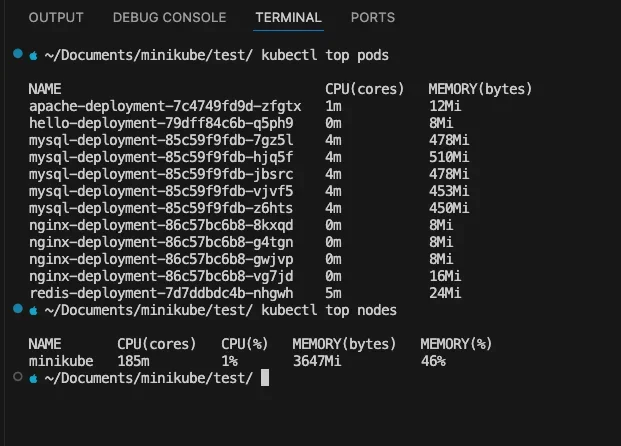
配置生效后,必须通过标准工具验证资源是否按预期分配与使用。首先使用kubectl describe pod命令查看调度结果,在Events区域可确认调度器是否成功匹配节点,并在Containers详情中核对Requested与Limit字段是否与YAML一致。若Pod处于Pending状态,通常意味着集群无节点满足requests要求。运行时监控推荐使用kubectl top pods,该命令依赖Metrics Server,可实时展示各Pod的CPU与内存实际消耗。若发现实际使用量长期低于requests的50%,说明资源预留过度,可逐步下调requests以提升节点装箱率;若实际使用频繁触及limits,则需评估扩容或优化代码。结合Prometheus等监控面板绘制资源趋势图,通过观察P99延迟与资源水位的相关性进行精细化调优,验证与调整应遵循小步快跑原则。
常见避坑:OOMKilled、CPU限流与资源浪费
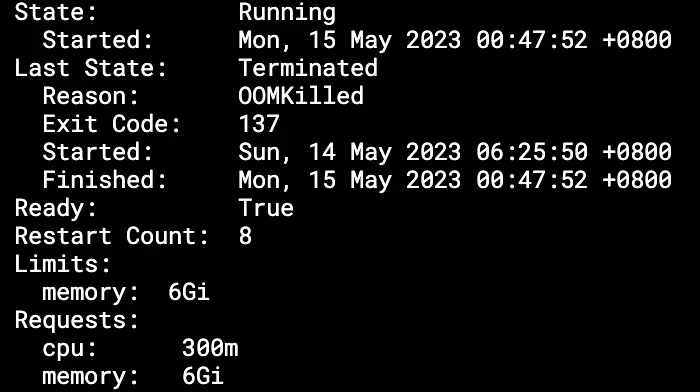
资源配置不当是生产环境故障的高发区。最典型的是内存limits设置过低,当容器内存使用突破硬限制时,Linux内核会触发OOM Killer直接终止进程,Pod状态显示为OOMKilled,重启后可能陷入反复崩溃循环。排查时需检查应用是否存在内存泄漏或JVM堆配置未适配容器限制。其次是CPU limits过低引发的节流,Kubernetes通过CFS周期限制CPU时间片,当应用突发计算需求超过配额时会被强制挂起,表现为接口延迟飙升但CPU使用率显示不高,可通过查看cgroup的cpu.stat中throttled_time指标确认。此外,requests设置过高会导致节点可分配资源迅速耗尽,新Pod长期处于Pending;而requests与limits比例严重失衡会破坏集群调度公平性。应对策略包括为有状态服务设置合理内存limits并配合探针,对计算密集型应用采用1:1或1:2比例,并定期清理僵尸配置。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















