


Python pandas筛选CSV指定行并保存的新手教程

本文详细介绍如何使用Python的pandas库读取CSV文件,通过指定列条件筛选特定数据行,并将结果保存为新的CSV文件。教程涵盖从导入库、读取文件、处理DataFrame结构到执行筛选逻辑及导出文件的完整步骤,适合初学者参考。
pandas筛选CSV文件入门教程
这个操作在现在看来可能并不复杂,但在查找相关资料时确实花费了不少时间。
许多技术文章直接指向pandas官方文档,并仅展示基础示例,缺乏针对具体筛选场景的详细指导。
官方文档地址:https://pandas.pydata.org/docs/reference/index.html
导入库与读取文件
第一步,导入pandas库。
import pandas as pd
接着,使用read_csv函数打开目标CSV文件。
df = pd.read_csv('./IP2LOCATION.csv',encoding= 'utf-8')
该函数需要指定CSV文件的路径。若文件位于Python工程目录下,直接使用./文件名即可。同时,建议指定encoding='utf-8'以使用UTF-8编码,若文件编码不同,可能需要调整为gbk等其他编码格式。
虽然读取的是CSV文件,但由于使用了pandas库,实际获取的数据结构是一个DataFrame。
可以通过执行print(type(df))来验证数据类型。
print(type(df))
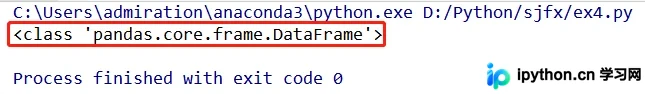
DataFrame是一种表格型数据结构,可以将其视为电子表格。它以表格形式展示数据,并包含行标签和列标签。
可以通过pandas.DataFrame.columns属性来添加或修改列标签。
在示例中,DataFrame变量名为df,因此使用df.columns进行设置。我们将列标签依次设置为a、b、c、d、e、f。
df.columns = ['a','b','c','d','e','f']
执行数据筛选与保存
接下来,目标是从某一列中提取等于特定值的所有行。
可以将读取的内容视为列表,其中每个元素代表表中一行数据,而每一行本身也是一个列表结构。
例如,若要提取第5列中值为'Andhra Pradesh'的行,且已知第5列的标签为'e'。
对应的代码实现如下。
data = df[df['e'] == 'Andhra Pradesh']
最后,利用pandas库中的to_csv方法,将筛选后的数据保存至新的CSV文件。
data.to_csv('my_IP2LOCATION.csv')
调用格式为:表名.to_csv('保存路径/新文件名.csv')。
以下是完整代码的总结。
import pandas as pd

df = pd.read_csv('./IP2LOCATION.csv',encoding= 'utf-8')
# print(type(df))
df.columns = ['a','b','c','d','e','f']
data = df[df['e'] == 'Andhra Pradesh']
data.to_csv('my_IP2LOCATION.csv')
原始文件IP2LOCATION.csv的内容结构如下。
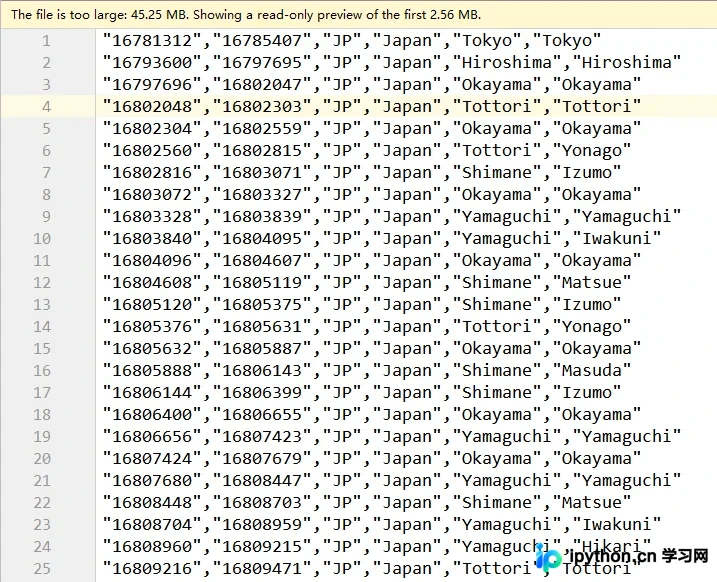
该文件总共有759727行数据。
经过筛选处理后,生成的文件my_IP2LOCATION.csv。
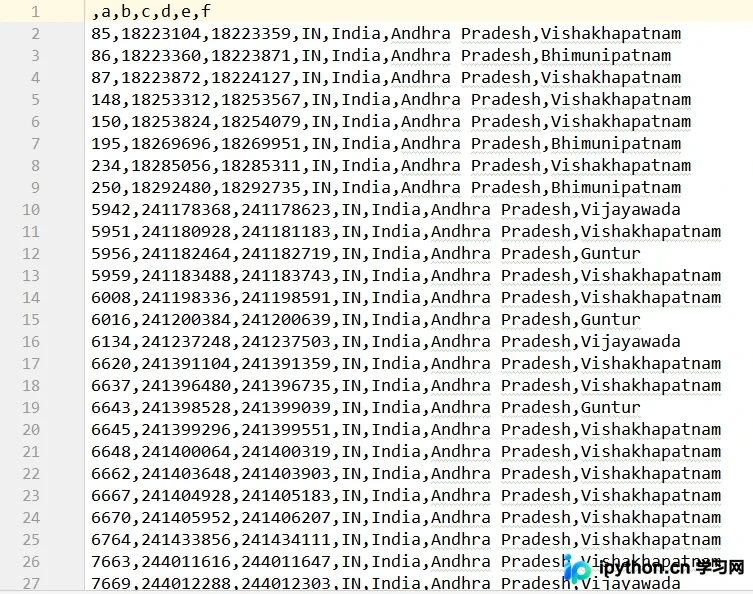
筛选后的结果仅包含3461行。
提示:可以使用print(len(df.values))来查看当前DataFrame的行数。
以上即为本文的全部内容,希望对您的学习有所帮助,欢迎继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















