


Python爬虫中URL参数GBK2312编码处理解析

发布时间:2026-10-14 |
5人浏览过
本文解析Python爬虫抓取网站时遇到的URL参数乱码问题。通过示例展示如何将中文字符串按GBK2312编码后进行百分号编码,利用urllib.quote函数生成符合要求的URL参数格式,帮助开发者解决中文请求参数乱码困扰。
URL参数乱码现象分析
在抓取特定网站数据时,可能会遇到请求参数显示为乱码的情况。
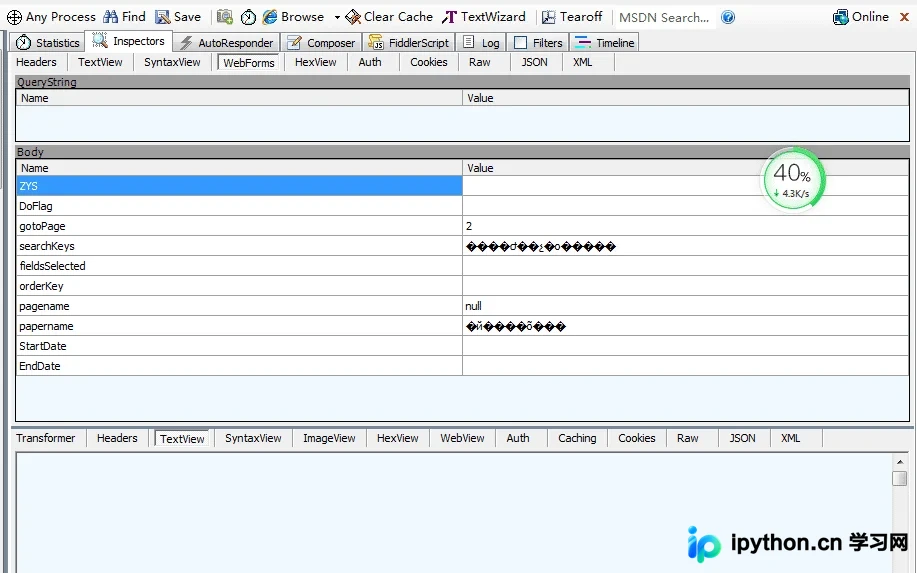
观察点击操作后的请求参数,其格式如下所示。
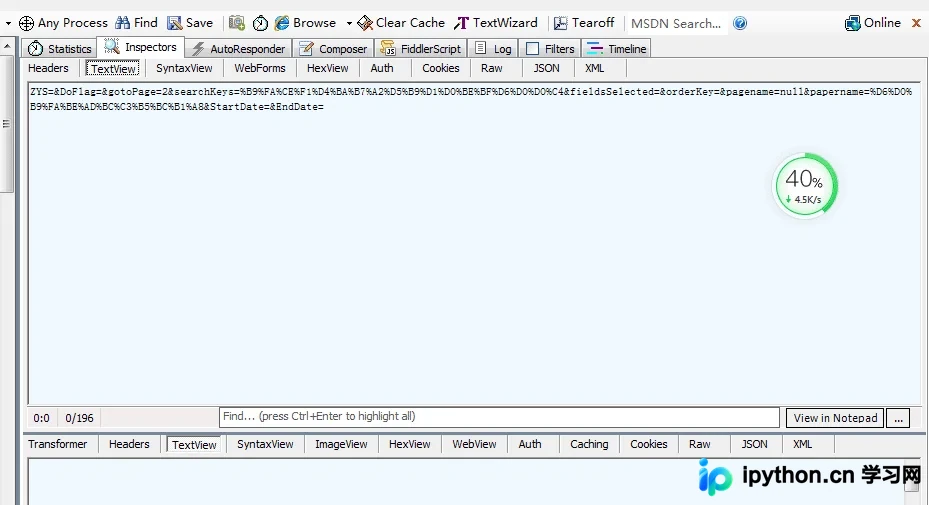
那么,形如=%B9%FA%CE%F1%D4%BA%B7%A2%D5%B9%D1%D0%BE%BF%D6%D0%D0%C4这样的字符串具体代表什么含义呢?
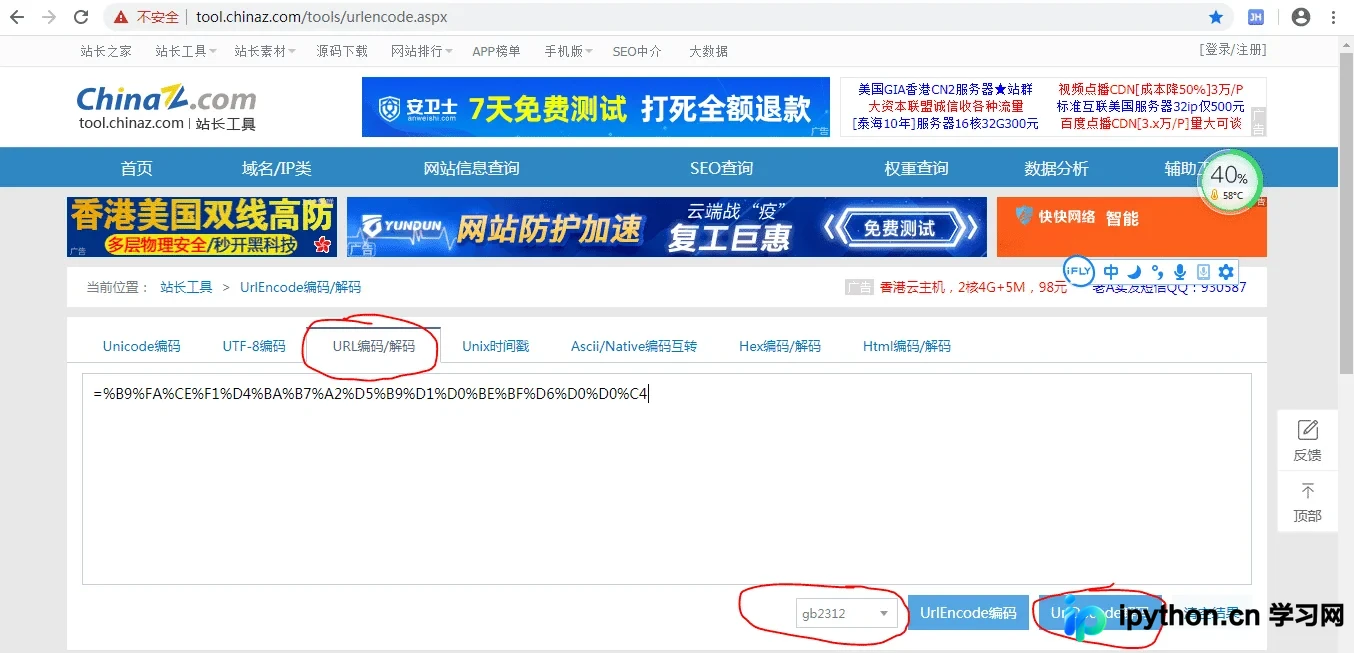
对该字符串进行解码后,可识别出原始内容为“国务院发展研究中心”。
Python编码实现方法
具体代码实现如下所示。
content = "我爱中国"
import urllib
res = urllib.quote(content.encode('gb2312'))
print res
print "11111111", type(res)
以上内容为本文的全部分享,希望能为各位的学习提供有益参考,同时也欢迎大家继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















